
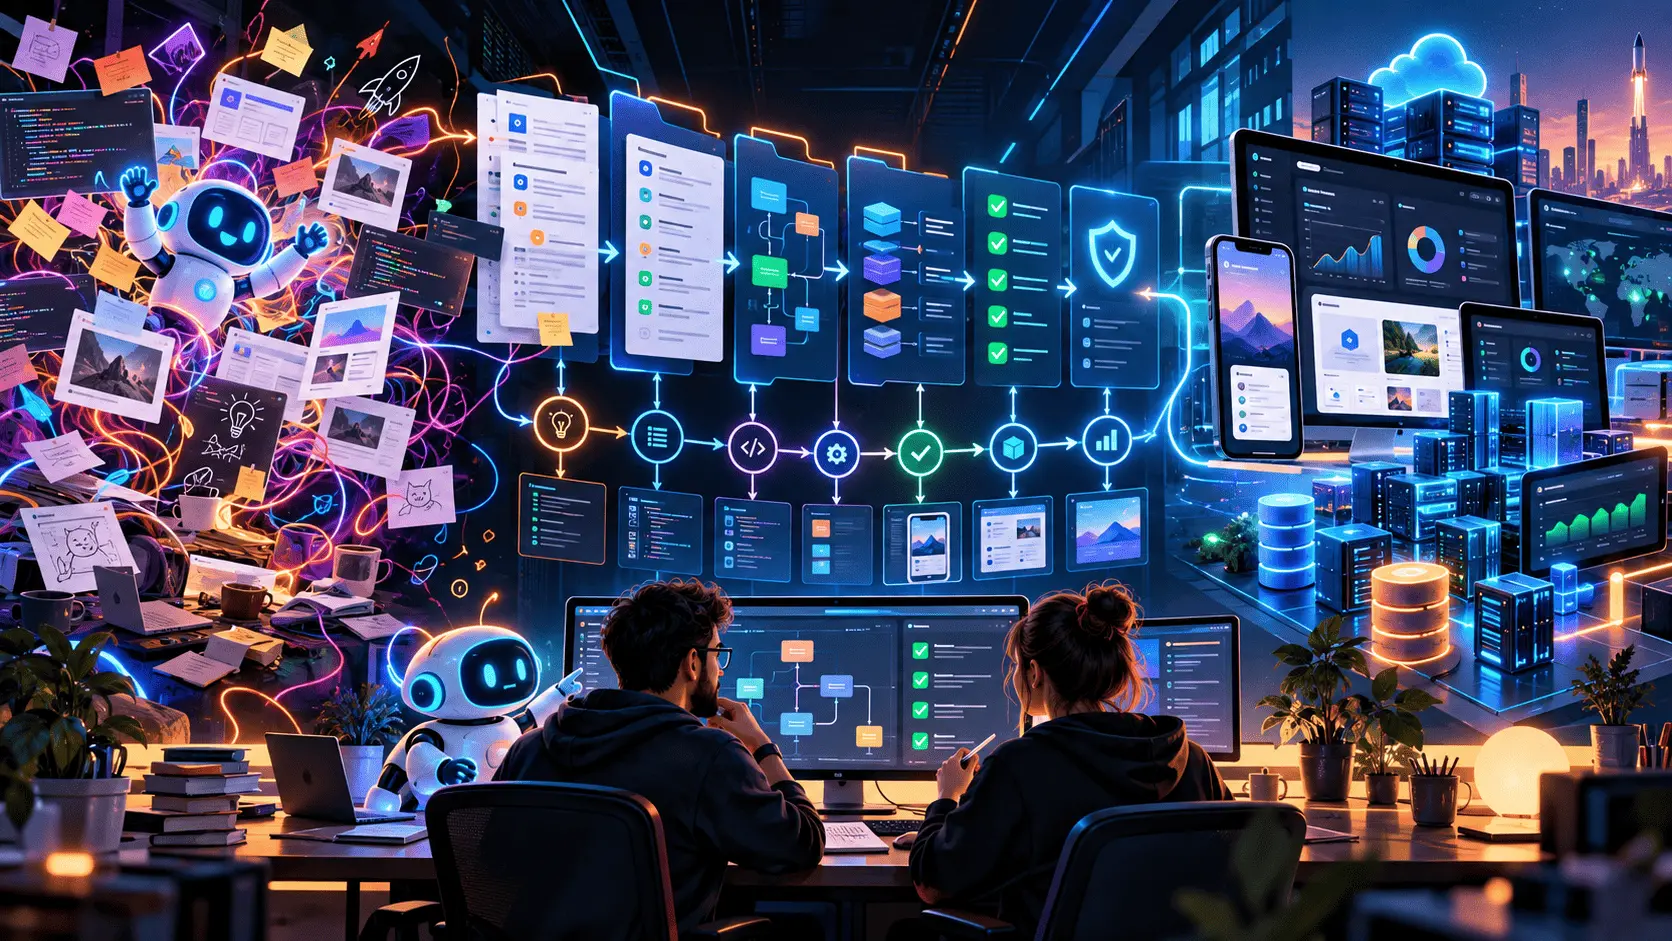
บทความนี้สรุปมาจากเลกเชอร์ “จากไวบ์โค้ดดิ้งสู่งานวิศวกรรม”
ไวบ์โค้ดดิ้งเป็นเครื่องมือที่ทรงพลังได้ ถ้าใช้ AI เอเจนต์ไม่ใช่ในฐานะปุ่มวิเศษ “สร้างแอปให้หน่อย” แต่ในฐานะผู้ช่วยที่อยู่ในกระบวนการทางวิศวกรรมที่เป็นระบบ
ความผิดพลาดหลักคือสั่งให้ AI เขียนโค้ดทันที โค้ดเป็นแค่ขั้นหนึ่งของการพัฒนา ก่อนหน้านั้นต้องมีไอเดีย requirement สถาปัตยกรรม และแผน หลังจากนั้นคือการตรวจสอบ ความปลอดภัย การปรับปรุง การปล่อยเวอร์ชัน และการดูแลต่อ
แนวทางเชิงวิศวกรรมกับไวบ์โค้ดดิ้งตั้งอยู่บนตรรกะง่าย ๆ: เข้าใจก่อนว่าเรากำลังทำอะไร แล้วเขียนอธิบายมันออกมา จากนั้นแตกเป็นชิ้นเล็ก ๆ ที่ควบคุมได้ พาแต่ละชิ้นผ่านวงจรชีวิตที่ชัดเจน และหลังจากนั้นเท่านั้นถึงจะนับว่างานเสร็จ
ด้านล่างคือรายการกฎที่ช่วยให้สร้างโปรดักต์ด้วย AI ได้อย่างรู้ตัว ปลอดภัย และควบคุมได้มากขึ้น
1. อย่าเริ่มจากโค้ด แต่เริ่มจากโจทย์ของโปรดักต์
ก่อนจะสั่งให้ AI เขียนโค้ด ต้องเข้าใจก่อนว่าเรากำลังสร้างอะไร ให้ใคร และแก้ปัญหาอะไร
แบบที่ไม่ดี:
“ทำ CRM ให้หน่อย”
แบบที่ดี:
“เรากำลังทำ CRM ให้เอเจนซี HR เพื่อให้รีครูตเตอร์เก็บข้อมูลผู้สมัคร เห็นสถานะ เขียนคอมเมนต์ และติดตามประวัติการติดต่อได้”
AI ต้องเข้าใจเป้าหมายของโปรดักต์ ไม่ใช่แค่การกระทำทางเทคนิค
2. รวบรวม requirement ก่อน
ไอเดียโปรดักต์ยังไม่ใช่โจทย์ทางเทคนิค ต้องอธิบายผู้ใช้ สถานการณ์การใช้งาน ข้อจำกัด และเกณฑ์ความสำเร็จ
ตัวอย่าง:
ถ้าเราทำฟอร์มสมัคร ต้องกำหนดไว้ล่วงหน้าว่า:
มีช่องอะไรบ้าง
ช่องไหนบังคับกรอก
ข้อมูลถูกส่งไปที่ไหน
ผู้ใช้เห็นอะไรหลังกดส่ง
เกิดอะไรขึ้นเมื่อมีข้อผิดพลาด
ข้อมูลแบบไหนห้ามรับ
ถ้าไม่มี requirement AI จะเดาเติมเอง
3. บันทึก requirement ไว้ในเอกสาร
อย่าเก็บ requirement ไว้แค่ในหัวหรือในแชท AI อาจลืมบริบท ปะติดปะต่อมันผิด หรือเริ่มขัดแย้งกับการตัดสินใจก่อนหน้า
ตัวอย่าง:
สร้างไฟล์ PRD.md ที่อธิบาย:
เป้าหมายของโปรดักต์
กลุ่มเป้าหมาย
สถานการณ์การใช้งานหลัก
ฟังก์ชันหลัก
ข้อจำกัด
อะไรอยู่ในเวอร์ชันแรก
อะไรไม่อยู่ในเวอร์ชันแรก
เอกสารแบบนี้จะกลายเป็นแหล่งความจริงเดียวสำหรับคุณและ AI เอเจนต์
4. ใช้แนวทาง spec-driven
แนวทาง spec-driven หมายถึง: สเปกมาก่อน โค้ดตามมาทีหลัง
สเปกคือพิมพ์เขียวของงาน มันอธิบายให้ AI รู้ว่าต้องทำอะไร ควรทำงานยังไง มีข้อจำกัดอะไร และจะรู้ได้ยังไงว่างานเสร็จแล้ว
แบบที่ไม่ดี:
“ทำระบบล็อกอินให้หน่อย”
แบบที่ดี:
“ทำระบบล็อกอินด้วยอีเมลและรหัสผ่าน ต้องมีสมัครสมาชิก เข้าสู่ระบบ ออกจากระบบ และป้องกันหน้าส่วนตัว ส่วน 2FA กู้รหัสผ่าน และล็อกอินผ่าน Google ยังไม่ทำ”
สเปกยิ่งชัด AI ยิ่งเดาน้อยลง
5. อย่าสั่ง AI ให้ทำทั้งแอปในทีเดียว
งานใหญ่ที่ไม่มีขอบเขตแทบจะจบที่ความวุ่นวายเสมอ AI เริ่มตัดสินใจเองมากเกินไป เอาชั้นต่าง ๆ ของระบบมาปนกัน และอาจทำของที่ใช้งานได้อยู่แล้วพัง
แบบที่ไม่ดี:
“ทำมาร์เก็ตเพลสให้หน่อย”
แบบที่ดี:
“ทำ vertical slice แรกก่อน: ผู้ใช้เห็นรายการสินค้า เปิดหน้าสินค้า และเพิ่มสินค้าลงตะกร้า”
ชิ้นเล็ก ๆ ที่เสร็จสมบูรณ์หนึ่งชิ้น ดีกว่าฐานรากขนาดมหึมาที่ทำไม่เสร็จ
6. ทำงานเป็น vertical slice
vertical slice คือฟีเจอร์เล็ก ๆ ที่ทำครบตั้งแต่ต้นจนจบผ่านทุกชั้นของโปรดักต์
ตัวอย่าง:
สำหรับ CRM ตัว vertical slice แรกคือการสร้างผู้สมัคร
ในนั้นประกอบด้วย:
ฟอร์มฝั่งฟรอนต์เอนด์
การตรวจสอบความถูกต้องของข้อมูล (validation)
เมธอด API
การบันทึกลงฐานข้อมูล
ข้อความแจ้งว่าสำเร็จ
การจัดการข้อผิดพลาด
การตรวจผลลัพธ์ขั้นพื้นฐาน
ชิ้นงานแบบนี้เอาไปทดสอบ โชว์ให้ผู้ใช้ดู และปรับปรุงต่อได้
7. อย่าสร้างฐานรากใหญ่โตก่อนพิสูจน์สมมติฐาน
ในช่วง MVP ไม่จำเป็นต้องสร้างสถาปัตยกรรมที่สมบูรณ์แบบสำหรับอีกหลายปีข้างหน้าทันที ต้องเช็กก่อนว่าผู้ใช้ต้องการฟีเจอร์นั้นจริงไหม
ตัวอย่าง:
สำหรับ HR-CRM ไม่จำเป็นต้องทำระบบวิเคราะห์ที่ซับซ้อน ระบบสิทธิ์ตามบทบาท หรือการเชื่อมต่อกับอีเมล ปฏิทิน Telegram และ HH.ru ตั้งแต่แรก
แค่เช็กสถานการณ์พื้นฐานก่อนก็พอ: รีครูตเตอร์เพิ่มผู้สมัคร เปลี่ยนสถานะ และเขียนคอมเมนต์ได้
8. แต่ MVP ก็ไม่ควรเป็นกองขยะที่ยุ่งเหยิง
MVP เรียบง่ายได้ แต่ไม่ควรทำแบบไม่คิด
เร็วไม่ได้แปลว่าไม่มีโครงสร้าง
ตัวอย่าง:
จะไม่ทำโมดูลรายงานที่ซับซ้อนก็ได้ แต่ยังไงก็ต้อง:
เข้าใจโครงสร้างข้อมูล
ไม่เก็บความลับ (secret) ไว้ในโค้ด
ตรวจสอบข้อมูลในฟอร์ม
แยก UI ออกจาก business logic
บันทึกการตัดสินใจด้านสถาปัตยกรรม
ไม่อย่างนั้น ไม่นาน MVP ก็จะกลายเป็นโปรดักต์ที่พัฒนาต่อไม่ได้
9. ทำเอกสารสถาปัตยกรรมก่อนเขียนโค้ด
สถาปัตยกรรมอธิบายว่าระบบประกอบด้วยส่วนไหนบ้าง และส่วนไหนรับผิดชอบอะไร
ตัวอย่างไฟล์ ARCHITECTURE.md:
ฟรอนต์เอนด์: Next.js
แบ็กเอนด์: API routes
ฐานข้อมูล: Supabase
คอมโพเนนต์ UI อยู่ใน /components
สคีมาข้อมูลอยู่ใน /schemas
business logic อยู่ใน /services
โค้ดที่ทำงานกับฐานข้อมูลต้องไม่อยู่ในคอมโพเนนต์ UI
เอกสารแบบนี้ช่วยไม่ให้ AI วางโค้ดมั่วซั่ว
10. แบ่งหน้าที่ของคอมโพเนนต์ให้ชัด
แต่ละส่วนของระบบต้องรับผิดชอบงานของตัวเอง
แบบที่ไม่ดี:
คอมโพเนนต์ React ตัวเดียวทั้งแสดงฟอร์ม ตรวจข้อมูล เช็กสิทธิ์ เรียกฐานข้อมูล และตัดสินกฎทางธุรกิจไปพร้อมกัน
แบบที่ดี:
คอมโพเนนต์ UI แสดงหน้าจอ
schema ตรวจข้อมูล
service เก็บ business logic
API รับผิดชอบการรับส่งข้อมูลระหว่าง client กับ server
database layer รับผิดชอบการทำงานกับฐานข้อมูล
แบบนี้โปรเจกต์จะเข้าใจง่ายกว่า ทดสอบง่ายกว่า และพัฒนาต่อง่ายกว่า
11. อธิบายขอบเขตของสถาปัตยกรรมให้ AI รู้
AI ไม่ควรตัดสินใจเองว่าจะวางโค้ดไว้ตรงไหน และจะแก้ส่วนไหนของโปรเจกต์ ต้องกำหนดขอบเขตให้มันอย่างชัดเจน
ตัวอย่างคำขอ:
“อย่าใส่ business logic ในคอมโพเนนต์ UI ย้าย validation ไปไว้ที่ /schemas/candidate.ts ส่วนงานกับฐานข้อมูลไปไว้ที่ /services/candidates.ts ห้ามแก้ระบบล็อกอินและโครงสร้างฐานข้อมูล”
ขอบเขตยิ่งชัด ของที่พังโดยไม่ตั้งใจก็ยิ่งน้อย
12. ใช้ lifecycle กับทุกฟีเจอร์
ฟีเจอร์ไม่ควรเริ่มและจบแค่การสร้างโค้ด มันต้องมีวงจรชีวิตของตัวเอง
lifecycle ที่ดี:
context check: ทำความเข้าใจบริบท
scope: กำหนดขอบเขตของงาน
plan: วางแผน
components: ระบุส่วนที่ได้รับผลกระทบ
implement: ลงมือทำ
verify: ตรวจสอบ
test: ทดสอบ
review: รีวิว
document: อัปเดตเอกสาร
close: ปิดงาน
ตัวอย่าง:
ก่อนงาน “สร้างหน้าข้อมูลผู้สมัคร” ให้สั่ง AI ว่า:
“เช็กบริบทของโปรเจกต์ก่อน กำหนด scope และเสนอแผน ยังไม่ต้องเขียนโค้ด”
13. อย่าให้ AI เขียนโค้ดก่อนมีแผน
ถ้า AI พุ่งไปเขียนโค้ดทันที มันอาจแก้โจทย์ผิด มันต้องแสดงให้เห็นก่อนว่าเข้าใจโจทย์แล้ว
ตัวอย่าง prompt:
“วางแผนการพัฒนาก่อน ระบุว่าจะแก้ไฟล์ไหนและเพราะอะไร จากนั้นหยุดแล้วรอการยืนยัน ยังไม่ต้องเขียนโค้ด”
วิธีนี้ช่วยเลี่ยงสถานการณ์ที่เอเจนต์ไปเขียนใหม่เกินจำเป็น หรือหลงทางไปผิดทิศ
14. ใช้ Definition of Done
Definition of Done คือรายการเงื่อนไขที่ต้องครบ งานถึงจะนับว่าเสร็จ
ถ้าไม่มีมัน AI อาจบอกว่า “เสร็จแล้ว” ทั้งที่จริง ๆ ฟีเจอร์ทำงานได้แค่บางส่วน
ตัวอย่าง Definition of Done ของฟอร์มสมัคร:
ฟอร์มแสดงผลได้ทั้งบน desktop และ mobile
ช่องบังคับกรอกถูกตรวจสอบ
อีเมลถูกเช็กว่ารูปแบบถูกต้อง
ข้อมูลถูกส่งไปที่เซิร์ฟเวอร์
เมื่อส่งสำเร็จ ผู้ใช้เห็นข้อความยืนยัน
เมื่อเกิดข้อผิดพลาด ผู้ใช้เห็นข้อความที่เข้าใจได้
secret ไม่หลุดไปอยู่ในฟรอนต์เอนด์
การเปลี่ยนแปลงไม่ทำให้หน้าที่มีอยู่แล้วพัง
งานจะเสร็จก็ต่อเมื่อทำครบทุกข้อแล้วเท่านั้น
15. อย่าเชื่อคำว่า “เสร็จแล้ว”
AI อาจบอกอย่างมั่นใจว่าทุกอย่างเสร็จแล้ว แต่ไม่ได้แปลว่างานจบจริง
ตัวอย่างคำขอหลังพัฒนาเสร็จ:
“ตรวจผลลัพธ์ตาม Definition of Done แยกให้ชัดว่าข้อไหนคุณยืนยันได้ และข้อไหนเช็กไม่ได้ถ้าไม่รันโปรเจกต์”
แบบนี้ AI จะไม่กลบความไม่แน่นอนเอาไว้
16. ใช้ตรรกะแบบ FSM: อย่ากระโดดข้ามขั้น
FSM คือ finite state machine (เครื่องสถานะจำกัด) พูดง่าย ๆ คือกระบวนการที่ไปขั้นถัดไปไม่ได้ จนกว่าขั้นปัจจุบันจะปิด
ตัวอย่าง:
ห้ามเขียนโค้ดจนกว่าจะตกลง scope กันแล้ว
ห้ามปิดงานจนกว่าจะผ่านการตรวจ
ห้ามปล่อยเวอร์ชันจนกว่าจะเช็ก secret แล้ว
ห้ามเปลี่ยนสถาปัตยกรรมโดยไม่มีการตัดสินใจแยกต่างหาก
แนวทางนี้ป้องกันการกระโดดไปมาระหว่างงานแบบมั่ว ๆ
17. ให้ AI อยู่ในโหมดเดียวต่อครั้ง
ไม่ต้องสั่งให้ AI เป็นทั้งโปรดักต์แมเนเจอร์ สถาปนิก ดีไซเนอร์ นักพัฒนา เทสเตอร์ และผู้เชี่ยวชาญด้านความปลอดภัยไปพร้อมกัน
แยกบทบาทจะดีกว่า
ตัวอย่าง:
ก่อนอื่น: “คุณคือนักวิเคราะห์โปรดักต์ ช่วยเก็บรายละเอียด requirement ให้ชัด”
จากนั้น: “คุณคือสถาปนิก เสนอโครงสร้างมา”
จากนั้น: “คุณคือนักพัฒนา ทำ slice แรก”
จากนั้น: “คุณคือรีวิวเวอร์ ตรวจโค้ดหาความเสี่ยง”
แบบนี้ AI ทำงานได้แม่นกว่า
18. อะไรที่ทำอัตโนมัติได้ อย่าปล่อยให้ AI ตัดสินใจเอง
AI เป็นระบบเชิงความน่าจะเป็น การตรวจที่ต้องเป๊ะใช้เครื่องมือแบบ deterministic จะดีกว่า
ตัวอย่าง:
ไม่ดี: “Claude ช่วยเช็กหน่อยว่ามี type error ไหม”
ดี: รัน npm run typecheck
ไม่ดี: “AI ช่วยดูหน่อยว่าโค้ดจัดฟอร์แมตเรียบร้อยไหม”
ดี: รัน npm run lint
AI มีประโยชน์ตอนวิเคราะห์ข้อผิดพลาด แต่ตัวการตรวจเองควรทำผ่านเทสต์, linter, type-check และสคริปต์
19. ให้ AI อธิบายสิ่งที่เปลี่ยน
หลังพัฒนาเสร็จ AI ต้องอธิบายว่ามันเปลี่ยนอะไร เพราะอะไร และมีความเสี่ยงอะไรเกิดขึ้น
ตัวอย่างคำขอ:
“ขอ changelog: ไฟล์ไหนถูกแก้ เพราะอะไร มีความเสี่ยงอะไรที่อาจเกิดขึ้น และอะไรต้องเช็กด้วยมือ”
วิธีนี้ช่วยให้คุณยังคุมโปรเจกต์ได้
20. จำกัดพื้นที่ที่แก้ได้
AI ไม่ควรเขียนโปรเจกต์ใหม่ครึ่งหนึ่งเพื่องานเล็ก ๆ งานเดียว
ตัวอย่าง:
“แก้โจทย์นี้เฉพาะใน /components/CandidateForm.tsx และ /schemas/candidate.ts เท่านั้น ห้ามแก้ระบบล็อกอิน routing และโครงสร้างฐานข้อมูลโดยไม่ตกลงกันก่อน”
พื้นที่ที่แก้ยิ่งเล็ก ผลลัพธ์ก็ยิ่งตรวจง่าย
21. อย่าให้ AI “refactor ทั้งหมด” โดยไม่มีเหตุผล
การ refactor ต้องแก้ปัญหาที่เจาะจง ไม่อย่างนั้นมันอาจกลายเป็นการเขียนโค้ดที่ใช้งานได้อยู่แล้วใหม่แบบมั่ว ๆ
แบบที่ไม่ดี:
“ปรับปรุงโปรเจกต์ให้ดีขึ้น”
แบบที่ดี:
“เอาโค้ดจัดการข้อผิดพลาดที่ซ้ำกันในเมธอด API สามตัวนี้ออก โดยไม่เปลี่ยนสัญญาสาธารณะ (public contract) ของ API”
การ refactor ต้องมีเป้าหมายและขอบเขต
22. ข้อมูลต้องมีสัญญา (contract)
DTO หรือ Data Transfer Object คือคำอธิบายรูปร่างของข้อมูลที่ส่งไปมาระหว่างส่วนต่าง ๆ ของระบบ
ตัวอย่าง DTO ของผู้สมัคร:
id
name
email
phone
status
source
createdAt
ถ้าไม่ได้เขียนสัญญาไว้ AI อาจตั้งชื่อฟิลด์ที่หนึ่งว่า name อีกที่ว่า fullName และอีกที่ว่า candidateName
สัญญาข้อมูลป้องกันไม่ให้โปรเจกต์ค่อย ๆ เละ
23. ตรวจสอบข้อมูลขาเข้า
ห้ามเชื่อข้อมูลที่มาจากผู้ใช้ จากฟรอนต์เอนด์ หรือจาก API ภายนอก
ตัวอย่าง:
ถ้าผู้ใช้ส่งอีเมลมา เซิร์ฟเวอร์ต้องเช็กว่ามันเป็นอีเมลจริง ๆ
ถ้าสถานะผู้สมัครเป็นได้แค่ new, screening, interview, offer, rejected เซิร์ฟเวอร์ต้องไม่รับข้อความอะไรก็ได้
validation คือการป้องกันพื้นฐานเพื่อคุณภาพของข้อมูล
24. ใช้ zod หรือสคีมาแบบเดียวกัน
Zod ช่วยอธิบายสคีมาข้อมูลและตรวจมันตอนแอปทำงาน
ตัวอย่าง:
ก่อนบันทึกผู้สมัครลงฐานข้อมูล ออบเจ็กต์จะผ่าน candidateSchema ก่อน
ถ้าข้อมูลถูกต้อง ก็บันทึก
ถ้าข้อมูลเพี้ยน ก็ส่งข้อผิดพลาดกลับไป
Zod ทำหน้าที่เหมือนการ์ดหน้าประตูทางเข้าระบบ
25. อย่าเชื่อแม้แต่ฟรอนต์เอนด์ของตัวเอง
ถึงฟอร์มบนเว็บจะตรวจช่องต่าง ๆ แล้ว เซิร์ฟเวอร์ก็ยังต้องตรวจซ้ำอีกรอบ
ทำไม?
ผู้ใช้อาจปลอมคำขอ
ฟรอนต์เอนด์อาจพัง
บอทอาจส่งข้อมูลมาตรง ๆ
บริการภายนอกอาจส่งข้อมูลกลับมาในรูปแบบที่ไม่คาดคิด
ตัวอย่าง:
ฟอร์มฝั่งฟรอนต์เอนด์ไม่ยอมให้ส่งอีเมลว่าง แต่เซิร์ฟเวอร์ก็ยังต้องตรวจอีเมลซ้ำอีกครั้ง
26. secret ต้องไม่อยู่ในโค้ด
API key, token, รหัสผ่าน และข้อมูลส่วนตัว ห้ามเก็บไว้ในโค้ดและห้าม commit ลงรีโพ
ไม่ดี:
const API_KEY = "sk_live_..."
ดี:
process.env.PAYMENT_API_KEY
secret ต้องเก็บไว้ในตัวแปรสภาพแวดล้อม (environment variables) หรือที่เก็บ secret โดยเฉพาะ
27. อย่าส่ง secret จริงเข้าแชท AI
AI ช่วยเรื่องการตั้งค่าได้ แต่มันไม่จำเป็นต้องรู้คีย์ รหัสผ่าน และ token ตัวจริง
ไม่ดี:
“นี่คือ API key จริงของผม ช่วยตั้งค่าระบบชำระเงินหน่อย”
ดี:
PAYMENT_API_KEY=[REDACTED_SECRET]
หรือ
PAYMENT_API_KEY=your_key_here
ให้ AI รู้โครงสร้าง แต่อย่าให้ secret จริง
28. อย่าเขียนระบบเข้ารหัสและระบบล็อกอินเองถ้าไม่จำเป็น
ระบบล็อกอิน รหัสผ่าน token และการเข้ารหัส เป็นโซนที่เสี่ยงสูง
แบบที่ไม่ดี:
“AI ช่วยเขียนระบบเก็บรหัสผ่านขึ้นมาเองให้หน่อย”
แบบที่ดี:
ใช้โซลูชันที่ผ่านการพิสูจน์มาแล้ว: Supabase Auth, Firebase Auth, Clerk, Auth0, OAuth หรือบริการอื่นที่ใช้กันมานานจนเชื่อถือได้
ความปลอดภัยไม่ใช่ที่สำหรับทำเองแบบมือสมัครเล่น
29. เปิดใช้ความปลอดภัยพื้นฐานตั้งแต่ต้น
ความปลอดภัยไม่ควรโผล่มาแค่ตอนก่อนปล่อยเวอร์ชัน
ขั้นต่ำตั้งแต่เริ่ม:
ไม่ commit ไฟล์ .env
เปิด 2FA บน GitHub
ตรวจสอบข้อมูลในฟอร์ม
ไม่เก็บรหัสผ่านเป็นข้อความธรรมดา
จำกัดสิทธิ์การเข้าถึง
ไม่ให้สิทธิ์ AI เกินจำเป็น
ไม่ใช้ dependency ที่ไม่รู้จักโดยไม่ตรวจก่อน
ตัวอย่าง:
ต่อให้เป็น MVP ก็ตาม secret ก็ยังต้องไม่อยู่ในรีโพ
30. ประเมินความเสี่ยงตามสามแกน
ประเมินความเสี่ยงได้ผ่านคำถามสามข้อ:
พื้นผิวการโจมตี (attack surface) กว้างแค่ไหน
ความเสียหายที่อาจเกิดขึ้นมีอะไรบ้าง
โอกาสที่จะถูกโจมตีมีมากแค่ไหน
ตัวอย่าง:
แอปจดโน้ตไว้ใช้เองกับระบบรับชำระเงิน ต้องการการป้องกันคนละระดับ
กรณีแรก ความผิดพลาดแค่น่ารำคาญ
กรณีที่สอง อาจทำให้เสียเงิน ข้อมูลรั่วไหล และมีผลทางกฎหมาย
31. แยก devsec ออกจาก prodsec
devsec คือความปลอดภัยของกระบวนการพัฒนา
prodsec คือความปลอดภัยของโปรดักต์ที่ใช้งานอยู่จริง
ตัวอย่าง devsec:
ไม่เก็บ token ไว้บน GitHub
เปิด 2FA
จำกัดสิทธิ์การเข้าถึง
ตรวจ dependency
ตัวอย่าง prodsec:
ผู้ใช้ต้องไม่เห็นใบสมัครของคนอื่น
ข้อมูลต้องผ่าน validation
ระบบล็อกอินต้องทำงานถูกต้อง
ข้อมูลส่วนบุคคลต้องเก็บอย่างปลอดภัย
สำคัญทั้งสองโซน
32. อย่าปล่อยโปรดักต์ที่สำคัญขึ้นโปรดักชันโดยไม่ผ่านการ audit
ถ้าโปรดักต์เกี่ยวกับการชำระเงิน การแพทย์ การเงิน ข้อมูลส่วนบุคคล หรือกระบวนการที่มีผลทางกฎหมาย โค้ดจาก AI อย่างเดียวไม่พอ
ตัวอย่าง:
AI ช่วยประกอบ MVP ของฟอร์มชำระเงินได้ แต่ก่อนรับเงินจริงต้องมี audit ทางวิศวกรรม: ความปลอดภัย การเก็บข้อมูล ข้อผิดพลาด สิทธิ์การเข้าถึง และการทำตามข้อกำหนด
ราคาของความผิดพลาดยิ่งสูง ยิ่งพึ่ง “ดูเหมือนจะใช้ได้” ได้น้อยลง
33. ทำ log และ monitoring อย่างน้อยระดับพื้นฐาน
หลังปล่อยเวอร์ชัน ต้องรู้ว่าเกิดอะไรขึ้นในโปรดักต์
ตัวอย่าง:
ผู้ใช้บอกว่า: “ส่งฟอร์มไม่ได้”
ถ้าไม่มี log คุณไม่รู้เลยว่าเกิดอะไรขึ้น
ถ้ามี log ก็จะรู้ได้ว่า:
validation ผิดพลาด
API ใช้งานไม่ได้
ฐานข้อมูลไม่ตอบสนอง
บริการภายนอกส่งข้อผิดพลาดกลับมา
ไม่ได้ตั้งค่าตัวแปรสภาพแวดล้อม
monitoring เปลี่ยน “มีอะไรสักอย่างพัง” ให้กลายเป็นงานที่จับต้องได้
34. แยก “เครื่องผมใช้ได้” ออกจาก “พร้อมให้ผู้ใช้ใช้”
การที่โปรเจกต์รันได้บนเครื่องตัวเอง ยังไม่ได้แปลว่ามันพร้อมสำหรับผู้ใช้จริง
ตัวอย่าง:
บนเครื่องตัวเองฟอร์มใช้ได้ แต่บนโปรดักชัน:
ไม่มีตัวแปรสภาพแวดล้อม
เวอร์ชันมือถือพัง
ข้อผิดพลาดไม่ถูกบันทึก log
ฐานข้อมูลไม่รับข้อมูลบางส่วน
ผู้ใช้เห็นข้อผิดพลาดทางเทคนิค
ความพร้อมไม่ได้มีแค่การรันบนเครื่องตัวเองได้
35. บันทึกการตัดสินใจไปพร้อมกับการทำงาน
เอกสารไม่ได้มีไว้ให้สวย แต่มีไว้ไม่ให้โปรเจกต์สูญเสียความจำ
ตัวอย่าง:
ถ้าตกลงกันแล้วว่าสถานะผู้สมัครมีได้แค่:
new
screening
interview
offer
rejected
ก็ต้องเขียนไว้ในเอกสารและในสคีมาข้อมูล
ผ่านไปอีกเดือน AI ก็ต้องไม่คิดระบบสถานะขึ้นมาใหม่เอง
36. อัปเดตบริบทของโปรเจกต์หลังทำทุกฟีเจอร์
ถ้าสถาปัตยกรรม API โครงสร้างข้อมูล หรือกฎต่าง ๆ เปลี่ยน ต้องบันทึกไว้
ตัวอย่าง:
เพิ่มฟิลด์ source ให้ผู้สมัคร
ต้องอัปเดต:
สคีมาข้อมูล
เอกสาร API
คำอธิบายโมเดล
ฟอร์ม
validation
เทสต์ ถ้ามี
ไม่อย่างนั้นงานถัดไปจะถูกสร้างบนบริบทเก่า
37. ให้ AI ระบุจุดที่ไม่แน่ใจให้ชัด
AI ไม่ควรกลบความไม่แน่นอนด้วยความมั่นใจ
ตัวอย่าง prompt:
“ถ้าข้อมูลไม่พอสำหรับการแก้โจทย์ อย่าแต่งขึ้นมาเอง แยกรายการคำถาม สมมติฐาน และจุดที่ต้องให้คนตรวจออกมาต่างหาก”
ข้อนี้สำคัญเป็นพิเศษในเรื่องสถาปัตยกรรม ความปลอดภัย และการเชื่อมต่อระบบ
38. อย่าตัดสินใจเรื่องสถาปัตยกรรมเพียงเพราะ AI เสนอมา
AI อาจเสนอทางแก้ที่ฟังดูน่าเชื่อ แต่ไม่เหมาะ
ตัวอย่าง:
AI เสนอ microservices ให้ MVP ตัวเล็ก ๆ
ก่อนจะตกลง ต้องถามว่า:
มันแก้ปัญหาอะไร
ต้นทุนการดูแลเท่าไหร่
ทำให้ง่ายกว่านี้ได้ไหม
เรากำลังสร้างความซับซ้อนเกินจำเป็นหรือเปล่า
ใครจะเป็นคนดูแลมันต่อ
คนเป็นผู้ตัดสินใจ ไม่ใช่โมเดล
39. ใช้ AI เพื่อขยายความสามารถ ไม่ใช่แทนความรับผิดชอบ
AI อธิบาย แนะนำ และช่วยลงมือทำได้ แต่ความรับผิดชอบต่อโปรดักต์ยังอยู่ที่คน
ตัวอย่าง:
คุณขอให้ AI อธิบายว่าระบบล็อกอินทำงานยังไงได้ แต่ถ้าโปรดักต์เก็บข้อมูลลูกค้า ความรับผิดชอบเรื่องการทำให้ปลอดภัยก็ยังอยู่ที่คุณ
AI ช่วยคิด แต่ไม่ได้รับผิดชอบผลที่ตามมา
40. คิดไม่ใช่แค่เรื่องการสร้าง แต่รวมถึงการดูแลต่อ
โปรดักต์ไม่ได้จบหลังการสร้างโค้ดครั้งแรก มันต้องถูกซ่อม ขยาย ดูแล และส่งต่อให้คนอื่น
ตัวอย่าง:
ถ้าพรุ่งนี้มีนักพัฒนาเข้ามา เขาต้องเข้าใจได้ว่า:
โปรเจกต์ทำงานยังไง
เอกสารอยู่ที่ไหน
มีสคีมาข้อมูลอะไรบ้าง
ตัดสินใจอะไรไปแล้วบ้าง
รันโปรเจกต์ยังไง
ดูข้อผิดพลาดที่ไหน
ส่วนไหนห้ามแก้ถ้าไม่ระวัง
ถ้าวนกับ AI ไปแล้ว 200 รอบ แต่ไม่มีใครเข้าใจโปรเจกต์ได้ แปลว่ากระบวนการไม่ดี
สูตรสั้น ๆ ของไวบ์โค้ดดิ้งเชิงวิศวกรรม
อย่าสั่ง AI ว่า “ทำโปรดักต์ให้หน่อย”
ก่อนอื่น:
อธิบายโปรดักต์
รวบรวม requirement
บันทึกสเปก
กำหนดสถาปัตยกรรม
แตกโปรดักต์เป็น vertical slice เล็ก ๆ
ใช้ lifecycle กับทุกฟีเจอร์
ไม่เขียนโค้ดก่อนมีแผน
ใช้ Definition of Done
ตรวจผลลัพธ์
คิดเรื่องความปลอดภัย
บันทึกการตัดสินใจ
อัปเดตบริบทของโปรเจกต์
หลังจากนั้นเท่านั้น ถึงจะนับว่างานเสร็จแบบวิศวกรรม
ข้อสรุปหลัก
ไวบ์โค้ดดิ้งไม่ได้อันตรายเพราะ AI ไม่ดี มันอันตรายเมื่อคนโยนงานให้ AI โดยไม่มีกรอบ ไม่มี requirement ไม่มีสถาปัตยกรรม และไม่มีการตรวจ
แนวทางที่เป็นผู้ใหญ่หน้าตาต่างออกไป:
“นี่คือบริบทของโปรดักต์ นี่คือ requirement นี่คือสถาปัตยกรรม นี่คือข้อจำกัด นี่คืองาน นี่คือเกณฑ์ว่าเสร็จ เช็กบริบทก่อน แล้วเสนอแผน แล้วทำ slice ที่ตกลงกันไว้ แล้วตรวจผลลัพธ์และอัปเดตเอกสาร”
แบบนี้ AI จะไม่ใช่เครื่องปั่นโค้ดแบบมั่ว ๆ แต่เป็นผู้ช่วยในกระบวนการทางวิศวกรรม
ส่วนเรื่องการสั่งงานโมเดลยังไงไม่ให้มันต้องเดา อ่านแยกได้ที่ prompt engineering ตามกฎของ OpenAI และ Anthropic



