
บทนำ
ตลอดสองปีที่ผ่านมา prompt engineering มีความเชื่อผิด ๆ สะสมอยู่เยอะ บางคนยังตามหา “คำวิเศษ” อยู่จนทุกวันนี้ บางคนเก็บสะสมชุดสำนวนแพรวพราว ส่วนอีกกลุ่มเชื่อไปเลยว่าโมเดลรุ่นใหม่ไม่ต้องใช้ prompt แล้ว ทั้งสองแบบสุดโต่งพอกัน
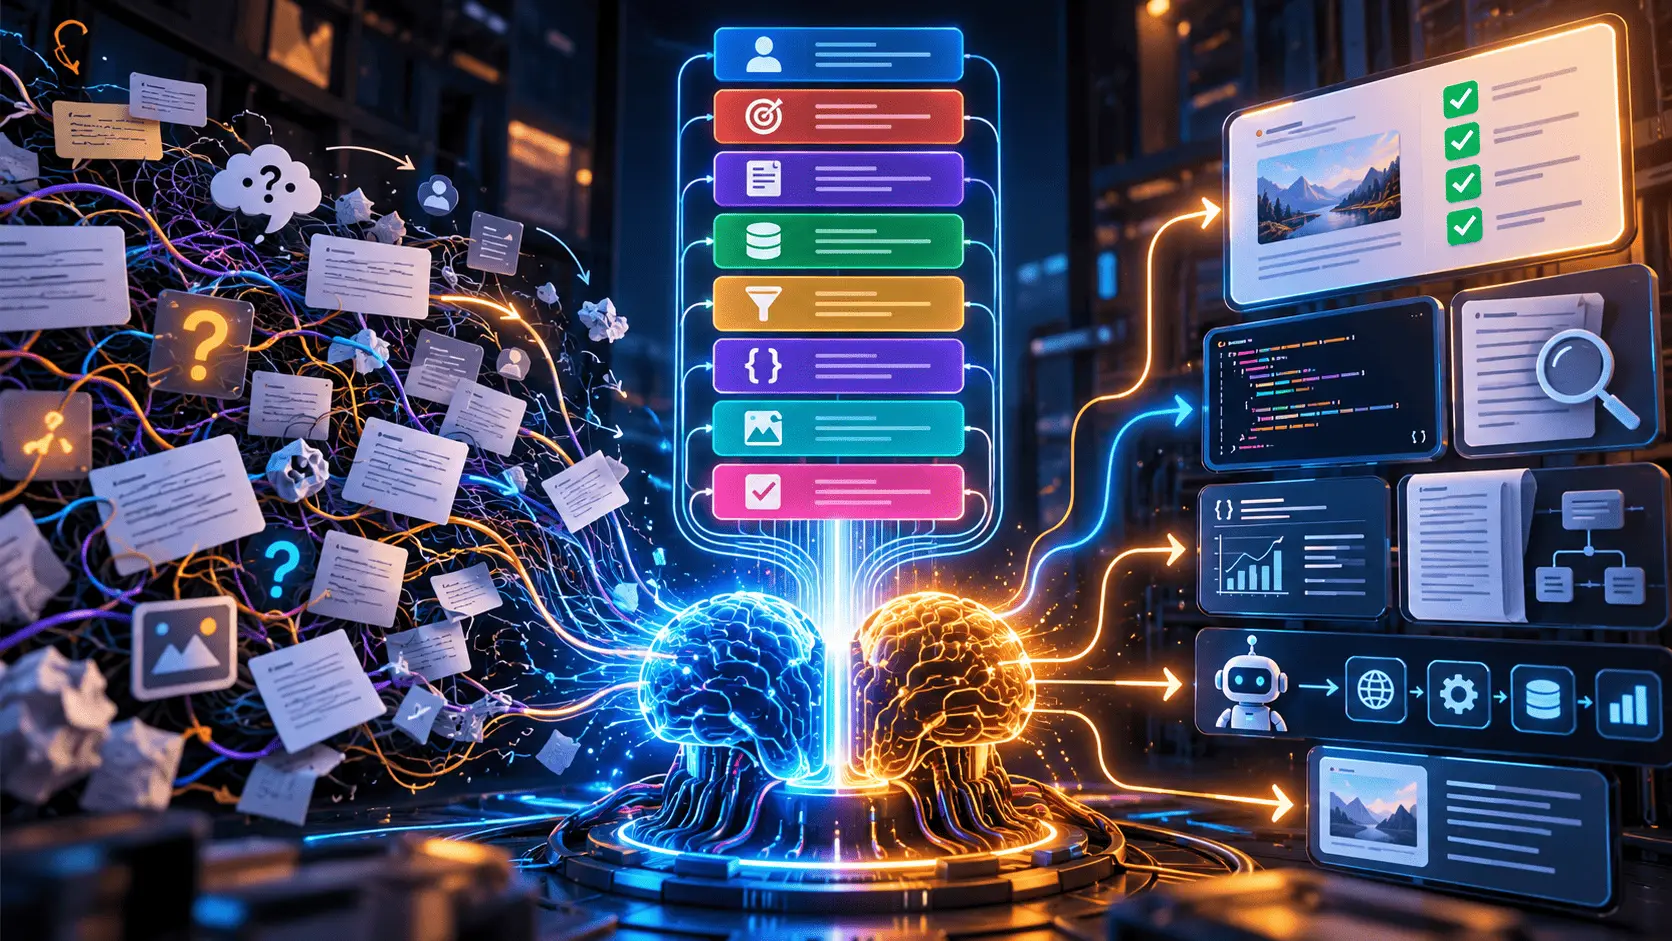
ถ้าสรุปคำแนะนำของ OpenAI และ Anthropic ให้เหลือความคิดเดียวแบบตรงไปตรงมา ก็จะได้ว่า prompt ที่ดีไม่ใช่ประโยคมหัศจรรย์ แต่คือโจทย์ที่ตั้งมาอย่างดี คำขอที่ดีไม่บังคับให้โมเดลต้องเดาว่าคุณหมายถึงอะไรกันแน่ มันบอกเป้าหมาย บริบท ข้อจำกัด รูปแบบ เกณฑ์คุณภาพ และวิธีรับมือเมื่อเจอจุดที่กำกวม
นี่แหละคือ prompt engineering ที่โตแล้ว ไม่ใช่การเล่นคำ แต่คือวินัยในการคิด โมเดลทำงานได้ดีขึ้นไม่ใช่เพราะมันถูก “โน้มน้าว” แต่เพราะมันได้สัญญาเรื่องผลลัพธ์ที่ชัดเจน
คำแนะนำของ OpenAI เน้นที่ความชัดเจนของคำสั่ง ลำดับของบล็อก ความเฉพาะเจาะจง ตัวอย่าง การคุมรูปแบบคำตอบ และความต่างระหว่างการเขียน prompt ให้โมเดล GPT ทั่วไปกับโมเดลสาย reasoning ส่วน Anthropic เสริมด้วยมุมมองที่ลึกกว่าในเรื่องโครงสร้าง XML, context ยาว ๆ, tool use, โหมด thinking, ระบบเอเจนต์, การตรวจงานตัวเอง และงานอัตโนมัติที่กินเวลานาน เมื่อรวมกัน สองแนวทางนี้กลายเป็นระบบการทำงานเดียวกัน
ด้านล่างคือบทความยาวเชิงปฏิบัติแบบละเอียด: กฎหลัก โครงสร้างของ prompt ที่ดี วิธีทำตามประเภทงาน แอนตี้แพตเทิร์น การวินิจฉัยว่าพังตรงไหน และชุดเทมเพลตที่เอาไปปรับใช้กับงานจริงได้
1. prompt ที่ดีในทางปฏิบัติคืออะไร
prompt ที่อ่อนมักดูโอเคแค่ตอนแรกเห็น มันอาจสั้น สุภาพ และฟังดู “มีเหตุผล” ด้วยซ้ำ แต่ข้างในแทบทุกครั้งจะขาดเรื่องสำคัญไป โมเดลไม่รู้ว่าผลลัพธ์แบบไหนถือว่าดี บริบทจบตรงไหนและคำสั่งเริ่มตรงไหน เดาเอาเองได้ไหม ต้องยึดรูปแบบเคร่งแค่ไหน ต้องอธิบายขั้นตอนการทำงานหรือให้ผลลัพธ์สุดท้ายเลย
prompt ที่ดีกลับกันคือมันขจัดความไม่แน่นอนออกไป มันทำงานเหมือนบรีฟงานที่ดีสำหรับคนทำงานเก่ง ๆ: บอกเป้าหมาย ขอบเขต ประเภทผลลัพธ์ที่คาดหวัง ข้อจำกัด และเกณฑ์ตรวจรับงาน
วิธีจำที่ง่ายที่สุดคือสูตรนี้:
prompt ที่ดี = บทบาท + เป้าหมาย + บริบท + ข้อมูลอินพุต + ข้อจำกัด + รูปแบบคำตอบ + ตัวอย่าง + การตรวจคุณภาพ
ไม่ใช่ทุกคำขอที่ต้องใช้ทุกองค์ประกอบเท่า ๆ กัน แต่นี่คือชิ้นส่วนที่ใช้สร้างฐานของการตั้งโจทย์ที่ดีแทบทุกแบบ
2. กฎหลักของ prompt engineering
สิ่งแรกที่ต้องคิดไม่ใช่ข้อความในคำขอ แต่คือผลลัพธ์
ความผิดพลาดหลักของมือใหม่คือเริ่มจากประโยค ไม่ใช่จาก outcome ก่อนเขียน prompt ควรตอบตัวเองให้ได้สักสองสามข้อ: สุดท้ายแล้วต้องได้อะไรออกมา จะรู้ได้ยังไงว่าผลลัพธ์ดี ข้อจำกัดไหนที่ต้องมีแน่ ๆ และอะไรที่ห้ามเด็ดขาด
คำขอ “เขียนข้อความดี ๆ เรื่องแนวคิดแบบ product” อ่อนเกินไป ไม่ใช่เพราะมันสั้น แต่เพราะแทบไม่ได้กำหนดอะไรเลย ผู้อ่านคือใคร ประเด็นหลักคืออะไร ยาวแค่ไหน สไตล์ไหน ต้องการบทความ หัวข้อย่อ โพสต์ สุนทรพจน์ โน้ตสำหรับช่อง หรือข้อความสำหรับพรีเซนเทชัน ใช้ลิสต์ได้ไหม ต้องมีตัวอย่างหรือเปล่า
ก่อนเขียนคำขอ ต้องตอบสี่คำถามนี้:
- สุดท้ายแล้วต้องได้อะไรออกมา?
- จะรู้ได้ยังไงว่าผลลัพธ์ดี?
- ข้อจำกัดไหนที่ต้องมีแน่ ๆ?
- อะไรที่ห้ามเด็ดขาด?
ตัวอย่างการตั้งโจทย์ที่แย่:
เขียนข้อความดี ๆ เรื่องแนวคิดแบบ product
การตั้งโจทย์ที่ดี:
เขียนบทความ 6–8 ย่อหน้าสำหรับผู้อ่านที่เป็น founder และ product manager อธิบายว่าทำไมในยุค AI ความเร็วในการสร้างโปรดักต์ถึงไม่ใช่ข้อได้เปรียบในตัวมันเองอีกต่อไป ชี้ให้เห็นว่าคำถามสำคัญไม่ใช่ “เราสร้างอะไรได้บ้าง” แต่คือ “ลูกค้ายอมจ่ายเงินเพื่อแก้ปัญหาอะไร” สไตล์ฉลาด ชัดเจน ไม่เป็นภาษาราชการ ไม่ใช้ลิสต์ ยกเว้นบล็อกสั้น ๆ หนึ่งบล็อกที่มี 3 คำถาม ไม่ใส่ลิงก์
ในแบบที่สอง โมเดลเข้าใจว่า:
— หัวข้อคืออะไร
— ผู้อ่านคือใคร
— ประเด็นหลักคืออะไร
— ยาวแค่ไหน
— สไตล์แบบไหน
— โครงสร้างเป็นยังไง
— อะไรที่ห้ามทำ
คำขอแบบนี้ในเวอร์ชันที่แข็งแรงก็ดูเหมือนโจทย์งานจริงแล้ว: เขียนบทความสำหรับ founder และ product manager ยาว 6–8 ย่อหน้า ชี้ว่าทำไมในยุค AI ความเร็วในการสร้างโปรดักต์ไม่ได้เป็นข้อได้เปรียบในตัวเองแล้ว อธิบายว่าคำถามสำคัญไม่ใช่ว่าสร้างอะไรได้ แต่คือลูกค้ายอมจ่ายเพื่อแก้ปัญหาอะไร รักษาสไตล์ที่ชัดและมีชีวิต ไม่เป็นภาษาราชการ และไม่ใส่ลิงก์ ตรงนี้โมเดลไม่ต้องเดาแล้ว แต่ลงมือทำได้เลย
ต้องแยกคำสั่งออกจากข้อมูล
ทั้ง OpenAI และ Anthropic บอกตรง ๆ ว่าโมเดลทำงานได้ดีกว่าเมื่อ prompt มีโครงสร้าง ปัญหาที่เจอบ่อยที่สุดคือเอาคำสั่งกับเนื้อหามาปนกันเป็นก้อนเดียวโดยไม่มีการกำกับ ในสภาพแบบนั้น โมเดลจะแยกได้แย่ลงว่าส่วนไหนคือคำสั่ง ส่วนไหนคือข้อมูลที่ต้องวิเคราะห์
ดังนั้น prompt ควรถูกแบ่งเป็นบล็อก ตัวเลือกที่สะดวกที่สุดคือ:
— หัวข้อแบบ Markdown
— แท็ก XML
— ส่วนที่ระบุชัด ๆ อย่าง คำสั่ง, บริบท, อินพุต, รูปแบบคำตอบ
ตัวอย่างแบบ Markdown:
# งาน
ทำสรุปเชิงวิเคราะห์ของเอกสาร

# บริบท
ข้อความด้านล่างคือบทถอดความการสัมภาษณ์

# ข้อกำหนด
- แก้คำพูดที่ผิดชัด ๆ
- อย่าเปลี่ยนความหมาย
- แยกคำพูดของผู้พูดสองคนให้ถูกต้อง

# รูปแบบคำตอบ
1. summary สั้น ๆ
2. บทสัมภาษณ์ฉบับเต็มที่ตรวจแก้แล้ว

# ข้อมูลอินพุต
"""
...
"""
ด้วยเหตุนี้ prompt แทบทุกตัวจะดีขึ้นเมื่อมีโครงสร้างที่ชัดเจน อาจเป็น Markdown ที่มีส่วน “งาน”, “บริบท”, “ข้อกำหนด”, “รูปแบบคำตอบ” หรือเป็น XML ที่มีแท็ก <role>, <task>, <context>, <input>, <constraints> ก็ได้ Anthropic ผลักดัน XML อย่างสม่ำเสมอเป็นพิเศษ ในฐานะวิธีขจัดความกำกวมใน prompt ที่ซับซ้อน
ห้ามเขียนแบบคลุมเครือ
คำอย่าง “ปกติ ๆ”, “สวย ๆ”, “ไม่ยาวเกินไป”, “แบบมืออาชีพ”, “ทำแบบผู้เชี่ยวชาญ” ดูเหมือนคำสั่ง แต่จริง ๆ แทบไม่ได้กำหนดอะไรเลย โมเดลไม่รู้ว่าคุณใส่ความหมายอะไรไว้ในคำเหล่านี้
prompt พังเพราะคำแบบนี้:
— “ปกติ ๆ”
— “สวย ๆ”
— “ไม่ยาวเกินไป”
— “สั้น แต่ละเอียด”
— “ทำแบบมืออาชีพ”
โมเดลไม่รู้ว่าคุณใส่ความหมายอะไรไว้ในคำเหล่านี้ ต้องแปลงมันให้เป็นข้อกำหนดที่ใช้งานได้จริง
แทนที่จะเขียน:
ทำให้สั้น ๆ
ให้เขียนว่า:
คำตอบ 5 ข้อ แต่ละข้อ 1–2 ประโยค
แทนที่จะเขียน:
เขียนให้มีชีวิตชีวาและดูเชี่ยวชาญ
ให้เขียนว่า:
สไตล์มั่นใจ ชัดเจน ไม่เป็นภาษาราชการ ไม่มีคำโฆษณาลอย ๆ ประโยคยาวปานกลาง ใช้น้ำเสียงแบบคุยกันได้ แต่ไม่เป็นกันเองเกินไป
นามธรรมทุกอย่างต้องแปลงเป็นเกณฑ์ที่ใช้งานได้ ไม่ใช่ “ทำให้สั้น ๆ” แต่คือ “ให้ 5 ข้อ ข้อละ 1–2 ประโยค” ไม่ใช่ “เขียนให้มีชีวิตชีวาและดูเชี่ยวชาญ” แต่คือ “สไตล์มั่นใจและชัดเจน ไม่เป็นภาษาราชการ ไม่มีคำโฆษณาลอย ๆ ประโยคยาวปานกลาง ใช้น้ำเสียงแบบคุยกันได้แต่ไม่เป็นกันเองเกินไป”
รูปแบบคำตอบต้องกำหนดเป็นสัญญา
ถ้ารูปแบบสำคัญ จะอธิบายแบบลอย ๆ ไม่ได้ ไม่ต้องขอว่า “เป็น JSON ประมาณนี้” แต่ต้องกำหนดรูปแบบเป็นสัญญา
แย่:
คืนค่าเป็น JSON
ดีกว่า:
{
  "topic": "string",
  "key_points": ["string"],
  "risks": ["string"],
  "conclusion": "string"
}
ดียิ่งกว่า คือเพิ่มกฎเข้าไป:
— ห้ามมีฟิลด์เพิ่มเติม
— ห้ามมีคอมเมนต์นอก JSON
— ถ้าข้อมูลไม่พอ ให้คืน array ว่างหรือฟิลด์ null
— ห้ามแต่งค่าขึ้นมาเอง
หลักนี้ใช้ได้เหมือนกันกับงานเขียน “เขียนสั้น ๆ” แย่กว่า “ตอบเป็นสามย่อหน้า: ปัญหา ข้อสรุป คำแนะนำ” ยิ่งตรวจทีหลังได้ง่ายว่าผลลัพธ์ตรงตามรูปแบบหรือไม่ prompt ก็ยิ่งทำงานได้เสถียร
ตัวอย่างคือหนึ่งในคันโยกที่ทรงพลังที่สุด
OpenAI แนะนำให้ไต่บันไดที่เข้าใจง่าย: เริ่มจาก zero-shot แล้วไป few-shot และถ้ายังไม่พอค่อยคิดถึงการปรับแต่งที่เป็นระบบมากขึ้น Anthropic ก็เน้น few-shot หนักเช่นกัน โดยเฉพาะเมื่องานกำกวม หรือเมื่อโครงสร้าง โทน และวิธีคิดต้องแม่นยำ
- เริ่มจาก zero-shot ก่อน
- ถ้าคุณภาพไม่เสถียร ให้เพิ่ม few-shot
- ถ้างานซ้ำ ๆ จำนวนมากและเป็นประจำ ค่อยคิดถึงการปรับแต่งที่เป็นระบบมากขึ้นหรือ fine-tuning
ตัวอย่างที่ดีควร:
— ตรงกับงาน
— หลากหลาย
— แสดงแพตเทิร์นที่ต้องการจริง ๆ
— แยกออกจากคำสั่ง
หน้าที่ของตัวอย่างไม่ใช่แค่โชว์คำตอบที่อยากได้ แต่คือตรึงแพตเทิร์นที่โมเดลต้องทำซ้ำ
บอกว่าต้องทำอะไร ดีกว่าบอกแค่ว่าห้ามทำอะไร
ข้อสรุปที่มีประโยชน์ที่สุดข้อหนึ่งจากเอกสารคือ ข้อห้ามเชิงลบได้ผลน้อยกว่าคำสั่งเชิงบวก
แย่:
อย่าเขียนแห้ง ๆ อย่าใช้ลิสต์ อย่าใช้ภาษาราชการ อย่าทวนคำถาม
ดีกว่า:
เขียนเป็นย่อหน้าที่ลื่นไหล สไตล์มีชีวิต แบบนักข่าว มั่นใจ เริ่มที่แก่นเรื่องทันทีโดยไม่ทวนคำถาม ใช้ลิสต์เฉพาะเมื่อมันช่วยให้อ่านง่ายขึ้นจริง ๆ
ข้อห้ามยังจำเป็น แต่ไม่ควรเป็นวิธีเดียวในการคุมโมเดล
1.7. prompt ที่ดีคำนึงถึงโหมดของโมเดล
ข้อนี้สำคัญมาก
โมเดลและโหมดที่ต่างกันต้องการการคุมคนละแบบ
สำหรับโมเดล GPT ทั่วไป การอธิบายขั้นตอน รูปแบบ โครงสร้าง และกฎให้ชัดจะช่วยได้
สำหรับโมเดลสาย reasoning สิ่งที่ได้ผลกว่าคือ:
— เป้าหมายที่ชัดเจน
— ข้อจำกัด
— output contract ที่ระบุชัด
— เกณฑ์ว่า “อะไรถือว่าทำเสร็จแล้ว”
แต่ไม่ต้องเขียนกระบวนการคิดภายในของโมเดลละเอียดเกินไป โมเดล reasoning สมัยใหม่มักทำได้ดีกว่าเมื่อได้กรอบ แทนที่จะมีคนกำหนดกระบวนการคิดให้มันอย่างละเอียดทุกขั้นตอน
1.8. พารามิเตอร์ไม่ได้มาแทน prompt ที่ดี
temperature, max tokens, reasoning effort และการตั้งค่าอื่น ๆ เป็นชั้นรอง
ลำดับที่ถูกต้องคือ:
- prompt ที่ดีก่อน
- แล้วตามด้วยตัวอย่าง
- แล้วกฎการตรวจ
- แล้วค่อยปรับพารามิเตอร์
งานที่ต้องการข้อเท็จจริง การดึงข้อมูล และ truthful QA มักต้องใช้ temperature ต่ำ
งานที่สร้างสรรค์กว่านั้นใช้ค่าที่สูงขึ้นได้
แต่ prompt ที่แย่ “กู้” ด้วย temperature อย่างเดียวไม่ได้
3. โครงสร้างของ prompt ที่ดี
ในทางปฏิบัติ prompt ที่ดีแทบทุกตัวแยกออกได้เป็นแปดบล็อก
1. บทบาท
บทบาทกำหนดรูปแบบพฤติกรรม ไม่จำเป็นต้องยาว แต่มักช่วยให้โหมดการทำงานแคบลง “คุณคือบรรณาธิการบทสัมภาษณ์”, “คุณคือนักวิจัยและนักวิเคราะห์”, “คุณคือวิศวกรที่ศึกษาโค้ดก่อนแล้วค่อยแก้” ไม่ใช่ของประดับ แต่คือวิธีขยับโมเดลเข้าสู่โหมดที่ต้องการ
2. เป้าหมาย
ตรงนี้สิ่งสำคัญคือไม่ได้อธิบายแค่การกระทำ แต่อธิบายผลลัพธ์ที่คาดหวัง ไม่ใช่ “วิเคราะห์เอกสาร” แต่คือ “ทำสรุปเชิงวิเคราะห์ ดึงประเด็นหลัก จุดที่ยังถกเถียงได้ และข้อสรุปที่เอาไปใช้ได้จริง”
3. บริบท
บริบทตอบคำถามว่าโมเดลควรรู้อะไรก่อนเริ่มงาน ผู้อ่านคือใคร ผลลัพธ์จะถูกเอาไปใช้ยังไง มีเงื่อนไขตั้งต้นอะไรบ้าง ทำไมถึงต้องมีงานนี้ตั้งแต่แรก Anthropic เน้นเป็นพิเศษว่าบริบทและเหตุผลเบื้องหลังพฤติกรรมที่ต้องการช่วยยกคุณภาพคำตอบได้ชัดเจน
4. ข้อมูลอินพุต
นี่คือตัวเนื้อหาเอง: ข้อความ ตาราง บทถอดความ โค้ด เอกสาร รายการลิงก์ อินพุตจากผู้ใช้ ต้องแยกออกจากคำสั่ง
5. ข้อจำกัด
ส่วนนี้รวมสไตล์ ความยาว อิสระที่โมเดลมีได้ การห้ามเดาเติม กฎเมื่อข้อมูลไม่พอ ความจำเป็นต้องมีแหล่งอ้างอิง ข้อจำกัดเรื่องลิสต์ ลิงก์ ภาษาราชการ การตั้งสมมติฐาน และอื่น ๆ
6. รูปแบบคำตอบ
คำตอบต้องถูกกำหนดให้ตรวจสอบได้ แม้จะเป็นข้อความอิสระ ก็ควรกำหนดโครงสร้างที่ต้องการ เช่น “summary สั้น ๆ ก่อน แล้ววิเคราะห์ จากนั้นคำแนะนำ”
7. ตัวอย่าง
ไม่ได้จำเป็นทุกครั้ง แต่มีประโยชน์มากเป็นพิเศษกับงานจัดรูปแบบ การดึงข้อมูล การแปลงข้อความ การจัดหมวดหมู่ และงานเรื่องสไตล์
8. การตรวจคุณภาพ
นี่คือชั้นที่สำคัญมากแต่มักถูกลืม ควรบอกโมเดลตรง ๆ ว่า ก่อนจบงานให้ตรวจว่าครอบคลุมทุกส่วนของโจทย์ รูปแบบถูกต้อง ไม่มีข้อขัดแย้ง และไม่ได้เพิ่มข้อเท็จจริงที่ยืนยันไม่ได้ Anthropic เน้นประโยชน์ของ self-check เป็นพิเศษ ส่วนแนวทาง GPT-5 สำหรับงานโค้ดและงานเอเจนต์ทำให้การตรวจสอบกลายเป็นวินัยภาคบังคับไปเลย
นี่คือโครงพื้นฐานที่ใช้เป็นแม่แบบอเนกประสงค์ได้:
<role>
คุณคือ [บทบาท]
</role>

<objective>
ต้องได้ [ผลลัพธ์ที่ชัดเจน]
ถือว่าสำเร็จเมื่อ:
1. ...
2. ...
3. ...
</objective>

<context>
บริบทที่สำคัญ:
...
</context>

<input>
ข้อมูลอินพุต:
...
</input>

<constraints>
- ยึดสไตล์: ...
- ความยาว: ...
- อย่าเดาเติมข้อเท็จจริงที่ยืนยันไม่ได้
- ถ้าข้อมูลไม่พอ ให้ระบุความไม่แน่นอนให้ชัด
</constraints>

<output_format>
คืนผลลัพธ์ในรูปแบบ:
...
</output_format>

<examples>
  <example>
    <input>...</input>
    <output>...</output>
  </example>
</examples>

<verification>
ก่อนให้คำตอบสุดท้าย ให้ตรวจว่า:
- ครอบคลุมทุกส่วนของโจทย์หรือยัง
- รูปแบบถูกต้องหรือไม่
- มีข้อขัดแย้งไหม
- ได้เพิ่มอะไรที่ยืนยันไม่ได้เข้าไปหรือเปล่า
</verification>
4. ขั้นตอนพื้นฐานในการออกแบบ prompt
prompt ที่ดีแทบทุกตัวถูกประกอบขึ้นด้วยตรรกะเดียวกัน
ขั้นแรกคือระบุประเภทงาน ตราบใดที่ยังไม่ชัดว่าเป็นงานสร้างเนื้อหา ดึงข้อมูล แก้ไข วิเคราะห์ รีเสิร์ช เขียนโค้ด หรืองานเอเจนต์ที่ใช้เครื่องมือ ก็ยากที่จะตั้งคำขอให้ดีได้
จากนั้นกำหนดว่าอะไรคือความสำเร็จ ต้องเขียนเกณฑ์ออกมาจริง ๆ: ครอบคลุมทุกส่วนของงานไหม ตั้งสมมติฐานได้หรือเปล่า ต้องการรูปแบบเคร่งครัดไหม ต้องมีแหล่งอ้างอิงไหม ตรวจผลลัพธ์อัตโนมัติได้หรือไม่
ขั้นต่อไปคือกำหนดว่าโมเดลมีอิสระแค่ไหน มันควรแค่ตอบ เสนอทางเลือก หาข้อมูลเอง ทำงานอัตโนมัติ หรือขอการยืนยันก่อนทำอะไรที่เสี่ยง ส่วนนี้สำคัญเป็นพิเศษสำหรับ tool use และโหมดเอเจนต์
จากนั้นแตก prompt เป็นบล็อก: บทบาท งาน บริบท ข้อจำกัด รูปแบบ การตรวจ ถ้างานซับซ้อนก็เพิ่มตัวอย่าง, citation rules, research mode, dependency checks, completeness contract, tool policy
แล้วกำจัดความกำกวม คำถามตรวจที่ดีที่สุดตรงนี้ง่ายมาก: ถ้ายื่น prompt นี้ให้คนอ่านโดยไม่มีบริบทเพิ่มเติม เขาจะเข้าใจไหมว่าต้องทำอะไรกันแน่
หลังจากนั้นทดสอบ prompt ไม่ใช่แค่กับเคสเดียว แต่หลายเคส: เคสปกติ เคสยาก เคสขอบ เคสที่ข้อมูลไม่พอ และเคสที่แหล่งข้อมูลขัดกัน แล้วการปรับปรุงจริง ๆ ถึงจะเริ่ม
หลักการแก้ข้อหลักคือ สิ่งที่ต้องซ่อมไม่ใช่ “ความสวยของสำนวน” แต่คือจุดอ่อนในสัญญา ถ้าโมเดลผิด สาเหตุมักเป็นหนึ่งในห้าข้อนี้: บริบทไม่พอ ไม่ได้กำหนดรูปแบบ ไม่มีตัวอย่าง ไม่ได้บอกว่าต้องทำยังไงเมื่อไม่แน่ใจ หรือไม่มีการตรวจขั้นสุดท้าย
5. วิธีทำตามประเภทงาน
การสร้างข้อความ
สำหรับงานเขียน สิ่งสำคัญที่สุดคือกำหนดผู้อ่าน เป้าหมาย และประเด็นหลักให้ถูก ถ้าไม่บอกว่าผู้อ่านคือใครและอยากให้เกิดผลอะไร โมเดลแทบจะไหลไปเป็นข้อความกลาง ๆ “สำหรับทุกคน” แน่นอน prompt สำหรับงานสร้างเนื้อหาที่ดีจะกำหนดบทบาทของผู้เขียน ผู้อ่าน เป้าหมายของข้อความ แนวคิดหลัก โทน สไตล์ ข้อจำกัดเรื่องความยาว และกฎเรื่องโครงสร้าง
เทมเพลตพื้นฐาน:
คุณคือบรรณาธิการและนักเขียนฝีมือดี

งาน: เขียนข้อความในหัวข้อ [หัวข้อ]
ผู้อ่าน: [ใครอ่าน]
เป้าหมาย: [ต้องการให้เกิดผลอะไร]
ประเด็นหลัก: [สิ่งที่ต้องสื่อ]

ข้อกำหนด:
- สไตล์: ...
- โทน: ...
- ความยาว: ...
- โครงสร้าง: ...
- ทำได้ / ห้ามทำ: ...

ให้คำตอบเป็นฉบับสุดท้ายเลย ไม่ต้องอธิบายขั้นตอน
การดึงข้อเท็จจริงและการจัดหมวดหมู่
ตรงนี้ความสร้างสรรค์ต้องน้อยที่สุด ส่วนโครงสร้างต้องเคร่งที่สุด ต้องมีข้อห้ามเดาเติมที่ชัดเจน สคีมาคำตอบที่แม่นยำ และพฤติกรรมที่เข้าใจได้เมื่อไม่มีข้อมูลที่ต้องการ
<task>ดึง entity ออกจากข้อความ</task>
<constraints>
- ดึงเฉพาะสิ่งที่มีอยู่ในข้อความโดยตรง
- ห้ามเดาเติมอะไรเลย
- ถ้าไม่มี entity นั้น ให้คืน array ว่าง
</constraints>
<output_format>
{
  "companies": [],
  "people": [],
  "topics": [],
  "themes": []
}
</output_format>
<input>
...
</input>
การวิเคราะห์เอกสารยาว
Anthropic เน้นแนวปฏิบัติที่ได้ผลหลายข้อสำหรับงาน long-context: เอกสารยาวควรวางไว้ด้านบนของ prompt ส่วนคำขอให้อยู่ใกล้ท้าย เอกสารหลายชิ้นต้องกำกับแยกกันและมีเมทาดาทาประกอบ และก่อนสังเคราะห์ข้อสรุป ควรให้โมเดลดึงคำพูดหรือข้อเท็จจริงที่เกี่ยวข้องออกมาก่อน
เรื่องนี้สำคัญเป็นพิเศษกับบทสัมภาษณ์ บทถอดความ เอกสารคดี รายงานขนาดใหญ่ พรีเซนเทชัน งานวิจัย และชุดเอกสารหลายชิ้นในหัวข้อเดียวกัน
<documents>
  <document index="1">
    <source>บทสัมภาษณ์ 1</source>
    <document_content>...</document_content>
  </document>
  <document index="2">
    <source>บทสัมภาษณ์ 2</source>
    <document_content>...</document_content>
  </document>
</documents>

<task>
ขั้นแรก ระบุทุกจุดที่บอกได้อย่างมั่นใจว่าใครเป็นคนพูด
จากนั้น ประกอบเป็นฉบับเต็มที่ตรวจแก้แล้ว
ถ้าความมั่นใจไม่พอ ให้ทำเครื่องหมายไว้ให้ชัด
</task>
Research และ deep research
สำหรับงานรีเสิร์ช คำขอกว้าง ๆ อย่าง “ศึกษาหัวข้อนี้แล้วเล่าให้ฟัง” มักได้ผลไม่ดีแทบทุกครั้ง ที่ได้ผลกว่าคือโหมดวิจัยที่ระบุชัด โมเดลต้องแตกหัวข้อเป็นคำถามย่อย ศึกษาแต่ละข้อแยกกัน ตรวจข้อเท็จจริงที่ขัดกัน ค้นซ้ำเมื่อผลลัพธ์ว่าง และแยกข้อเท็จจริงที่ยืนยันแล้วออกจากข้อสรุปให้ชัด
<research_mode>
- แตกหัวข้อเป็นคำถามย่อย 3–6 ข้อ
- ศึกษาแต่ละข้อแยกกัน
- ถ้าผลลัพธ์ว่างหรือแคบเกินไป ให้ลองกลยุทธ์อื่น 1–2 แบบ
- จบการวิจัยเมื่อการค้นเพิ่มไม่น่าจะเปลี่ยนข้อสรุปแล้วเท่านั้น
</research_mode>

<citation_rules>
- อ้างอิงเฉพาะแหล่งที่หาเจอจริง
- ห้ามแต่งลิงก์และคำพูดขึ้นมาเอง
- ผูกแหล่งอ้างอิงเข้ากับประเด็นที่เจาะจง
</citation_rules>

<grounding_rules>
- ห้ามกล่าวอ้างโดยไม่มีข้อมูลรองรับ
- ถ้าแหล่งข้อมูลขัดกัน ให้แสดงความขัดแย้งนั้นให้ชัด
- ถ้าเป็นข้อสรุป ไม่ใช่ข้อเท็จจริงโดยตรง ให้ทำเครื่องหมายไว้
</grounding_rules>
โค้ดและ coding agents
ตรงนี้คำแนะนำของ OpenAI และ Anthropic ตรงกันเป็นพิเศษ: ทำความเข้าใจงานและสภาพแวดล้อมก่อน อย่าแก้โค้ดก่อนศึกษาจุดที่ต้องแก้ หลังแก้ต้องตรวจผลเสมอ คำนึงถึง hidden tests และ edge cases และอย่าปิดงานด้วยความรู้สึกว่า “น่าจะใช้ได้แล้ว”
<role>
คุณคือวิศวกรซอฟต์แวร์ที่ทำงานละเอียดและตรวจการแก้ไขอย่างถี่ถ้วน
</role>

<workflow>
1. ทำความเข้าใจงานและโค้ดเบสก่อน
2. อย่าแก้ไฟล์จนกว่าจะเข้าใจตำแหน่งและความหมายของการแก้
3. หลังแก้ ให้ตรวจโค้ดด้วยเทสต์หรือรันจริง
4. อย่าปิดงานจนกว่าจะมั่นใจว่าวิธีแก้ถูกต้อง
</workflow>

<verification>
- ตรวจไม่ใช่แค่เคสที่มองเห็น แต่รวมถึง edge cases ด้วย
- อย่าถือว่าการแก้สำเร็จเพียงเพราะ patch ลงได้
- ถ้ามีอะไรที่ตรวจไม่ได้ ให้บอกตรง ๆ
</verification>
OpenAI ยังพูดถึงเทคนิค leading words: สำหรับ Python การขึ้นต้นด้วย import อาจช่วยได้ สำหรับ SQL คือ SELECT เป็นวิธีเล็ก ๆ แต่บางครั้งก็มีประโยชน์ในการดันโมเดลเบา ๆ ไปสู่รูปแบบการสร้างที่ต้องการ
งานเอเจนต์และ tool use
เมื่อโมเดลเข้าถึงเครื่องมือได้ ต้องกำหนดไม่ใช่แค่งาน แต่รวมถึงนโยบายการกระทำด้วย เมื่อไหร่ใช้เครื่องมือ เมื่อไหร่ทำต่อโดยไม่ใช้ เมื่อไหร่ต้องตรวจผลแน่ ๆ อะไรถือเป็นการกระทำที่เสี่ยง และกรณีไหนต้องขอการยืนยันจากผู้ใช้
<tool_policy>
- ใช้เครื่องมือถ้ามันช่วยเพิ่มความถูกต้อง ความครบถ้วน หรือ grounding ได้ชัดเจน
- อย่าหยุดเร็วเกินไป ถ้า tool call เพิ่มอีกครั้งช่วยให้ผลลัพธ์ดีขึ้นมาก
- ถ้า tool คืนผลว่างหรือแคบจนน่าสงสัย ให้ลองทางอื่น
</tool_policy>

<dependency_checks>
- ก่อนลงมือ ให้ตรวจว่าต้องมีขั้นค้นหา อ่าน หรือดึงข้อมูลก่อนหรือไม่
- อย่าข้ามขั้น prerequisite เพียงเพราะการกระทำสุดท้ายดูชัดเจนแล้ว
</dependency_checks>

<safety>
- ถ้าการกระทำถัดไปย้อนกลับไม่ได้หรือกระทบระบบภายนอก ให้ขอการยืนยันก่อน
</safety>
6. อะไรสำคัญเป็นพิเศษกับโมเดล reasoning สมัยใหม่
โมเดล reasoning สมัยใหม่มีจุดเด่นสำคัญ: หลายครั้งไม่ต้องเขียนทุกขั้นตอนการคิดให้มันเอง OpenAI แยกการเขียน prompt ให้โมเดล GPT กับโมเดล reasoning อย่างชัดเจน Anthropic ก็เน้นว่าการคุมทีละขั้นที่เคร่งเกินไปอาจถึงขั้นเป็นอุปสรรค
สำหรับโมเดล reasoning สิ่งที่ได้ผลกว่าไม่ใช่ละคร CoT ที่เขียนด้วยมือ แต่คือกรอบที่ชัด: เป้าหมาย ข้อจำกัด รูปแบบ เกณฑ์คุณภาพ และข้อกำหนดให้ตรวจขั้นสุดท้าย ประโยคอย่าง “แก้โจทย์อย่างรอบคอบ ก่อนให้คำตอบสุดท้ายให้ตรวจว่าตรงตามทุกเงื่อนไข” มักมีประโยชน์กว่าการพยายามเขียนกระบวนการคิดเองทุกรายละเอียด
ส่วนโมเดลเล็ก กลับกัน มักต้องการคำสั่งที่เคร่งและชัดกว่า: กฎสำคัญไว้ต้น ลำดับขั้นตอนที่ชัดเจน รูปแบบแบบปิด คำอธิบาย edge cases และตัวอย่างดี ๆ อย่างน้อยหนึ่งตัว
7. แอนตี้แพตเทิร์นที่ทำ prompt พัง
แอนตี้แพตเทิร์นแรกและเจอบ่อยที่สุดคือ “ทำให้ดี ๆ” นี่ไม่ใช่คำสั่ง แต่คือความหวัง โมเดลไม่รู้ว่าในบริบทของคุณ “ดี” หมายถึงอะไร
ข้อที่สองคือเอางานกับข้อมูลอินพุตมายำรวมกันจนแยกไม่ออก เมื่อ prompt ไม่มีการกำกับ โมเดลจะหลงโครงสร้างและบทบาทของแต่ละส่วนบ่อยขึ้น
ข้อที่สามคือไม่มีรูปแบบคำตอบ แต่ละรอบที่รันอาจได้หน้าตาต่างกัน และผลลัพธ์ก็ไม่เสถียร
ข้อที่สี่คือไม่มีกฎว่าต้องทำยังไงเมื่อข้อมูลไม่พอ ในสถานการณ์แบบนี้ โมเดลจะเริ่มหลอน หรือไม่ก็ถามกลับไม่รู้จบ
ข้อที่ห้าคือไม่มีเกณฑ์การจบงาน โดยเฉพาะในงานเอเจนต์ โมเดลอาจจบเร็วเกินไป หรือกลับกัน ทำต่อไปเรื่อย ๆ โดยไม่มีจุดหยุดที่ชัด
ข้อที่หกคือข้อห้ามเยอะเกินไปโดยไม่มีกรอบเชิงบวก ข้อจำกัดเชิงลบมีประโยชน์ แต่ถ้าไม่อธิบายพฤติกรรมที่ต้องการให้ชัด มันจะได้ผลแย่กว่า
ข้อที่เจ็ดคือซับซ้อนเกินความจำเป็น prompt ที่ดีไม่จำเป็นต้องยาว มันต้องพอ เริ่มจากโครงสร้างขั้นต่ำที่ผ่านเคสจริงได้ แล้วค่อยเพิ่มความซับซ้อนทีหลังจะดีกว่า
8. วินิจฉัย: ทำไม prompt ทำงานได้ไม่ดี
ถ้าผลลัพธ์อ่อน ให้ถามตัวเองตามลำดับนี้
โมเดลเข้าใจโจทย์หรือเปล่า?
สัญญาณว่าไม่เข้าใจ:
— ตอบไม่ตรงคำถาม
— พูดกว้าง ๆ ลอย ๆ
— สับสนโหมดการทำงาน
วิธีแก้:
— เขียนเป้าหมายใหม่
— ทำให้ประโยคง่ายลง
— แยกคำสั่งออกจากบริบท
บริบทพอไหม?
สัญญาณ:
— เดาเติมเอง
— สับสนผู้เกี่ยวข้อง วันที่ บทบาท
— ให้ข้อสรุปที่ฟังดูดีแต่อ่อน
วิธีแก้:
— เพิ่มข้อมูลที่เกี่ยวข้อง
— ตัดสิ่งรบกวนออก
— กำกับแหล่งข้อมูล
กำหนดรูปแบบไว้เคร่งพอไหม?
สัญญาณ:
— โครงสร้างไม่นิ่ง
— parse อัตโนมัติไม่ได้
— แต่ละรอบที่รันออกมาหน้าตาไม่เหมือนกัน
วิธีแก้:
— กำหนด schema
— เพิ่มตัวอย่าง
— เขียนตรง ๆ ว่า “คืนเฉพาะรูปแบบนี้เท่านั้น”
โมเดลรู้ไหมว่าต้องทำยังไงเมื่อข้อมูลไม่พอ?
สัญญาณ:
— หลอน
— ถามกลับเกินจำเป็น
— หยุดกลางทาง
วิธีแก้:
— เพิ่ม missing-context behavior
— อนุญาตให้ตั้งสมมติฐานอย่างระมัดระวังได้ ต่อเมื่อทำเครื่องหมายกำกับไว้เท่านั้น
— สำหรับ context ที่หามาได้ (retrievable) ให้ชี้ไปที่ tools
มีการตรวจในตัวไหม?
สัญญาณ:
— คำตอบดูดีตามรูปแบบแต่ไม่ครบ
— ข้อย่อยหายไป
— รูปแบบผิด
วิธีแก้:
— เพิ่ม verification loop
— เพิ่ม completeness contract
9. ชุดเทมเพลตสำเร็จรูป
เทมเพลตอเนกประสงค์
<role>
คุณคือ [บทบาท]
</role>

<task>
ทำ [งานที่ชัดเจน]
</task>

<context>
บริบทที่สำคัญ:
...
</context>

<constraints>
- ห้ามเดาเติมข้อเท็จจริง
- ยึดสไตล์: ...
- ความยาว: ...
- โครงสร้าง: ...
</constraints>

<output_format>
คืนคำตอบในรูปแบบ:
...
</output_format>

<verification>
ก่อนให้คำตอบสุดท้าย ให้ตรวจความครบถ้วน ความถูกต้อง และความตรงตามรูปแบบ
</verification>
เทมเพลตวิเคราะห์เอกสารหลายชิ้น
<documents>
  <document index="1">
    <source>เอกสาร 1</source>
    <document_content>...</document_content>
  </document>
  <document index="2">
    <source>เอกสาร 2</source>
    <document_content>...</document_content>
  </document>
</documents>

<task>
1. ขั้นแรก ดึงข้อเท็จจริงที่เกี่ยวกับหัวข้อออกมา
2. จากนั้น เปรียบเทียบเอกสาร
3. แล้วประกอบเป็นข้อสรุปเดียว
4. ถ้าข้อมูลขัดกัน ให้แสดงความขัดแย้งนั้นให้ชัด
</task>

<output_format>
1. ข้อเท็จจริง
2. จุดที่ไม่ตรงกัน
3. ข้อสรุปรวม
4. ความไม่แน่นอน
</output_format>
เทมเพลตสำหรับ deep research
<role>
คุณคือนักวิจัยและนักวิเคราะห์
</role>

<research_mode>
- แตกหัวข้อเป็นคำถามย่อย 3–6 ข้อ
- ศึกษาแต่ละข้อแยกกัน
- ถ้าผลค้นหาว่างหรือแคบเกินไป ให้ลองกลยุทธ์อื่น
- หยุดเมื่อการค้นใหม่ไม่น่าจะเปลี่ยนข้อสรุปแล้วเท่านั้น
</research_mode>

<citation_rules>
- อ้างอิงเฉพาะแหล่งที่มีอยู่จริง
- ห้ามแต่งลิงก์และคำพูดขึ้นมาเอง
- ผูกแหล่งอ้างอิงเข้ากับประเด็นที่เจาะจง
</citation_rules>

<grounding_rules>
- ห้ามกล่าวอ้างโดยไม่มีข้อมูลรองรับ
- ถ้าเป็นข้อสรุป ไม่ใช่ข้อเท็จจริงโดยตรง ให้ทำเครื่องหมายไว้
</grounding_rules>

<output_format>
1. คำตอบสั้น ๆ
2. ข้อสรุปหลัก
3. จุดที่ยังถกเถียงได้
4. แหล่งอ้างอิงแยกตามประเด็น
</output_format>
เทมเพลตสำหรับบทความ
คุณคือบรรณาธิการและนักเขียนบทความ long-form ฝีมือดี

งาน: เขียนบทความในหัวข้อ [หัวข้อ]
ผู้อ่าน: [ผู้อ่าน]
เป้าหมาย: [เป้าหมายของข้อความ]
ประเด็นหลัก: [ประเด็น]

ข้อกำหนด:
- สไตล์: ฉลาด ชัดเจน มีชีวิต
- ไม่ใช้ภาษาราชการ
- ไม่พูดซ้ำ
- โครงสร้างเป็นเหตุเป็นผล เชื่อมต่อกันลื่นไหล
- ความยาว: [ความยาว]
- ใช้ลิสต์เฉพาะเมื่อจำเป็นจริง ๆ

ให้ข้อความฉบับสุดท้ายเลย
เทมเพลตสำหรับโพสต์ Telegram
เขียนโพสต์สำหรับ Telegram

หัวข้อ: [หัวข้อ]
ผู้อ่าน: [ใครอ่าน]
เป้าหมาย: [ผู้อ่านควรทำอะไร]

ข้อกำหนด:
- พาดหัวที่แรง
- เปิดเรื่องสั้น ๆ และดึงดูด
- อธิบายแก่นเรื่องให้ชัด
- โทน: มีชีวิต มั่นใจ อ่านง่าย
- ไม่เยิ่นเย้อ
- ความยาว: [โดยประมาณ]
- ตอนจบ: [CTA หรือตอนจบที่ต้องการ]
เทมเพลตเรียบเรียงบทสัมภาษณ์จากบทถอดความ
<role>
คุณคือบรรณาธิการบทสัมภาษณ์และนักวิเคราะห์บทถอดความ
</role>

<task>
ประกอบบทสัมภาษณ์ที่สมบูรณ์จากบทถอดความดิบ
</task>

<context>
มีผู้พูดสองคน: [ใครบ้าง]
อาจมีข้อผิดพลาดจากการถอดเสียงและการสับสนว่าใครพูด
</context>

<constraints>
- อย่าเปลี่ยนความหมาย
- แก้เฉพาะข้อผิดพลาดของคำพูดและ OCR/ASR ที่เห็นชัด
- แยกคำพูดของแต่ละคนให้แม่นที่สุด
- ถ้าความมั่นใจต่ำ ให้ทำเครื่องหมายไว้ให้ชัด
</constraints>

<output_format>
1. summary สั้น ๆ
2. บทสัมภาษณ์ฉบับสมบูรณ์
3. จุดที่ไม่ชัดเจน
</output_format>
10. เช็กลิสต์สุดท้ายก่อนใช้งาน
ก่อนจะถือว่า prompt พร้อมแล้ว ควรเช็กกับลิสต์สั้น ๆ นี้
ชัดไหมว่าต้องทำอะไรกันแน่ ชัดไหมว่าผลลัพธ์แบบไหนถือว่าดี แยกคำสั่งออกจากข้อมูลอินพุตแล้วหรือยัง มีรูปแบบคำตอบที่ระบุชัดไหม กำหนดพฤติกรรมเมื่อข้อมูลไม่พอแล้วหรือยัง ต้องมีตัวอย่างไหม ต้องมีการตรวจงานตัวเองไหม ถ้าใช้เครื่องมือ ได้กำหนดหรือยังว่าเมื่อไหร่ลงมือ เมื่อไหร่ต้องขอการยืนยัน ถ้าเป็นงานวิจัย มี grounding และ citation rules ไหม ถ้า context ยาว ได้กำกับเอกสารไว้หรือยัง
ถ้ามีหลายข้อในนี้ที่คำตอบคือ “ไม่” prompt นั้นแทบแน่นอนว่ายังทำให้แข็งแรงขึ้นได้อีก
บทสรุป
ข้อสรุปหลักจากคำแนะนำของ OpenAI และ Anthropic นั้นติดดินมาก prompt ที่ดีไม่ใช่เวทมนตร์ และไม่ใช่คอลเลกชันสำนวนลับ มันคือวิธีเปลี่ยนความตั้งใจคลุมเครือของคนให้กลายเป็นโจทย์งานที่ชัดเจนสำหรับโมเดล
เมื่อ prompt ถูกสร้างมาดี โมเดลไม่ได้รับแค่ “หัวข้อ” แต่ได้โหมดการทำงานที่เข้าใจได้ มันรู้ว่าต้องทำอะไร ให้ใคร ในรูปแบบไหน มีข้อจำกัดอะไร ต้องทำตัวยังไงเมื่อไม่แน่ใจ และจะตรวจตัวเองยังไงก่อนให้คำตอบสุดท้าย
นี่คือเหตุผลที่ prompt engineering ที่โตแล้ว โดยแก่นแท้คือสถาปัตยกรรมของการตั้งโจทย์ ยิ่งคุณกำหนดเป้าหมาย ให้บริบท จำกัดอิสระในจุดที่อันตราย และปล่อยอิสระในจุดที่มีประโยชน์ได้เก่งเท่าไร ผลลัพธ์ก็ยิ่งแข็งแรงขึ้นเท่านั้น
ถ้าสรุปเป็นประโยคเดียว ก็จะได้สูตรง่าย ๆ ว่า:
อย่าขอให้โมเดล “ทำให้สวย ๆ” แต่สร้างสัญญาเรื่องผลลัพธ์ที่ชัดเจนให้มัน
prompt เป็นแค่ส่วนหนึ่งของสิ่งที่โมเดลเห็น ทุกอย่างที่เหลือที่เข้าไปถึงโมเดลก่อนมันตอบคือ context และมันก็ต้องถูกจัดการเหมือนกัน
โครงสร้างขั้นต่ำของคำขอที่ดี
อธิบายเป้าหมาย ข้อมูลอินพุต ข้อจำกัด รูปแบบผลลัพธ์ และเกณฑ์การตรวจ ถ้างานซ้ำ ๆ ให้บันทึกสัญญานี้เป็นเทมเพลต แล้วเพิ่มตัวอย่างคำตอบที่ถูกและผิดสักสองสามตัว แบบนี้คุณภาพจะเสถียรกว่าการพยายาม “ขอดี ๆ” ใหม่ทุกครั้ง



