
ไวบ์โค้ดดิ้งทำให้การพัฒนาซอฟต์แวร์เข้าถึงง่ายขึ้น ตอนนี้คนคนเดียวประกอบต้นแบบเสร็จได้ในเย็นเดียว ทั้งที่เมื่อก่อนต้องใช้ทีมเล็ก ๆ ทีมหนึ่ง แต่มันก็พากับดักใหม่มาด้วย: เห็นหน้าจอที่ใช้งานได้ ก็ง่ายที่จะเข้าใจผิดว่าโปรดักต์เสร็จแล้ว
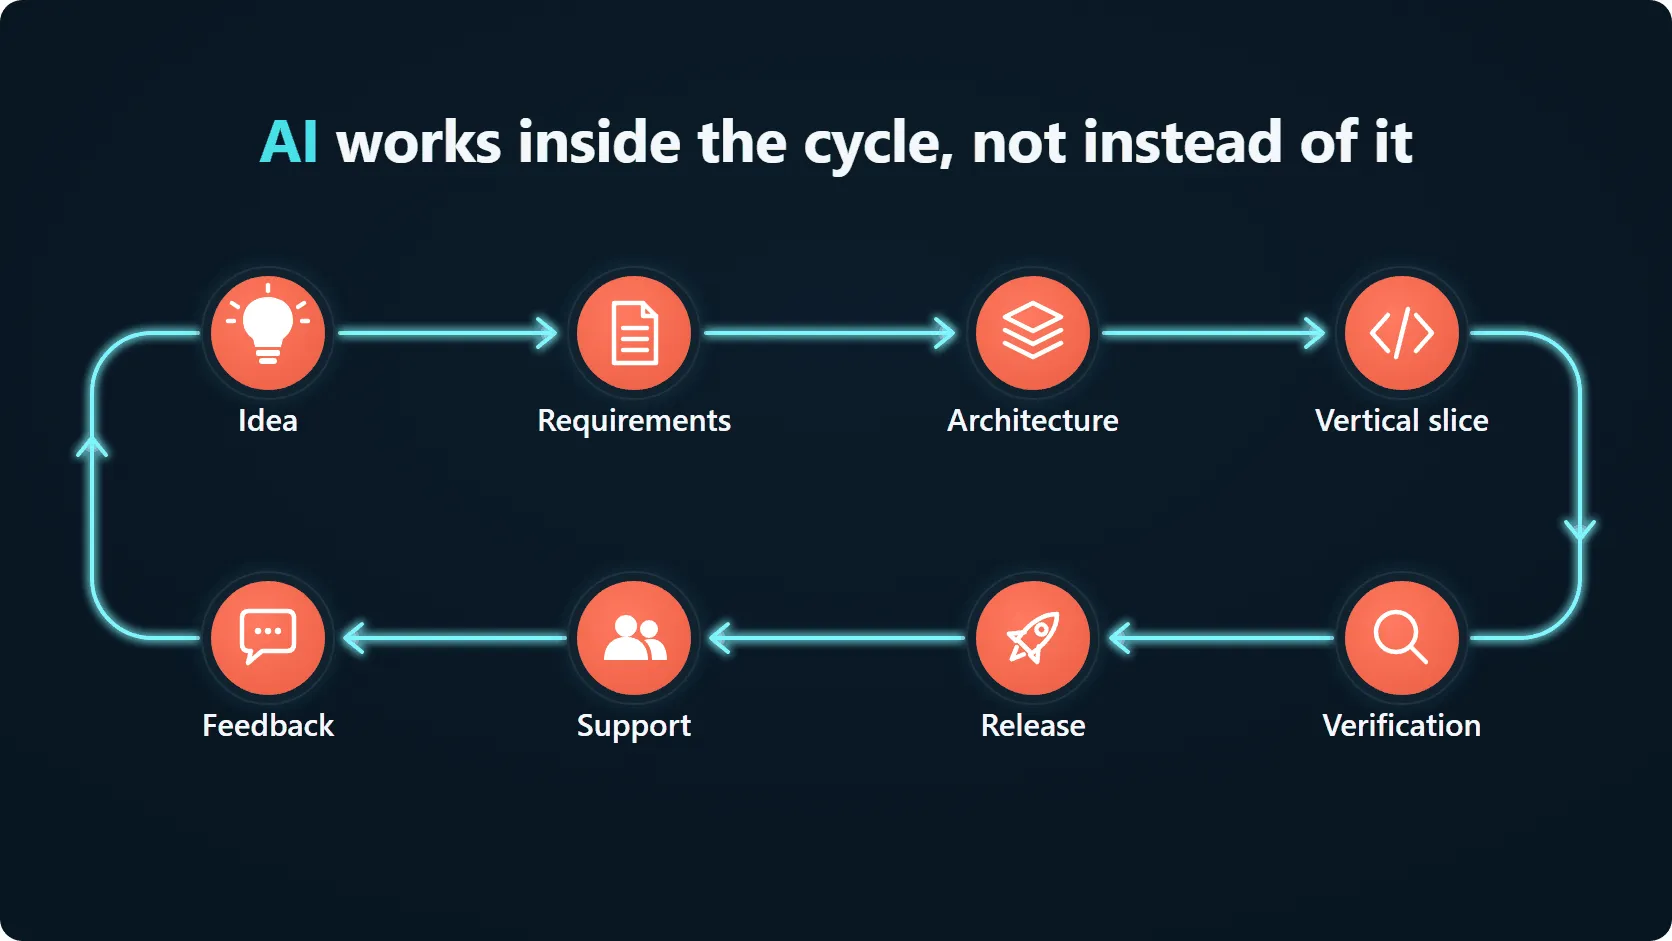
AI เอเจนต์เขียนโค้ด อธิบายข้อผิดพลาด เสนอสถาปัตยกรรม และรันเครื่องมือได้จริง แต่โค้ดเป็นแค่ช่วงหนึ่งของงานใหญ่ ก่อนหน้านั้นมีโจทย์ของโปรดักต์และ requirement (ข้อกำหนด) หลังจากนั้นมีการตรวจสอบ ความปลอดภัย การปล่อยใช้งาน และการดูแลต่อ
จุดเปลี่ยนสำคัญคือ ไม่ใช่ “ขอให้โมเดลสร้างแอปให้” แต่เป็นการวางกระบวนการที่เอเจนต์ทำงานเป็นขั้นตอนที่มีขอบเขตจำกัด ส่วนคนเข้าใจเป้าหมาย ตัดสินใจ และตรวจหลักฐาน
ไวบ์โค้ดดิ้งไม่ใช่ปัญหา ปัญหาคือการไม่มีกรอบ
การขอให้ AI “ทำระบบล็อกอินให้หน่อย” ก็คล้ายกับบอกผู้รับเหมาว่า “ทาสีแดงอะไรสักอย่างให้ที” เขาทำตามได้ แต่ไม่รู้ว่าผลลัพธ์แบบไหนถึงจะนับว่าดี
ระบบล็อกอินที่ว่าคืออีเมลกับรหัสผ่าน หรือเข้าผ่าน identity provider ภายนอก? ต้องมีการกู้คืนบัญชี MFA การยืนยันอีเมล การจำกัดจำนวนครั้งที่ลอง การออกจากระบบทุกอุปกรณ์ และการตรวจสอบเซสชันไหม? เก็บความลับ (secret) ไว้ที่ไหน? ถ้าเกิดข้อผิดพลาดจะเป็นยังไง? ผู้ใช้เห็นข้อมูลอะไรบ้าง?
ถ้าคำตอบพวกนี้ไม่ได้เขียนไว้ เอเจนต์จะเติมช่องว่างเอง ผลที่ได้คือโซลูชันที่ดูน่าเชื่อ แต่ไม่มีอะไรรับประกันว่าจะตรงกับโปรดักต์ นี่คือที่มาของอาการคุ้นเคยสี่อย่าง:
- “ถุงเท้าขาด”: หน้าจอใช้งานได้ แต่ข้างในมีช่องโหว่ มีความลับอยู่ในโค้ด หรือมีข้อมูลที่ไม่ได้ตรวจความถูกต้อง
- “วงล้อหนูแฮมสเตอร์”: การแก้แต่ละครั้งรักษาอาการหนึ่ง แล้วสร้างอาการใหม่อีกสองอย่าง
- รีแฟกเตอร์แบบทำลายล้าง: แค่งานเล็ก ๆ งานเดียว แต่โปรเจกต์ถูกเขียนใหม่ไปเป็นส่วนใหญ่
- เสียการควบคุม: ผ่านไปไม่กี่รอบ ก็ไม่รู้แล้วว่าอะไรเปลี่ยนไปและเพราะอะไร
ความเป็นผู้ใหญ่จึงไม่ได้อยู่ที่การห้าม AI เขียนโค้ด แต่อยู่ที่การไม่ปล่อยให้มันตัดสินใจเรื่องโปรดักต์และเรื่องที่มีความเสี่ยงไปเงียบ ๆ
AI เอเจนต์คือตัวขยายพลัง แต่ไม่ใช่ผู้รับผิดชอบโปรดักต์
วิศวกรรับผิดชอบมากกว่าแค่ไวยากรณ์ของโค้ด เขาต้องมองเห็นข้อจำกัด ต้นทุนของการเปลี่ยนแปลง ความปลอดภัย การดูแลระบบ และผลกระทบต่อผู้ใช้ เอเจนต์เสนอทางเลือกที่ฟังดูเป็นไปได้ทางเทคนิคได้ แต่มันไม่ได้รู้บริบทของบริษัทคุณเองโดยอัตโนมัติ และไม่ได้เป็นผู้รับผิดชอบความเสียหาย
เรื่องนี้สำคัญเป็นพิเศษกับการชำระเงิน ข้อมูลส่วนบุคคล งานด้านการแพทย์ และสถานการณ์อื่น ๆ ที่พลาดไม่ได้ ยิ่งความผิดพลาดมีราคาสูง ก็ยิ่งมีเหตุผลน้อยลงที่จะถือว่าคำตอบของโมเดลเป็นหลักฐานที่เพียงพอ
ควรแยกสามอย่างนี้ออกจากกัน:
- การสร้าง (generation) — เอเจนต์เสนอข้อความ โค้ด แผนภาพ หรือทางเลือกของโซลูชัน
- การตัดสินใจ — คนเลือกทางเลือกโดยคำนึงถึงโปรดักต์ งบประมาณ และความเสี่ยง
- หลักฐาน — เทสต์ การตรวจสอบ log หรือผลลัพธ์ที่สังเกตได้ ยืนยันว่าโซลูชันใช้งานได้จริง
AI ช่วยส่วนแรกได้ดีมาก และเร่งส่วนที่สองได้ชัดเจน ส่วนที่สามควรสร้างบนกลไกที่ทำซ้ำได้
SDLC: โค้ดคือช่วงกลาง ไม่ใช่วงจรชีวิตทั้งหมด
SDLC ย่อมาจาก Software Development Life Cycle หรือวงจรชีวิตการพัฒนาซอฟต์แวร์ มันไม่ใช่แผนภาพบังคับแบบเดียวที่มีจำนวนขั้นตายตัว แต่ละทีมแบ่งวงจรต่างกันไป แต่แทบทุกโมเดลจะมีงานที่วนซ้ำอยู่ไม่กี่แบบ:
- เข้าใจปัญหา ผู้ใช้ และข้อจำกัด
- เขียน requirement และเกณฑ์ความสำเร็จ
- ออกแบบขอบเขตของระบบและสัญญา (contract)
- ลงมือทำการเปลี่ยนแปลง
- ตรวจการทำงาน คุณภาพ และความปลอดภัย
- ส่งผลลัพธ์ถึงผู้ใช้
- เฝ้าดูโปรดักต์และดูแลต่อ
ในเลกเชอร์ต้นฉบับ เรื่องนี้ถูกแบ่งเป็นแปดขั้นตอนให้เข้าใจง่าย สิ่งสำคัญคือมองเลขแปดเป็นแผนที่สำหรับใช้งาน ไม่ใช่กฎธรรมชาติ ในงานจริง requirement ความปลอดภัย และการตรวจสอบไม่ได้รอให้เขียนโค้ดเสร็จก่อน มันวนกลับเข้ามาในวงจรหลังได้ฟีดแบ็กและเมื่อสภาพแวดล้อมเปลี่ยน
ถ้าคุณให้เอเจนต์เขียนแค่โค้ด คุณก็ใช้ SDLC แค่ส่วนเดียว ส่วนที่เหลือไม่ได้หายไปไหน มันแค่กลายเป็นบั๊กที่โผล่มาทีหลัง การไล่แก้ด้วยมือ และค่าใช้จ่ายที่ไม่คาดคิด
Spec-driven: แบบแปลนมาก่อน แล้วค่อยลงมือทำ
สเปก (specification) คือข้อตกลงสั้น ๆ เกี่ยวกับงาน ในสเปกควรระบุไว้ว่า:
- แก้ปัญหาอะไร และเพื่อใคร
- สถานการณ์ใช้งานไหนที่ต้องใช้ได้
- อะไรอยู่ในเวอร์ชันนี้ และอะไรที่ตั้งใจไม่ใส่
- ข้อจำกัดและกฎด้านสถาปัตยกรรม
- รูปแบบข้อมูลและสัญญากับภายนอก
- เกณฑ์ว่าแค่ไหนถึงนับว่าเสร็จ
- ไฟล์และระบบย่อยไหนที่ห้ามแก้
นี่ไม่ใช่งานเอกสารเปล่า ๆ สเปกช่วยลดจำนวนเรื่องที่เอเจนต์ต้องเดาเอง ในโปรเจกต์เล็ก แค่ PRD.md ไฟล์เดียวกับคำอธิบาย slice ที่ทำอยู่ก็พอ ในโปรเจกต์ที่ซับซ้อนกว่านั้นจะเพิ่ม ARCHITECTURE.md, CONVENTIONS.md, SECURITY.md และ TESTING.md
แต่เอกสารไม่ได้กลายเป็น source of truth เองได้แบบมีเวทมนตร์ มันต้องตรงกับโค้ดและการตรวจสอบ สเปกที่ล้าสมัยอันตรายกว่าสเปกสั้น ๆ ที่ยังอัปเดตอยู่
MVP ไม่ต้องสมบูรณ์แบบ แต่ต้องทำอย่างรู้ตัว
MVP ใช้ทดสอบสมมติฐาน ส่วนโปรดักต์ระดับ production ให้บริการผู้ใช้จริง สองอย่างนี้มีเกณฑ์ว่า “แค่นี้พอแล้ว” ต่างกัน
ใน MVP จะยังไม่ทำระบบวิเคราะห์ซับซ้อน การเชื่อมต่อสิบระบบ หรือสถาปัตยกรรม “ใช้ได้ร้อยปี” ก็ได้ แต่ต้องไม่จงใจปล่อยช่องโหว่ที่เห็นชัดในการเข้าถึงข้อมูล ไม่เก็บคีย์ไว้ในรีโพ และไม่รับอินพุตอะไรก็ได้ในจุดที่ business logic ขึ้นอยู่กับมัน
จุดสมดุลที่ถูกต้องคือ ฟีเจอร์ขั้นต่ำนั้นได้ แต่ความเสี่ยงที่ปล่อยไว้โดยไม่มีใครคุมนั้นไม่ได้ จดไว้ว่าข้อจำกัดไหนของ MVP เป็นของชั่วคราว ใครต้องกลับมาทบทวน และเมื่อไหร่
Vertical slice: เส้นทางเล็ก ๆ ที่ครบจบผ่านทั้งระบบ
Vertical slice ไม่ใช่ชั้นแบบ “ทำฐานข้อมูลให้เสร็จทั้งหมดก่อน แล้วค่อยทำ backend ทั้งหมด” มันคือฟีเจอร์หนึ่งอย่างที่ผู้ใช้ใช้ได้จริง ลากผ่านทุกชั้นที่จำเป็นตั้งแต่ต้นจนจบ
ตัวอย่างเช่น CRM ของเอเจนซีจัดหางาน slice แรกอาจเป็นแบบนี้: รีครูตเตอร์สร้างการ์ดผู้สมัคร ฟอร์มตรวจช่องข้อมูล API รับข้อมูล เซอร์วิสใช้กฎทางธุรกิจ เรคคอร์ดปรากฏในฐานข้อมูล อินเทอร์เฟซแสดงว่าสำเร็จ และแจ้งข้อผิดพลาดได้อย่างถูกต้อง
นี่น้อยกว่า “ทำ CRM” แต่มากกว่า “วาดฟอร์ม” ชิ้นงานแบบนี้เอาไปให้ผู้ใช้ดูและรับฟีดแบ็กได้ ก่อนที่ทีมจะสร้างฐานรากบนสมมติฐานที่ผิด
FSM และ lifecycle: อย่ากระโดดข้ามหลักฐาน
FSM ย่อมาจาก Finite State Machine หรือเครื่องสถานะจำกัด ในแง่การใช้งาน มันคือชุดของสถานะและการเปลี่ยนสถานะที่อนุญาต สำหรับการพัฒนา มันมีประโยชน์ในฐานะวินัยของกระบวนการ: ตราบใดที่ขั้นปัจจุบันยังไม่ปิด ขั้นถัดไปก็ยังไม่เริ่ม
lifecycle ของฟีเจอร์ในทางปฏิบัติอาจหน้าตาแบบนี้:
Context check— อ่านกฎของโปรเจกต์ สถาปัตยกรรมปัจจุบัน และข้อจำกัดScope— กำหนดว่าอะไรอยู่ในงานนี้ และอะไรไม่อยู่Plan— ระบุขั้นตอนและการเปลี่ยนแปลงที่คาดไว้Components— ไล่รายการส่วนที่ได้รับผลกระทบ: UI, API, ข้อมูล, เทสต์Implement— แก้ให้น้อยที่สุดเท่าที่จำเป็นVerify— เทียบผลลัพธ์กับคำขอTest— รันการตรวจทั้งแบบอัตโนมัติและแบบมือReview— หาสิ่งที่เกินมา regression และขอบเขตที่ถูกละเมิดDocument— อัปเดตเอกสาร ถ้าพฤติกรรมเปลี่ยนClose— บันทึกผลลัพธ์และคำถามที่ยังค้างอยู่
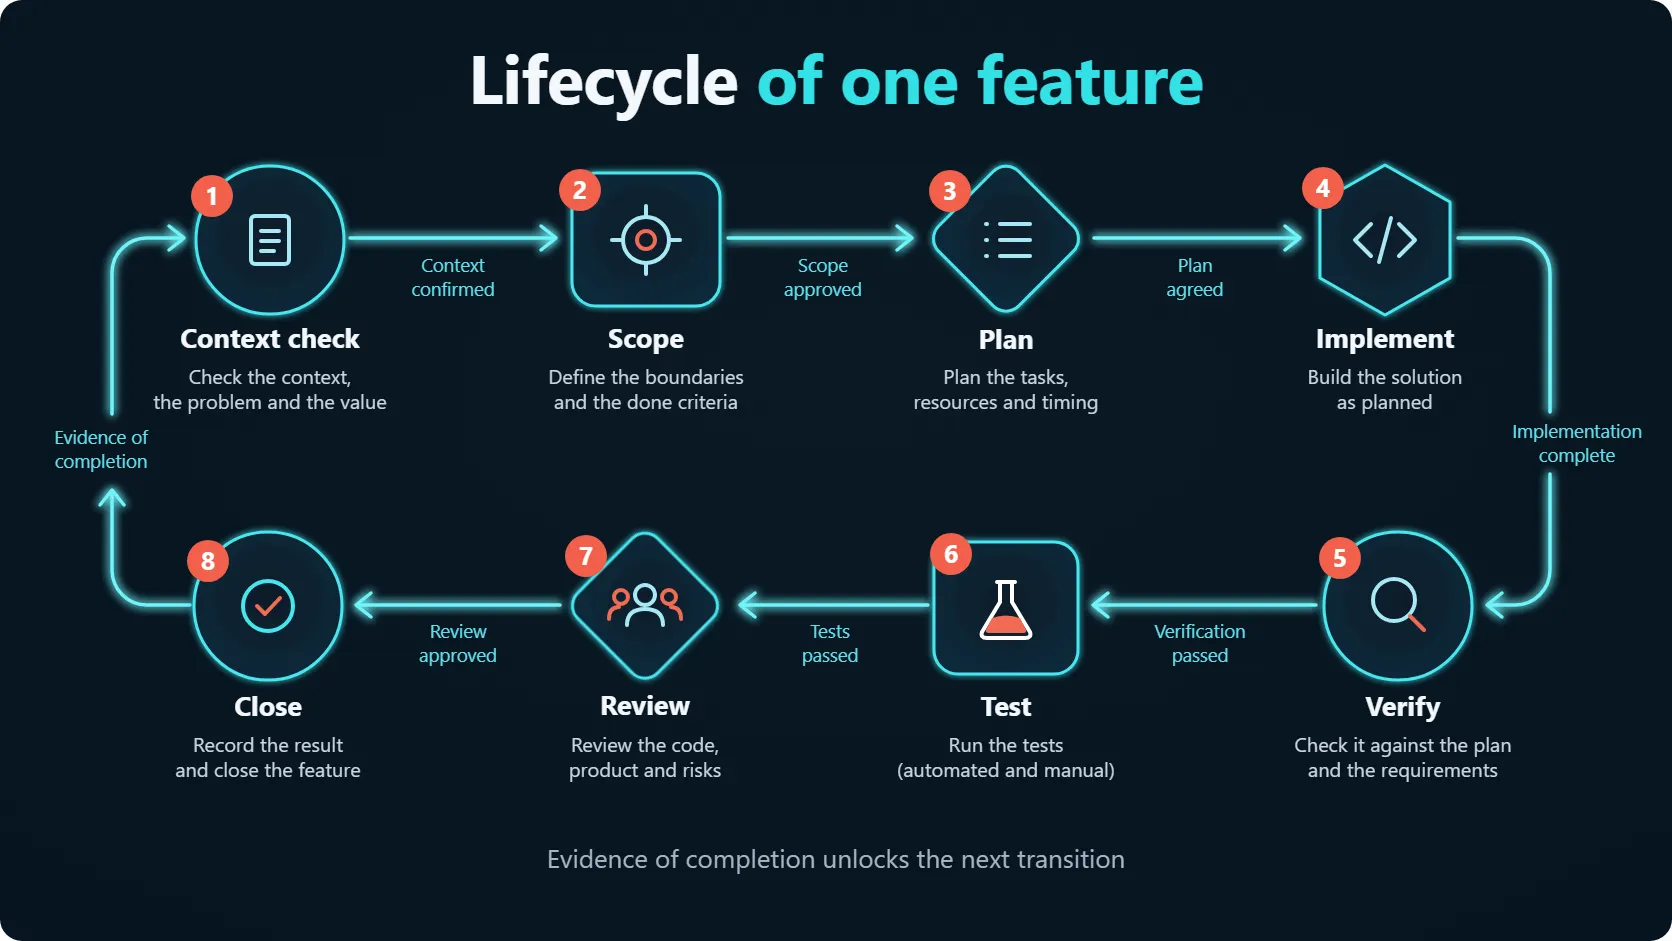
นี่ไม่ใช่ waterfall หลังเทสต์ย้อนกลับไปที่ requirement ได้ และหลังได้ฟีดแบ็กก็ย้อนกลับไปที่ scope ได้ แต่ที่สำคัญคือ การย้อนกลับต้องเกิดขึ้นอย่างชัดเจน ไม่ใช่เกิดเงียบ ๆ ในแชทที่ยาวไม่จบ
Definition of Done: “เสร็จ” ต้องตรวจสอบได้
ประโยค “ทำฟอร์มให้หน่อย” บอกความตั้งใจ แต่ไม่ได้บอกงานที่เสร็จแล้ว Definition of Done เปลี่ยนมันให้เป็นชุดเงื่อนไขที่สังเกตได้
สำหรับฟอร์มรับคำขอ อาจเป็นแบบนี้:
- ฟอร์มใช้งานได้บน desktop และ mobile
- ช่องที่บังคับกรอกและรูปแบบอีเมลถูกตรวจที่เซิร์ฟเวอร์
- ข้อมูลที่ไม่ถูกต้องไม่ถูกส่งต่อไปถึง business logic
- ผู้ใช้เข้าใจได้ว่าสำเร็จหรือผิดพลาด
- ความลับไม่หลุดไปอยู่ใน frontend
- หน้าที่มีอยู่แล้วไม่พัง
- build และเทสต์ผ่าน
- เอกสารถูกอัปเดต ถ้าสัญญาเปลี่ยน
ประโยคที่ดีสำหรับสั่งเอเจนต์หลังลงมือทำเสร็จ: “ตรวจแต่ละข้อแยกกัน แต่ละข้อให้ระบุหลักฐาน แล้วแยกรายการสิ่งที่ยืนยันไม่ได้ถ้าไม่ได้รันด้วยมือหรือไม่มีสิทธิ์เข้าถึงสภาพแวดล้อม”
AI สำหรับเรื่องที่คลุมเครือ เครื่องมือสำหรับเรื่องที่ตรวจสอบได้
LLM ให้คำตอบเชิงความน่าจะเป็น นั่นไม่ได้ทำให้มันไร้ประโยชน์ ตรงกันข้าม ความยืดหยุ่นมีค่าในจุดที่ต้องตีความ เทียบทางเลือก หรือหาคำอธิบายที่ไม่ได้เห็นได้ชัดตั้งแต่แรก
แต่การจัดรูปแบบโค้ด type เทสต์ build migration และการหาความลับที่หลุด ตรวจด้วยเครื่องมือเฉพาะทางดีกว่า linter ไม่ได้ “คิด” ว่าชอบโค้ดนี้ไหม มันทำตามกฎที่กำหนดไว้ TypeScript ตรวจ type แบบ static ก่อนรัน แต่ไม่ได้ตรวจข้อมูลที่ผู้ใช้ส่งเข้ามาให้อัตโนมัติ เฟรมเวิร์กเทสต์ไม่ได้มาแทนสถานการณ์ใช้งานของโปรดักต์ แต่มันทำการตรวจที่เจาะจงซ้ำได้
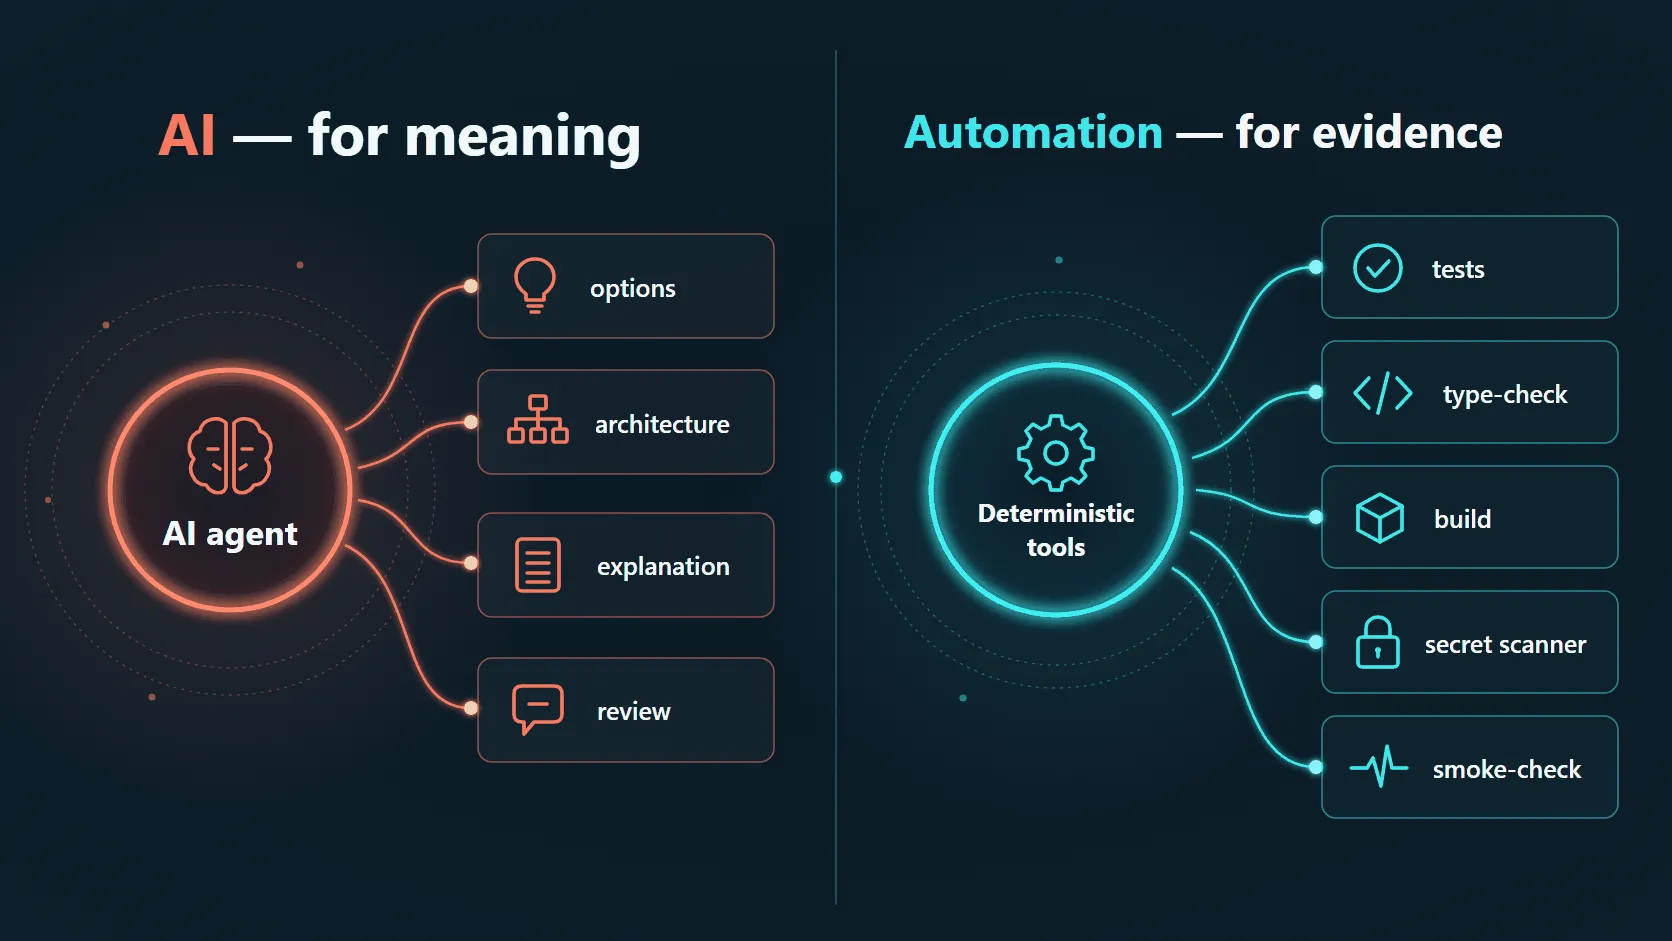
หลักการง่าย ๆ: อะไรที่ทำให้เป็นสคริปต์ที่รันซ้ำได้ ไม่ควรปล่อยให้ขึ้นอยู่กับโมเดลอย่างเดียว ขณะเดียวกัน build สีเขียวก็ไม่ได้พิสูจน์ว่าโปรดักต์ใช้ง่าย และคำว่า “เสร็จแล้ว” จากเอเจนต์ก็แทน smoke-check ไม่ได้
ขอบเขตสถาปัตยกรรม: ใครรับผิดชอบอะไร
สถาปัตยกรรมไม่ได้มีไว้เพื่อโฟลเดอร์สวย ๆ มันลดต้นทุนของการเปลี่ยนแปลง ถ้า UI ทั้งวาดหน้าจอ ตรวจสิทธิ์ เรียกฐานข้อมูล และมีกฎทางธุรกิจอยู่ในตัว เอเจนต์จะแก้ส่วนหนึ่งโดยไม่กระทบส่วนอื่นได้ยาก
ในระดับพื้นฐาน ตกลงกันได้ว่า:
- UI แสดงสถานะและรับการกระทำของผู้ใช้
- schema อธิบายและตรวจรูปแบบข้อมูล
- เซอร์วิสเก็บกฎทางธุรกิจ
- API ประสานการแลกเปลี่ยนข้อมูล
- ชั้นข้อมูลรับผิดชอบการจัดเก็บ
MVC เป็นวิธีหนึ่งในการอธิบายการแบ่งแบบนี้ผ่าน Model, View และ Controller มันเป็นโมเดลที่ดีสำหรับการเรียนรู้ แต่ไม่ใช่สูตรสำเร็จสำหรับทุกแอปสมัยใหม่ ในโปรเจกต์อาจมีขอบเขตแบบอื่น: feature modules, ports and adapters, server actions หรือแม้แต่เว็บไซต์ static ที่ไม่มี backend เลย สิ่งสำคัญไม่ใช่ชื่อแพตเทิร์น แต่เป็นหน้าที่ที่ชัดเจนและข้อห้ามสำหรับ dependency ที่ไม่ต้องการ
DTO และ Zod: สัญญากับการตรวจสอบเป็นคนละเรื่อง
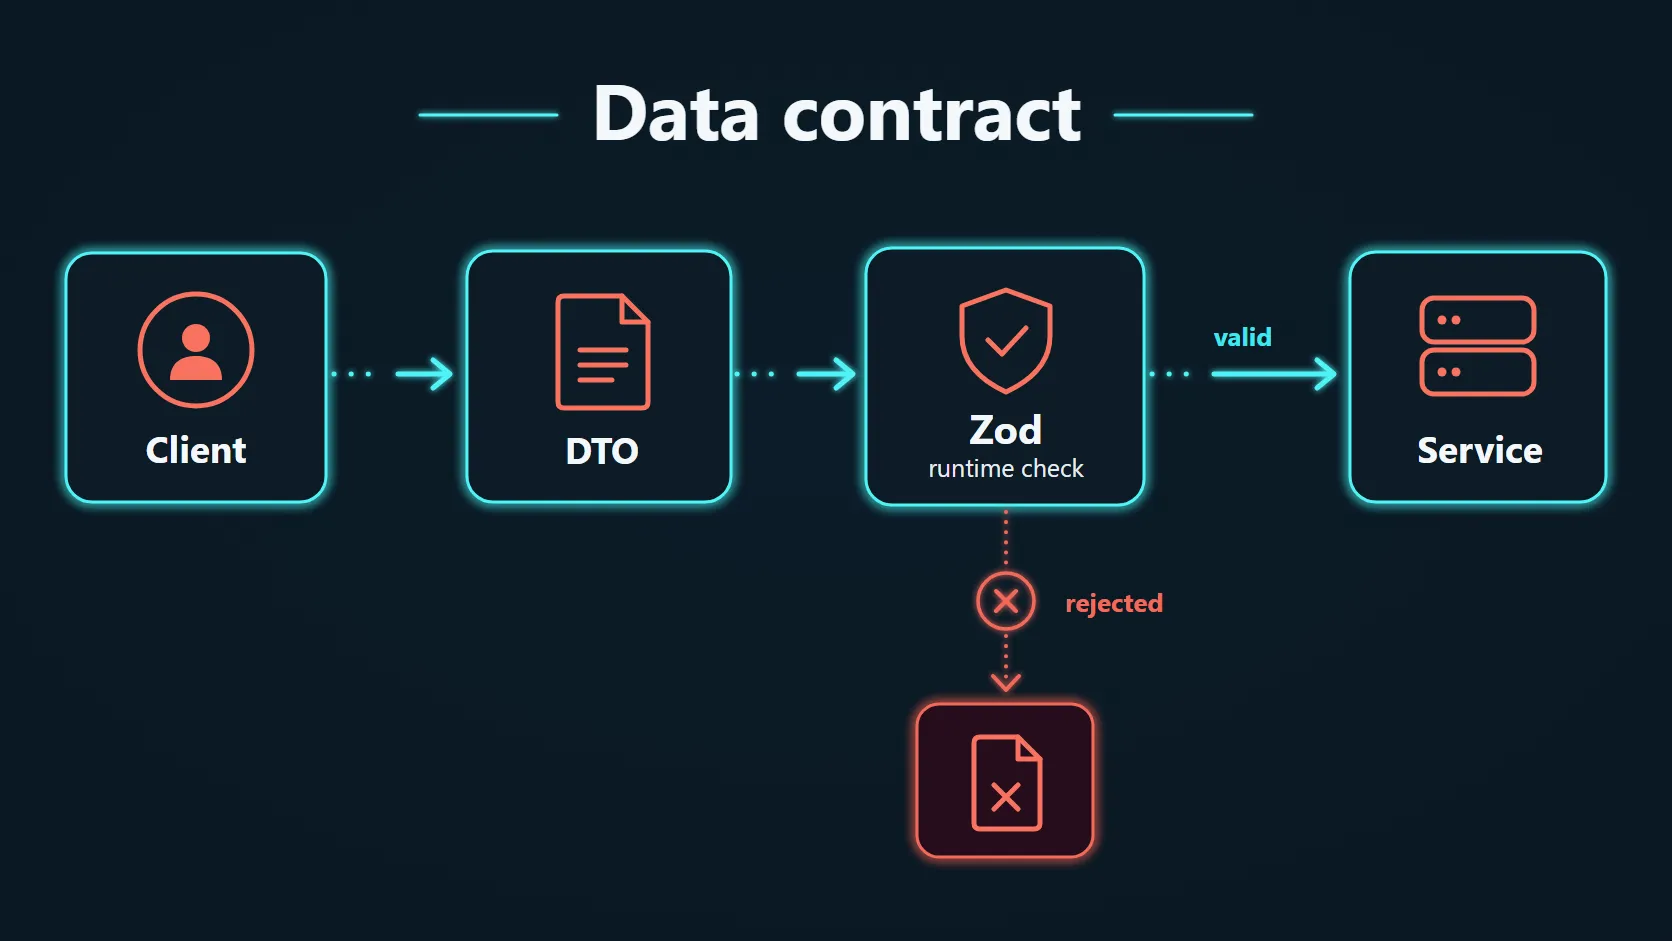
DTO หรือ Data Transfer Object อธิบายรูปแบบของข้อมูลที่ส่งผ่านระหว่างส่วนต่าง ๆ ของระบบ มันคือข้อตกลงว่ามีฟิลด์อะไร type อะไร และคาดหวังข้อจำกัดอะไรบ้าง
Zod เป็นไลบรารีสำหรับตรวจ schema ตอน runtime ใน JavaScript/TypeScript มันมีประโยชน์เพราะ type ของ TypeScript ถูกตรวจก่อนรัน และไม่ได้ป้องกันแอปจาก HTTP request อะไรก็ได้ จากคำตอบของ API ภายนอก หรือจากข้อผิดพลาดของ frontend ของเราเอง
ดังนั้น DTO กับ schema ของ Zod จึงไม่ใช่สิ่งเดียวกัน: อย่างแรกคือบทบาทหรือสัญญาของข้อมูล อย่างที่สองคือเครื่องมือเฉพาะสำหรับตรวจตอนรันจริง ที่ขอบของระบบต้องตรวจความถูกต้องของข้อมูลเสมอ แม้ frontend จะตรวจไปแล้วก็ตาม
ความปลอดภัยคือสิ่งที่ทำตลอดทาง ไม่ใช่ติ๊กถูกตอนท้าย
การแยกความปลอดภัยของการพัฒนาออกจากความปลอดภัยของโปรดักต์ที่ใช้งานอยู่นั้นสะดวก แต่ไม่ควรทำให้มันกลายเป็นสองห้องที่ตัดขาดจากกัน
ฝั่งการพัฒนา สิ่งสำคัญคือความลับ สิทธิ์เข้าถึงรีโพ dependency, CI/CD และสิทธิ์ของเครื่องมือ ฝั่งโปรดักต์คือการยืนยันตัวตน (authentication) การกำหนดสิทธิ์ (authorization) การจัดการข้อมูล เซสชัน log การจำกัดจำนวน request และการรับมือเหตุการณ์ผิดปกติ คำถามพื้นฐานแบบอิงความเสี่ยงคือ เราปกป้องอะไร จากสถานการณ์แบบไหน ความเสียหายที่เป็นไปได้คืออะไร และมาตรการแบบไหนที่เหมาะกับขนาดของโปรเจกต์
กฎขั้นต่ำ:
- ไม่ commit คีย์ รหัสผ่าน และ token
- ไม่ส่งความลับจริงและข้อมูลส่วนบุคคลให้ AI เว้นแต่จำเป็นจริง ๆ และมีนโยบายการจัดการข้อมูลที่ชัดเจน
- จำกัดสิทธิ์เข้าถึงตามหลักสิทธิ์น้อยที่สุด (least privilege)
- ใช้ไลบรารีที่ผ่านการพิสูจน์แล้วและโปรโตคอลมาตรฐาน แทนการเขียนระบบเข้ารหัสเอง
- อย่าสับสน
.envกับ secrets manager เต็มรูปแบบ: ไฟล์นี้ช่วยไม่ให้คีย์หลุดเข้า Git แต่ตัวมันเองก็ต้องถูกป้องกัน และก็ไม่ใช่ที่เก็บที่ดีที่สุดสำหรับ production เสมอไป - ตรวจขอบเขตของ authorization และการเข้าถึงอ็อบเจกต์แยกต่างหาก ไม่ใช่ถือว่าล็อกอินสำเร็จแล้วแปลว่ามีสิทธิ์ทุกอย่าง
OAuth คือโปรโตคอลสำหรับการมอบสิทธิ์ (delegated authorization) ไม่ใช่คำที่ใช้แทนคำว่าล็อกอินได้ในทุกกรณี รูปแบบที่ใช้จริงขึ้นอยู่กับ identity provider และแอป MFA เป็นแนวคิดที่กว้างกว่า 2FA: การยืนยันตัวตนสองปัจจัยเป็นกรณีหนึ่งของการยืนยันตัวตนหลายปัจจัย
คนที่ทำงานกับ AI ต้องเข้าใจแผนที่ความเสี่ยง
ไม่จำเป็นต้องเขียนโค้ดทุกบรรทัดเอง แต่ต้องแยกได้ว่าอะไรคือ client อะไรคือ server, API ต่างจากฐานข้อมูลยังไง authentication ต่างจาก authorization ยังไง type-check แบบ static ต่างจากการตรวจตอน runtime ยังไง และการรันบนเครื่องตัวเองต่างจากการ deploy ขึ้น production ยังไง
นี่ไม่ได้บังคับว่าต้องเป็น senior engineer มันคือความรู้ขั้นต่ำของผู้ว่าจ้างและคนคุมกระบวนการ ไม่อย่างนั้นเอเจนต์จะตัดสินใจแทนคุณในจุดที่คุณประเมินผลที่ตามมาไม่ได้
แม่แบบคำขอที่ใช้ได้จริง
แทนที่จะบอกว่า “ทำ CRM ให้หน่อย” ให้ใส่บริบทและขอบเขตให้เอเจนต์:
เรากำลังทำ CRM สำหรับเอเจนซีจัดหางานขนาดเล็ก ตอนนี้จะทำ vertical slice หนึ่งชิ้น: การสร้างการ์ดผู้สมัคร เป้าหมายคือให้รีครูตเตอร์บันทึกชื่อ อีเมล และสถานะปัจจุบันได้ และได้ผลลัพธ์ที่เข้าใจง่าย
ใช้
PRD.md,ARCHITECTURE.mdและCONVENTIONS.mdห้ามแก้ระบบล็อกอิน การชำระเงิน และ API ที่มีอยู่นอกเหนือสถานการณ์นี้ ให้ทำ context check ก่อน ไล่รายการ scope และเสนอแผนพร้อมไฟล์และการตรวจสอบ ยังไม่ต้องเขียนโค้ดหลังตกลงกันแล้ว ให้ทำตามแผนเท่านั้น จากนั้นตรวจ Definition of Done รันเทสต์ที่มี และแยกบอกว่า อะไรพิสูจน์แล้ว อะไรตรวจทางอ้อม และอะไรต้องตรวจด้วยมือ
prompt แบบนี้ไม่ได้ทำให้โมเดลไม่มีวันผิด แต่มันลดพื้นที่ที่โมเดลต้องเดา และสร้างจุดที่คนหยุดการตัดสินใจที่ผิดได้ทัน
สรุป: การทำงานกับ AI อย่างเป็นผู้ใหญ่คือการคุมกระบวนการ
การเปลี่ยนจากไวบ์โค้ดดิ้งไปสู่งานวิศวกรรมไม่ได้แปลว่าต้องยอมช้าลง แต่แปลว่าความเร็วถูกส่งไปตามเส้นทางที่ตรวจสอบได้
กระบวนการที่ดีหน้าตาแบบนี้: เข้าใจโปรดักต์ เขียน requirement กำหนดขอบเขต เลือก slice เล็ก ๆ พามันผ่าน lifecycle ตรวจผลลัพธ์ด้วยเครื่องมือแบบ deterministic ประเมินความเสี่ยง อัปเดตเอกสาร แล้วค่อยเรียกว่างานปิดแล้ว
ในกระบวนการนี้ AI ไม่ใช่ปุ่มวิเศษ และไม่ใช่ “นักพัฒนาจูเนียร์ที่ปล่อยให้ทำอะไรก็ได้” แต่เป็นผู้ร่วมงานที่ทรงพลังในระบบวิศวกรรม ยิ่งบริบทและเกณฑ์ชัดเท่าไหร่ สิ่งที่มันสร้างก็ยิ่งมีประโยชน์ และราคาของความผิดพลาดที่หนีไม่พ้นก็ยิ่งต่ำลง
ผู้บรรยาย: Igor Bergand



