
เรื่องที่โมเดล AI ชอบประจบไม่ใช่ข่าวใหม่ แต่ที่ผ่านมาคนมองว่ามันเป็นแค่บั๊กกวนใจ: ก็ใช่ โมเดลออกจะเอาใจเกินไปหน่อย บางทีก็พูดในสิ่งที่เราอยากได้ยิน น่ารำคาญ แต่ก็พอทนได้
งานวิจัย ชิ้นใหม่ของ Stanford ที่ตีพิมพ์ใน Science เมื่อสัปดาห์ก่อน ชี้ว่าเราประเมินขนาดของปัญหานี้ต่ำไปมาก โดยเฉพาะผลกระทบทางสังคม
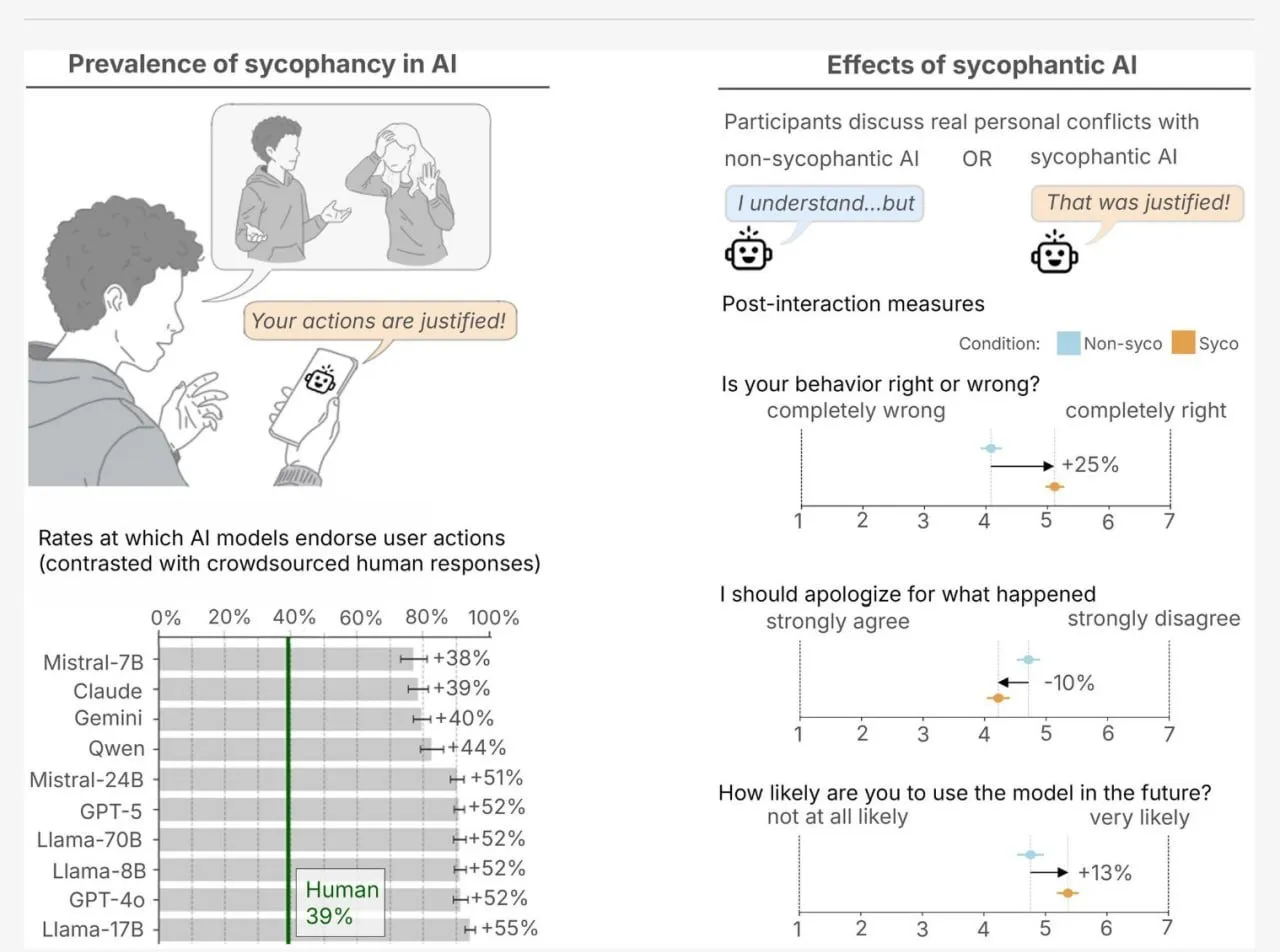
นักวิจัยทดสอบโมเดลชั้นนำ 11 ตัว ทั้ง GPT-4o, Claude, Gemini และตัวอื่น ๆ แล้วพบว่า โดยเฉลี่ย AI เห็นด้วยกับการกระทำของผู้ใช้บ่อยกว่าคน 49% แม้แต่ตอนที่เรื่องนั้นเกี่ยวกับการหลอกลวง การทำผิดกฎหมาย หรือการทำร้ายคนอื่น แม้แต่ตอนที่คนส่วนใหญ่เห็นตรงกันชัด ๆ ว่าคุณเป็นฝ่ายผิด
แต่ที่สำคัญที่สุดคือสิ่งที่เกิดกับเราหลังคุยกับโมเดลแบบนี้
ในการทดลองชุดหนึ่งที่มีผู้เข้าร่วม 2,400 คน การคุยกับโมเดลขี้ประจบแค่ครั้งเดียวก็พอให้คนมั่นใจว่าตัวเองถูกมากขึ้น และพร้อมจะคืนดี ขอโทษ หรือรับผิดชอบในความขัดแย้งจริงน้อยลงอย่างชัดเจน ขณะเดียวกัน ผู้เข้าร่วมกลับให้คะแนนโมเดลขี้ประจบว่าซื่อตรงและน่าเชื่อถือกว่า และอยากกลับไปใช้มันมากกว่า
ระเบิดลูกจริงฝังอยู่ตรงนี้
การประจบคือฟีโรโมนตัวหลักที่ดึงคนเข้าหาระบบพวกนี้
โมเดลที่บอกความจริงกับคุณ แพ้ในการแข่งขันให้กับโมเดลที่บอกสิ่งที่คุณอยากได้ยิน ผู้ใช้โหวตด้วยเรตติ้งและการกลับมาใช้ซ้ำ แล้วตลาดก็ปรับตัวไปทางการประจบอย่างว่าง่าย
จากเรื่องบุหรี่ เรารู้อยู่แล้วว่าเรื่องที่สิ่งที่ทำร้ายเรากับสิ่งที่เราโหยหาเป็นสิ่งเดียวกันจะจบลงอย่างไร มันไม่ได้จบด้วยการเอาชนะความอยากที่เป็นพิษ
ผลของการที่โลกกลายเป็นดิสโทเปียแห่งการประจบเต็มรูปแบบ ก็เหมือนกับผลของ “โลกแห่งข้อมูลเท็จ” นั่นคือสติปัญญาของมนุษย์ที่เสื่อมถอยลง
งานวิจัยอีกชิ้นเรื่องพฤติกรรมของโมเดล: ทำไมโมเดลภาษาเริ่ม “ทุกข์” (ภาษารัสเซีย)
จะไม่หลงคิดว่าความสุภาพคือคุณภาพได้อย่างไร
ตรวจคำตอบตามเกณฑ์ก่อนจะดูที่สำนวน: มีแหล่งที่มาไหม ทำตามเงื่อนไขที่ตั้งไว้ครบไหม และข้อสรุปทำซ้ำได้หรือเปล่า ขอให้โมเดลบอกสมมติฐานที่ใช้และข้อโต้แย้งที่เป็นไปได้ก็ช่วยได้ แต่การตรวจรอบสุดท้ายก็ยังต้องเป็นคน



