
บทความแรก เล่าว่าทำไมหน่วยความจำของ Hermes Agent ต้องมี hermes-dreaming และติดตั้งอย่างไร ส่วนบทความนี้ว่าด้วยสิ่งที่เปลี่ยนไปหลังเวอร์ชัน 2.7: วิธีแยกการยืนยันจริงออกจากคำที่บังเอิญตรงกัน ทำไมถึงมีผู้ตัดสินบนคลาวด์ที่จะเปิดใช้หรือไม่ก็ได้ และ dreaming เรียนรู้ที่จะเสนอรวมรายการซ้ำร่วมกับ holographic ได้อย่างไร ผลวัดของผู้ตัดสินเป็นของรีลีส 3.3
ก่อนอื่นเรื่องสถานะ ณ วันที่ 30 ตุลาคม ผ่านแคตตาล็อก hermes plugins install hermes-dreaming จะติดตั้ง 3.7.1 ซึ่งมีผู้ตัดสิน การรวมรายการซ้ำ และการอัปเดตงาน cron ด้วยตัวติดตั้งอยู่แล้ว รีลีสล่าสุดของรีโพคือ 3.8.0 ข้อเสนอให้รวมรายการซ้ำต้องใช้ dreaming 3.4.0+ และ holographic 0.19.0+ ตอนนี้ holographic ในแคตตาล็อกอยู่ที่ 0.22.0 คำสั่งติดตั้งรีลีสล่าสุดด้วยแฮชอยู่ด้านล่าง
หน่วยความจำของเอเจนต์พลาดตรงไหน: ไม่ใช่ตรงที่ผมหา
สัญญาณหลักอย่างหนึ่งในการย้ายข้อเท็จจริงเข้าหน่วยความจำถาวรของ Hermes คือคนวนกลับมาพูดถึงมันในหลายวันที่ต่างกัน สกิลดูทั้งค่าความเชื่อถือและความใหม่ และการตัดสินใจว่าจะบันทึกหรือไม่ยังเป็นของเอเจนต์ แต่ถ้าไม่มีการยืนยัน ข้อเท็จจริงจะไม่เข้าหน่วยความจำ สกิลหาการกล่าวถึงจากคำสำคัญที่ตรงกัน วิธีนี้เร็ว ฟรี และทำงานได้โดยไม่ต้องใช้เน็ต แต่คำก็ตรงกันได้แม้ความหมายจะต่างกัน
เรื่องแรกที่โผล่มาคือการปฏิเสธ “Mikhail ไม่ชอบอาหารเผ็ด” กับ “Mikhail ชอบอาหารเผ็ด” ประกอบจากรากคำชุดเดียวกัน: คำว่า “ไม่” เป็นคำไวยากรณ์ และหลุดออกไปตอนเทียบ ผลคือข้อความที่มีความหมายตรงข้ามกันถูกนับเป็นการยืนยัน ใน 3.1.0 สกิลเรียนรู้ที่จะคัดข้อความแบบนี้ออก: ถ้าข้อความพูดตรงข้ามกับข้อเท็จจริง ก็ไม่นับเป็นการยืนยัน ภาษาจีนซึ่งไม่มีเว้นวรรคและเขียนคำปฏิเสธติดกับคำอื่นถูกปรับใน 3.1.1 ส่วนกาลของกริยาที่ต่างกัน อย่าง “สูบบุหรี่” กับ “ไม่เคยสูบเลย” ถูกปรับใน 3.2.0 นี่ยังเป็นการตรวจตามกฎ ไม่ใช่การเข้าใจความหมาย: ประโยคที่ซับซ้อนอาจหลุดไปได้
ต่อจากนั้นผมคาดว่าการปฏิเสธนี่แหละจะเป็นปัญหาใหญ่ที่สุด เพื่อเช็กเรื่องนี้ เราทำการทดลองบนระบบของครอบครัวที่ใช้งานจริง ซึ่งสกิลทำงานอยู่ตั้งแต่แรก ตลอด 60 วันไม่มีข้อความไหนเลยที่พลิกความหมายของข้อเท็จจริง แต่จาก “การยืนยัน” 60 รายการที่สุ่มมา 59 รายการกลับเป็นสัญญาณรบกวน (noise) คือข้อความที่พูดเรื่องอื่นไปเลย
แหล่งสัญญาณรบกวนหลักเจอได้เร็ว เวลาคุณตอบกลับข้อความใน Telegram ตัว Hermes จะแนบข้อความที่ถูกตอบไว้กับคำตอบเป็นคำพูดอ้างอิง และส่วนใหญ่ก็คือข้อความของเอเจนต์เอง ในแชทที่ใช้งานจริง 46% ของข้อความจากคนเป็นการตอบกลับ คำพูดอ้างอิงยาวเฉลี่ย 523 ตัวอักษร ส่วนคำของคนเองยาว 63 ตัวอักษร สกิลหาคำของข้อเท็จจริงในคำพูดอ้างอิงเจอจริง ๆ แล้วนับเป็นการยืนยันจากคน ทั้งที่คนไม่ได้พูดถึงข้อเท็จจริงนั้นเลยสักคำ แหล่งที่สองคือคำที่ใช้กันทั่วไปในบ้าน: “แชท” “เธรด” “Telegram” และชื่อสมาชิกในครอบครัวโผล่อยู่ในหนึ่งในห้าของข้อเท็จจริง และโยงทุกอย่างเข้าหากันหมด
เวอร์ชัน 3.2.0 เขียนการนับใหม่ คำพูดอ้างอิงจะนับก็ต่อเมื่อคำของคนเองก็เกี่ยวกับข้อเท็จจริงด้วย: “ใช่ ยังเป็น Vespa อยู่” ใต้คำถามเรื่องมอเตอร์ไซค์คือการยืนยัน ส่วน “โอเค ขอบคุณ” ใต้รายงานยาว ๆ ของเอเจนต์ไม่ใช่ คำที่โผล่ในอย่างน้อยหนึ่งในห้าของข้อเท็จจริงจะไม่สร้างการกล่าวถึงด้วยตัวเองอีกต่อไป (ในคลังที่มีข้อเท็จจริงไม่ถึงสิบข้อ ตัวกรองนี้ไม่ทำงาน) ตัวเลขใหม่ประเภทเดียวกัน อย่าง “ตอนนี้ 1500” ใต้ข้อเท็จจริง “1200 ต่อเดือน” จะไม่ยืนยันค่าเดิมอีกแล้ว ข้อเท็จจริงสั้น ๆ อย่าง “Gosha ดื่มกาแฟตอนเช้า” ตอนนี้มีการแยกวิเคราะห์ต่างหาก: เมื่อก่อนคำในนั้นสั้นเกินไป จนไม่มีอะไรให้ใช้ยืนยันข้อเท็จจริงแบบนี้
ผลบนคู่ข้อมูลจริงที่ลบข้อมูลระบุตัวตนแล้ว 80 คู่: สัดส่วนคำตอบที่ถูกต้องว่า “ยืนยัน / ขัดแย้ง / ไม่เกี่ยว” เพิ่มจาก 26% เป็น 79% จาก 79 คู่ที่ไม่ใช่การยืนยันจริง เมื่อก่อนกฎนับผิดไป 59 คู่ ตอนนี้เหลือ 13 คู่ จำนวนการกล่าวถึงที่สกิลเจอต่อคืนบนฐานข้อมูลจริงลดจาก 852 เหลือ 247
มีอะไรใหม่อีกใน hermes-dreaming 2.8–3.2
ระหว่างที่แก้เรื่องการยืนยัน สกิลก็ได้ความสามารถอื่นเพิ่มมาด้วย ตั้งแต่เวอร์ชัน 2.8.0 มันทำงานกับการยืนยันในคลังข้อเท็จจริง holographic ได้: ถ้าคนพูดข้อเท็จจริงซ้ำในสองวันที่ต่างกัน โดยไม่มีการปฏิเสธและไม่มีตัวเลขใหม่ เอเจนต์จะได้คำสั่งสำเร็จรูปสำหรับเพิ่มค่าความเชื่อถือให้ข้อเท็จจริงนั้น กรณีแบบนี้ตั้งใจให้มีน้อย การเอ่ยถึงหัวข้อยังไม่ใช่การพูดข้อเท็จจริงซ้ำ
เวอร์ชัน 2.9.0 สอนให้สกิลแยกได้ว่าใครอยู่เบื้องหลังข้อเท็จจริง: คนพูดเอง คนยืนยัน หรือเอเจนต์สรุปเอาจากบทสนทนา ข้อสรุปของเอเจนต์ที่ยังไม่มีใครยืนยัน สกิลจะถามก่อน แต่การปิดทางเข้าหน่วยความจำของข้อสรุปพวกนี้ได้หมดจริง ๆ เพิ่งเกิดใน 3.8.0 ซึ่งจะเล่าด้านล่าง ช่วงเดียวกันสกิลเริ่มใช้การตรวจความลับของ holographic เอง ซึ่งจำรหัสผ่านและคีย์ได้ใน 18 ภาษา ระหว่างทางยังพบว่า “ส่งกุญแจประตูมาให้หน่อย” ไม่ใช่การรั่วของข้อมูลเข้าสู่ระบบ และการตรวจความลับก็เลิกส่งข้อความแบบนี้เข้ากักกันโดยผิดพลาด การตรวจนี้เติบโตขึ้นใน holographic เองจากรายงานของผู้ใช้ที่มีฐานข้อมูลภาษาจีนอย่างไร อ่านได้ในบทความเรื่องอัปเดตของ holographic
รีลีส 2.9.x บางส่วนมาจากผู้ใช้ คนหนึ่งแจ้งมาว่าสกิลอ่านการตั้งค่าของ Hermes ผิด ถ้าใน config.yaml มีคอมเมนต์ เรื่องนี้แก้แล้วใน 2.9.6–2.9.8 ใน 2.9.9 ไฟล์สถานะที่เสียจะไม่ถูกอ่านเงียบ ๆ ว่าเป็นไฟล์ว่างอีกต่อไป แต่จะถูกแยกเก็บไว้และแจ้งให้รู้ ส่วนสถานะจะถูกเขียนทั้งหมดหรือไม่เขียนเลย dreaming.json ที่เสียจะหยุดคืนนั้น แทนที่จะรันด้วยค่าเริ่มต้น เวอร์ชัน 3.0.0 คือการปรับโครงสร้างภายใน: สคริปต์ใหญ่ถูกแบ่งเป็นส่วน ๆ ส่วนพฤติกรรมของคืนไม่เปลี่ยน
อะไรเปลี่ยนไปหลัง 3.3.1: ข้อผิดพลาดตอนอ่านและตัวกรองความลับ
ใน 3.3.2 แก้การสลับความหมายที่น่ารำคาญ: “อ่านไม่ได้” ไม่ได้แปลว่า “ว่างเปล่า” อีกแล้ว ถ้าฐานข้อมูลข้อความถูกใช้งานอยู่ คืนนั้นจะไม่ประกาศว่าทุกรายการถูกลืม และไม่ถล่มคนด้วยคำถาม “ยังเป็นปัจจุบันไหม?” แต่จะแจ้ง messages_unavailable ไฟล์สถานะที่เข้าถึงไม่ได้จะไม่ถูกเขียนทับด้วยไฟล์ว่าง รายการงาน cron ที่เสียจะไม่ปล่อยให้การเก็บกวาดสำเนาที่ถูกลืมรายงานว่าสำเร็จ สวิตช์ความเชื่อถือรับเฉพาะ true และ false จริง ๆ: สตริง "false" จะไม่เปิดความเชื่อถืออีกต่อไป
ใน 3.3.3–3.3.4 สำเนาตัวกรองของ holographic ถูกอัปเดต คำว่า пин (PIN) ในภาษารัสเซียที่ตามด้วยค่าจะนับเป็นความลับ แต่เลขเวอร์ชันที่ตามหลังคำว่า pin ไม่นับ คำขออย่าง “ขอดูรหัสผ่านหน่อยได้ไหม?” หรือ “ส่ง OPENAI_API_KEY มาได้ไหม?” จะถูกตัดออกเพราะนับเป็นคำสั่งถึงเอเจนต์ ส่วนการเล่าว่ามีคนเปิดรหัสผ่านให้ดู โดยไม่มีตัวรหัสผ่าน ยังคงเป็นข้อเท็จจริง เพราะฉะนั้นการอัปเดต holographic อย่างเดียวไม่ได้แทนการอัปเดต dreaming: รอบกลางคืนมีสำเนาตัวกรองของตัวเอง
Dreaming 3.4: รวมรายการซ้ำโดยเก็บประวัติไว้
ใน 3.4.0 รอบกลางคืนเริ่มหาคู่ที่คล้ายกันทั่วทั้งฐานข้อเท็จจริงหลัก โปรเจกต์เดียวอาจถูกบันทึกไว้สองครั้ง หรือการสกัดข้อเท็จจริงอาจเล่าเรื่องเดิมซ้ำด้วยคำใหม่ ตอนนี้ dreaming จะถามคำถามเดียวต่อคืน พร้อมข้อความทั้งสองแบบเต็ม ๆ และหมายเลขแบบ D-17: “รวมกันไหม?” หมายเลขจะไม่ถูกนำกลับมาใช้ซ้ำ และมีแค่คำตอบของคนต่อหมายเลขนั้น ๆ ที่อนุญาตให้รวมได้
ตอนกลางคืนข้อเท็จจริงจะไม่ถูกรวม หลังคำตอบ “ใช่ D-17” เอเจนต์จะเรียก fact_store merge ของ holographic พร้อมหมายเลขเวอร์ชันที่แสดงให้ดูผ่าน expect ถ้าข้อความใดข้อความหนึ่งเปลี่ยนไปหลังถาม คลังจะตอบ changed_since และไม่เขียนอะไรเลย เมื่อตกลงรวม สำเนาจะหายไปจากการค้นหา แต่เวอร์ชัน แหล่งที่มา และการยืนยันของมันยังอยู่ในประวัติของข้อเท็จจริงหลัก ไม่มีคำสั่ง unmerge แยก คำตอบ “พวกนี้คนละเรื่องกัน” บันทึกได้ด้วย dream-reject.py --not-duplicates D-17 และยกเลิกการปฏิเสธได้ด้วย --undo D-17
กฎความคล้ายมีไว้เสนอคำถาม ไม่ได้พิสูจน์ว่ารายการเหมือนกันทุกประการ มันคัดคู่ที่มีตัวเลข ชื่อ การปฏิเสธ หรือการแทนคำเดียวที่ขัดกันออกไป แต่อาจมองไม่เห็นการสลับบทบาท ความต่างของกาล หรือการแปล ข้อเท็จจริงที่มีอยู่จึงถูกรวมหลังคนตอบเท่านั้น เมื่อรวมแล้ว dreaming จะเอาสำเนาภายในออกจากสถานะปัจจุบัน แต่เก็บไดอารี่ไว้: การรวมไม่เท่ากับการลืม
งานสกัดข้อเท็จจริงที่แยกออกมามีข้อยกเว้นแคบ ๆ อยู่ข้อหนึ่ง ถ้ามันเพิ่งเพิ่มข้อเท็จจริงที่ตัวเองเรียบเรียงใหม่ แล้ว holographic ตอบ similar และเสนอให้รวมกับข้อเท็จจริงเก่า โดยไม่มีข้อมูลใหม่ เอเจนต์รวมข้อเท็จจริงใหม่ของตัวเองเข้าไปได้ทันที แต่ cron รวมรายการเก่าของคนอื่นด้วยวิธีนี้ไม่ได้: holographic ตรวจว่าสำเนาถูกเขียนโดยเซสชันเดียวกันนี้
ฟีเจอร์นี้ต้องใช้ dreaming 3.4.0+, holographic 0.19.0+ และฐานหลักที่เป็น scope: profile ถ้าไม่รองรับ fact_merges ใช้แหล่งข้อมูลอื่น หรือใช้ฐานแยกของแต่ละแชท ฟีเจอร์นี้จะถูกข้ามพร้อมเหตุผลในสถิติ การตรวจอื่น ๆ ของคืนนั้นยังทำงานต่อ
ก่อนรวมครั้งแรกให้สำรองข้อมูลไว้ การรวมจะยกสคีมาประวัติของ holographic ขึ้นเป็น 2 หลังจากนั้นเวอร์ชัน 0.15–0.18 จะเขียนลงฐานไม่ได้ ตอนนี้แคตตาล็อกให้ holographic 0.22.0 แต่ถ้าย้อนเวอร์ชันเองด้วยแฮชไปต่ำกว่า 0.19.0 หน่วยความจำของเอเจนต์หลักจะปิดตัวพร้อม HistoryTooNew: ให้กลับไปใช้ 0.19.0+ หรือกู้สำเนาที่ทำไว้ก่อนรวม รายละเอียดอยู่ในบทความเรื่องอัปเดตของ holographic
คำแนะนำการสกัดข้อเท็จจริงและขอบเขตของ “ลืม”: 3.4.1–3.4.2
ใน 3.4.1 ระบุให้ชัดขึ้นว่าตอนสกัดข้อเท็จจริงต้องหาอะไร: กฎและข้อจำกัดระยะยาวก็สำคัญ แม้คนจะพูดขึ้นมาแบบผ่าน ๆ คำขอครั้งเดียวในงานที่ทำอยู่จะไม่กลายเป็นกฎถาวร ตัวข้อความเองยังเป็นข้อมูลสำหรับวิเคราะห์ ไม่ใช่คำสั่งที่เอเจนต์กลางคืนต้องทำตาม
การสูญหายเงียบ ๆ อีกแบบคือคำสำคัญที่เอเจนต์พยายามบันทึก แต่คลังไม่รับ ตอนนี้คำแนะนำกำหนดให้ดู keywords, keywords_dropped และ keywords_not_set ที่ส่งกลับมาจริง เก็บคำเดิมไว้ และพยายามแก้เฉพาะคำสำคัญได้ไม่เกินหนึ่งครั้ง คู่มือการรวมยังแยกข้อเท็จจริงหลักที่เป็นปัจจุบัน ที่เปลี่ยนไป ที่จบไปแล้ว และที่ถูกแก้ไข ทั้งหมดนี้คือการปรับคำแนะนำ เทสต์ที่ตรวจว่ามีคำแนะนำเหล่านี้อยู่ไม่ได้พิสูจน์ว่าโมเดลทุกตัวจะทำตามเสมอ
3.4.2 คือการแก้คำแนะนำและเอกสาร ไม่มีอัลกอริทึม dependency หรือตารางเวลาใหม่ หลังคำว่า “ลืม” คลังจะลบเวอร์ชันของข้อเท็จจริง และ dreaming จะล้างสำเนาของตัวเอง ทั้งแคช ไดอารี่ และบันทึกของงานตัวเอง มันไม่เขียนทับประวัติ Git ดัมป์ฐานข้อมูลภายนอก สำรองข้อมูลของระบบ และประวัติเซสชันของ Hermes รายงานต้องบอกแยกกันว่าอะไรถูกลบจากคลัง และอะไรยังเหลือในคลังเก็บภายนอก โดยไม่ยกข้อความที่ถูกลืมมาอ้าง สำเนาภายนอกที่ยังเหลือไม่ได้แปลว่าการลบจากคลังล้มเหลว และการสั่งซ้ำก็ไม่ได้ข้ามขอบเขตของเครื่องมือของคนอื่น
3.5–3.8: อัปเดต cron ฐานข้อมูลใหญ่ และเฉพาะสิ่งที่ยืนยันแล้ว
3.5.0 ตัดส่วนที่ยุ่งยากที่สุดของการอัปเดตออกไป เมื่อก่อนต้องย้ายคำแนะนำใหม่ของงานกลางคืนไปใส่ใน cron เอง ตอนนี้ install_cron.py อัปเดตพรอมต์ของงานที่มีอยู่ให้เอง ถ้ามันตรงกับพรอมต์มาตรฐานตัวใดตัวหนึ่งทุกตัวอักษร พรอมต์ที่แก้ด้วยมือ แม้แค่ช่องว่างเดียว จะคงไว้ตามเดิมพร้อมคำเตือน ตารางเวลา การส่ง โมเดล การพัก และตัวนับการรันยังอยู่ครบ ไม่มีงานไหนกลับมาทำงานต่อหรือถูกลบเอง แฟล็ก --upgrade รวบการอัปเดตไว้ในขั้นเดียว: ตรวจการตั้งค่า แทนสำเนาสคริปต์ภายใน ซิงค์งาน และตรวจผลลัพธ์ ตอนนี้ install.py --check แสดงพรอมต์มาตรฐานที่ล้าสมัย งานที่พักไว้ และงานซ้ำ
3.6.0 เพิ่มสรุปผลของงานจากบันทึกของ holographic 0.20 เข้าไปในรายงานกลางคืนได้ถ้าต้องการ (task_outcomes: true) นี่เป็นแค่ตัวนับ: ความถูกต้อง ค่าความเชื่อถือ และลำดับของข้อเท็จจริงไม่เปลี่ยนตามมัน ไม่มีการเรียกโมเดลเพิ่ม และรายงานของเอเจนต์ว่าคนแก้ไขมัน ไม่นับเป็นการยืนยันจากคน
3.7 ว่าด้วยฐานข้อมูลใหญ่ การหารายการซ้ำเลือกแคนดิเดตจากรากคำอย่างเดียว และบนฐานที่มีข้อเท็จจริงคล้าย ๆ กัน เช่น การเตือนที่มีวันที่ หรือประโยคเดียวกันเกี่ยวกับคนหลายคน งานจะโตเป็นกำลังสองของขนาด ตั้งแต่ราว 7,500 ข้อเท็จจริง คืนนั้นจะใช้ลิมิตการตรวจจนหมดและข้ามหัวข้อนี้ไป ใน 3.7.0 แคนดิเดตถูกคัดให้แคบลงด้วยตัวเลขและชื่อด้วย ข้อเท็จจริงสังเคราะห์ 50,000 ข้อจึงตรวจเสร็จใน 33 วินาที ใน 3.7.1 ตามรายงานของ sprd-tmu การนับการยืนยันบนบทสนทนายาว ๆ เร็วขึ้น: หน้าต่างที่มี 190 ข้อเท็จจริงและ 1,600 ข้อความ เมื่อก่อนทำไม่ทันใน 600 วินาทีที่กำหนด ตอนนี้ใช้ราว 86 วินาที และหน่วยความจำถูกจำกัดด้วยค่า corroboration.memory_mb (ค่าเริ่มต้น 256 MB) 3.7.2 ทำให้การกักกันความลับบนข้อความยาวเร็วขึ้นราว 40 เท่า แต่ตัวติดตั้งของ Hermes ไม่รับเวอร์ชันนี้: สแกนเนอร์อ่านคำหนึ่งในรายการคำขึ้นต้นของคำสั่งว่าเป็นความพยายามเจาะระบบ 3.7.3 แก้เรื่องนี้แล้ว และตอนนี้การตรวจ hermes plugins validate อยู่ใน CI ก่อนติดแท็ก ไม่ต้องติดตั้ง 3.7.2
3.8.0 ปิดช่องโหว่ทางเข้าหน่วยความจำถาวร ข้อสรุปของเอเจนต์ที่ไม่มีใครยืนยัน (inferred ใน holographic) เคยไปถึง MEMORY.md ได้ ถ้าเอเจนต์ใช้มันบ่อย หรือคำในนั้นโผล่ในแชท ตอนนี้มันจะไม่ถูกย้ายไม่ว่าทางไหน: ถ้าคนพูดซ้ำในหลายวัน คืนนั้นจะเสนอให้ถามเพื่อยืนยัน และหลังคนตอบ ข้อเท็จจริงจะไปตามกฎปกติ คลังที่ไม่มีเครื่องหมายที่มา ได้แก่ holographic ก่อน 0.15 และไฟล์ส่งออก SQLite กับ JSONL ทำงานเหมือนเดิม เมื่อใช้คู่กับ holographic 0.23 ข้อเท็จจริงที่เพิ่งถูกให้คะแนนจะไม่นับว่าใหม่อีกต่อไป: น้ำหนักของมันกลับไปตามอายุจริง
ทำไมหน่วยความจำของ Hermes Agent ต้องมีผู้ตัดสินบนคลาวด์
หลัง 3.2.0 กฎแม่นขึ้นมาก แต่ก็ยังมีขีดจำกัด กฎยังเห็นคำ ไม่ใช่ความหมาย “Gosha เป็นโค้ชทีมเยาวชน” ถูกนับให้ข้อเท็จจริง “Gosha ไม่ดื่มกาแฟ”: มีชื่อตรงกัน ข้อความไม่มีการปฏิเสธ และไม่มีตัวเลขใหม่ รายงานยาว ๆ ที่แปะลงแชทยืนยันทุกข้อเท็จจริงที่มันแตะถึง บนชุดทดสอบแยกที่มี 360 คู่ คู่ที่กฎนับไว้เป็นการยืนยันจริงแค่ 37% การยืนยันปลอมแต่ละครั้งดันข้อเท็จจริงเข้าใกล้หน่วยความจำถาวร หรือบอกคลังว่าคนพูดเรื่องนี้ซ้ำ
ตอนแรกผมลองแก้ปัญหาแบบโลคัล ในการทดลองสำหรับ 3.2.0 เราเทียบกฎกับโมเดลเล็กสองตัวที่รันบนเซิร์ฟเวอร์ตัวเองได้: Laya ซึ่งรองรับหลายภาษา และ mDeBERTa ที่ถูกฝึกให้บอกว่าประโยคหนึ่งอนุมานได้จากอีกประโยคหรือไม่ Laya อ่อนกว่าโมเดลอื่น mDeBERTa เองแม่นกว่ากฎ แต่ในฐานะความเห็นที่สองแทบไม่ได้เพิ่มอะไร และใช้หน่วยความจำราว 2.2 GB ซึ่งแพงไปสำหรับเซิร์ฟเวอร์ 8 GB ของผมที่มีเอเจนต์รันอยู่แล้ว ที่ยกผลรวมขึ้นได้ชัดมีแค่โมเดลตัดสินใจบนคลาวด์
โมเดลตัดสินใจคืออะไร
โมเดลตัดสินใจ (decision model) ไม่ใช่แชทบอท มันไม่เขียนข้อความ แต่รับคำถามและรายการคำตอบที่เป็นไปได้ เลือกมาหนึ่งข้อ และบอกความน่าจะเป็นของแต่ละข้อ ตอบภายในไม่กี่ร้อยมิลลิวินาที และมีราคาแค่เศษเสี้ยวของเซนต์ สำหรับงาน “ข้อความนี้ยืนยันข้อเท็จจริงนี้หรือไม่” นี่คือสิ่งที่ต้องการพอดี: คำถามแคบ คำตอบมีสามแบบ ไม่ต้องใช้การให้เหตุผล โดยแนวคิดแล้วใกล้กับวิธี LLM-as-a-judge ที่โมเดลหนึ่งตรวจอีกโมเดลหนึ่ง เพียงแต่ตรงนี้ผู้ตัดสินไม่ได้ตรวจโมเดล แต่ตรวจกฎ และตัวมันเองเป็นตัวจำแนกประเภท (classifier) ไม่ใช่แชทบอท
สกิลรองรับโมเดลแบบนี้สองตัว ตัวแรกคือ Jev 1.14 ของ TypeSafe ซึ่ง OpenRouter ให้ใช้ผ่าน API รุ่นอัลฟา ตัวที่สองคือ OpenAI Decisions กับโมเดล gpt-6-luna: OpenAI เปิดเป็นเบต้าสาธารณะเมื่อ 6 ตุลาคม และเปิดให้ใช้ทั่วไปเมื่อ 22 ตุลาคม จากการวัด การเรียกแต่ละครั้งมีราคาราว $0.00002 ความหน่วงมัธยฐานราว 0.3 วินาที Jev อยู่อันดับแรก เพราะบนชุดทดสอบมันถอนการยืนยันปลอมได้มากกว่า ขณะที่ความผิดพลาดเป็นศูนย์เท่ากัน OpenAI เป็นตัวสำรองสำหรับคืนที่ API อัลฟาของ Jev ล่มหรือเปลี่ยน: คู่จะถูกส่งไปที่นั่นก็ต่อเมื่อโมเดลแรกไม่ได้ให้คำตอบที่ใช้ได้
หนึ่งคืนที่มีผู้ตัดสินเป็นอย่างไร
ผู้ตัดสินปิดอยู่โดยค่าเริ่มต้น เมื่อปิดอยู่ โค้ดของมันจะไม่ถูกโหลด และตัวรอบเองก็ไม่เรียกอะไรภายนอก ตอนเพิ่มผู้ตัดสินใน 3.3.0 ผลอ้างอิง (baseline) ที่บันทึกไว้ของสองคืนยืนยันว่าถ้าไม่มีมัน การตัดสินใจยังเหมือนใน 3.2.0 การตรวจนี้ครอบคลุมเฉพาะการเปลี่ยนแปลงครั้งนั้น ส่วนการแก้เรื่องการอ่านที่ตามมาและข้อเสนอรวมรายการซ้ำใหม่ของ 3.4 อธิบายไว้ด้านบนแล้ว
เมื่อเปิดใช้ มันทำงานแบบนี้ ขั้นแรกกฎตัดสินคืนนั้นตามปกติ และจำทุกคู่ “ข้อเท็จจริง — ข้อความ” ที่นับไว้ จากนั้นสำหรับแต่ละคู่ที่อนุญาตให้ออกจากเครื่องได้ สกิลจะถามโมเดลด้วยคำถามเดียวกัน: ข้อความนี้ยืนยันข้อเท็จจริง ขัดแย้งกับมัน หรือไม่ใช่ทั้งสองอย่าง? โมเดลเลือกคำตอบและให้ความน่าจะเป็น ถ้าคำตอบไม่ใช่ “ยืนยัน” และความมั่นใจในคำตอบนั้นไม่ต่ำกว่าเกณฑ์ 0.50 คู่นั้นจะถูกถอนออกจากการนับ นี่แหละคือวีโต้ (veto)
ข้อจำกัดสำคัญ: ผู้ตัดสินทำได้แค่ขีดฆ่าการยืนยันที่กฎให้ไว้ แต่จะไม่เพิ่มการยืนยันของตัวเองเด็ดขาด แคนดิเดตยังถูกเลือกโดยกฎ ความผิดพลาดหรือการล่มของผู้ตัดสินจึงลากสิ่งที่กฎไม่เจอเข้าหน่วยความจำไม่ได้ วีโต้ที่ผิดอาจทำให้การบันทึกหรือการยืนยันข้อเท็จจริงจริงล่าช้า และเปลี่ยนการตัดสินใจอื่นของคืนนั้นที่อิงจำนวนการกล่าวถึง แต่เพิ่มสิ่งที่ไม่ควรมีเข้าไปไม่ได้
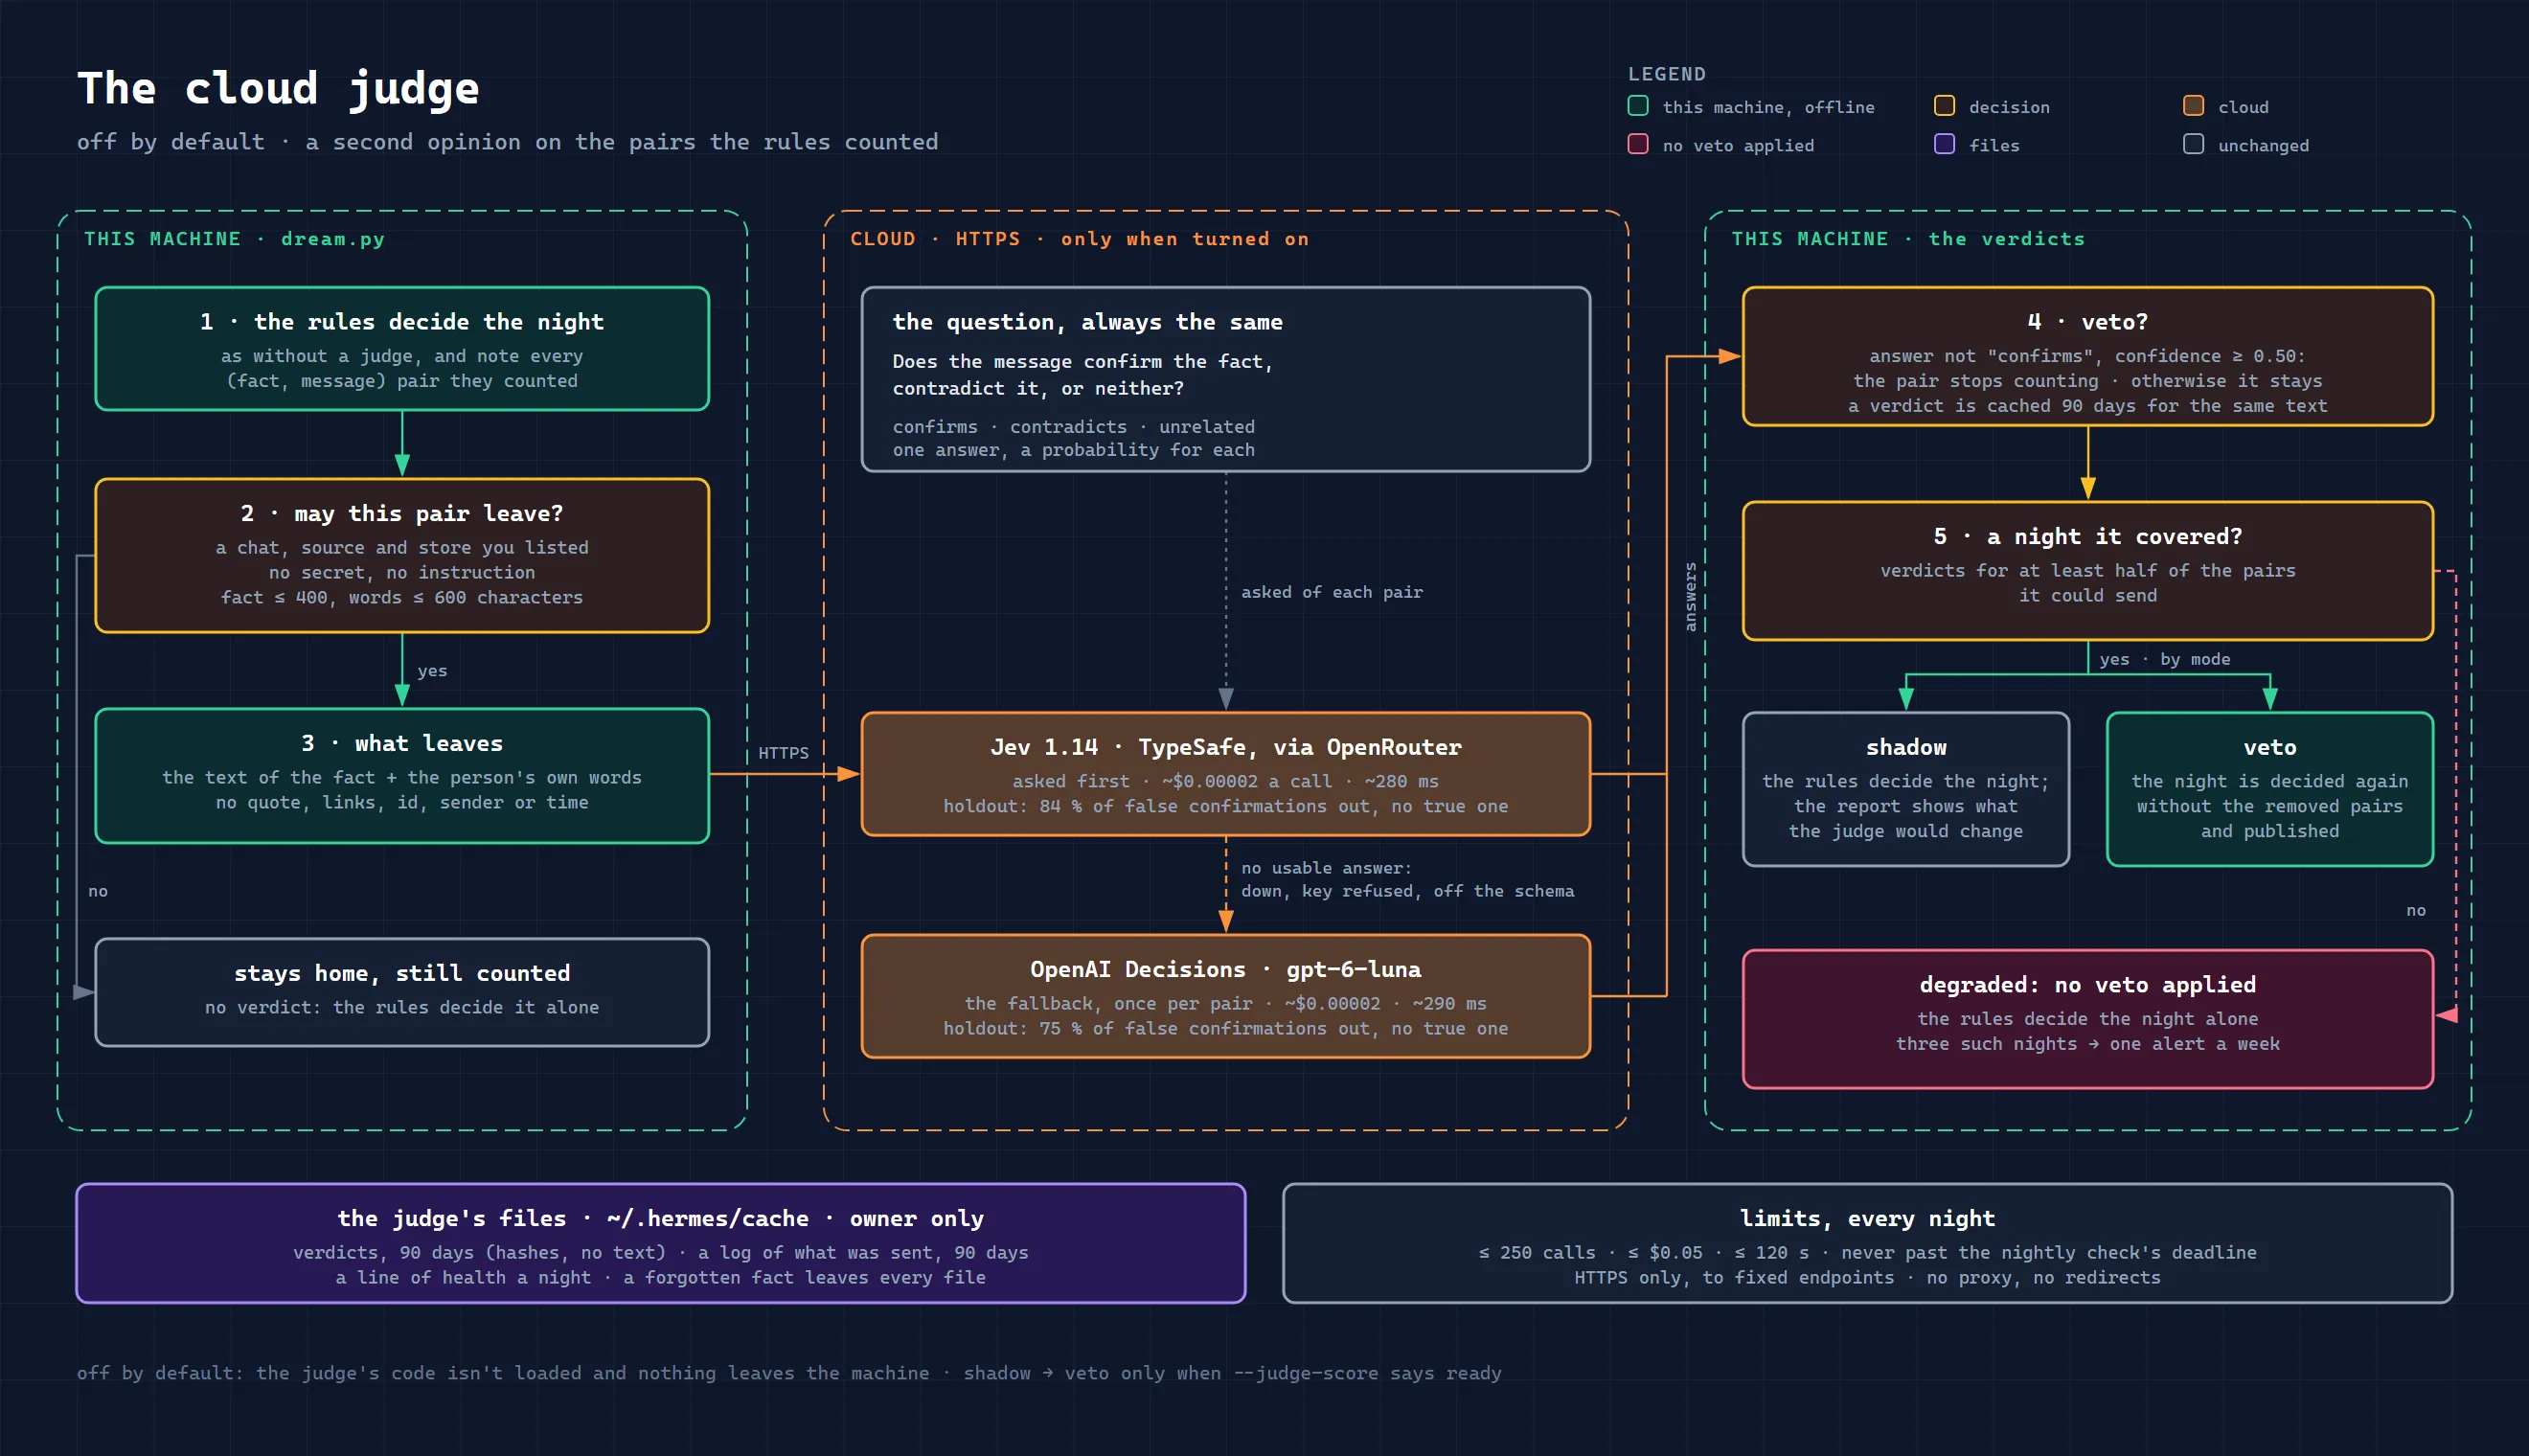
มีสองโหมด ใน shadow รายงานสุดท้ายใช้การตัดสินใจของกฎ และในสถิติของคืนจะมีบรรทัดหนึ่งบอกว่าผู้ตัดสินจะถอนกี่คู่ และจะเปลี่ยนการตัดสินใจไปกี่ข้อ ใน veto คืนนั้นจะถูกตัดสินใหม่โดยไม่มีคู่ที่ถูกถอน และมีผลกับทุกอย่างที่อิงการนับ: การย้ายข้อเท็จจริงเข้าหน่วยความจำ การยืนยัน การจางหายของข้อเท็จจริงเก่า แคนดิเดตใหม่ และความขัดแย้ง คำถาม “รายการนี้ยังเป็นปัจจุบันไหม?” ผู้ตัดสินไม่แตะเลย
และด่านสุดท้าย ถ้าในคืนหนึ่งผู้ตัดสินตอบได้ไม่ถึงครึ่งของคู่ที่ส่งได้ ไม่ว่าเพราะเน็ตล่ม เครดิตของคีย์หมด หรือผู้ให้บริการเปลี่ยน API คืนนั้นจะไม่ใช้วีโต้เลย ให้กฎตัดสินอย่างเดียว หลังเกิดแบบนี้สามคืน ถ้าระหว่างนั้นไม่มีคืนปกติติดกันสองคืน จะมีคำเตือนมา ไม่เกินสัปดาห์ละครั้ง คีย์ที่หายจะไม่ผ่านไปโดยไม่มีใครรู้ แต่คืนที่ตรวจไม่ครบก็จะไม่ทำให้หน่วยความจำเพี้ยน
ผู้ตัดสินแม่นแค่ไหน: ผลวัดบน 360 คู่
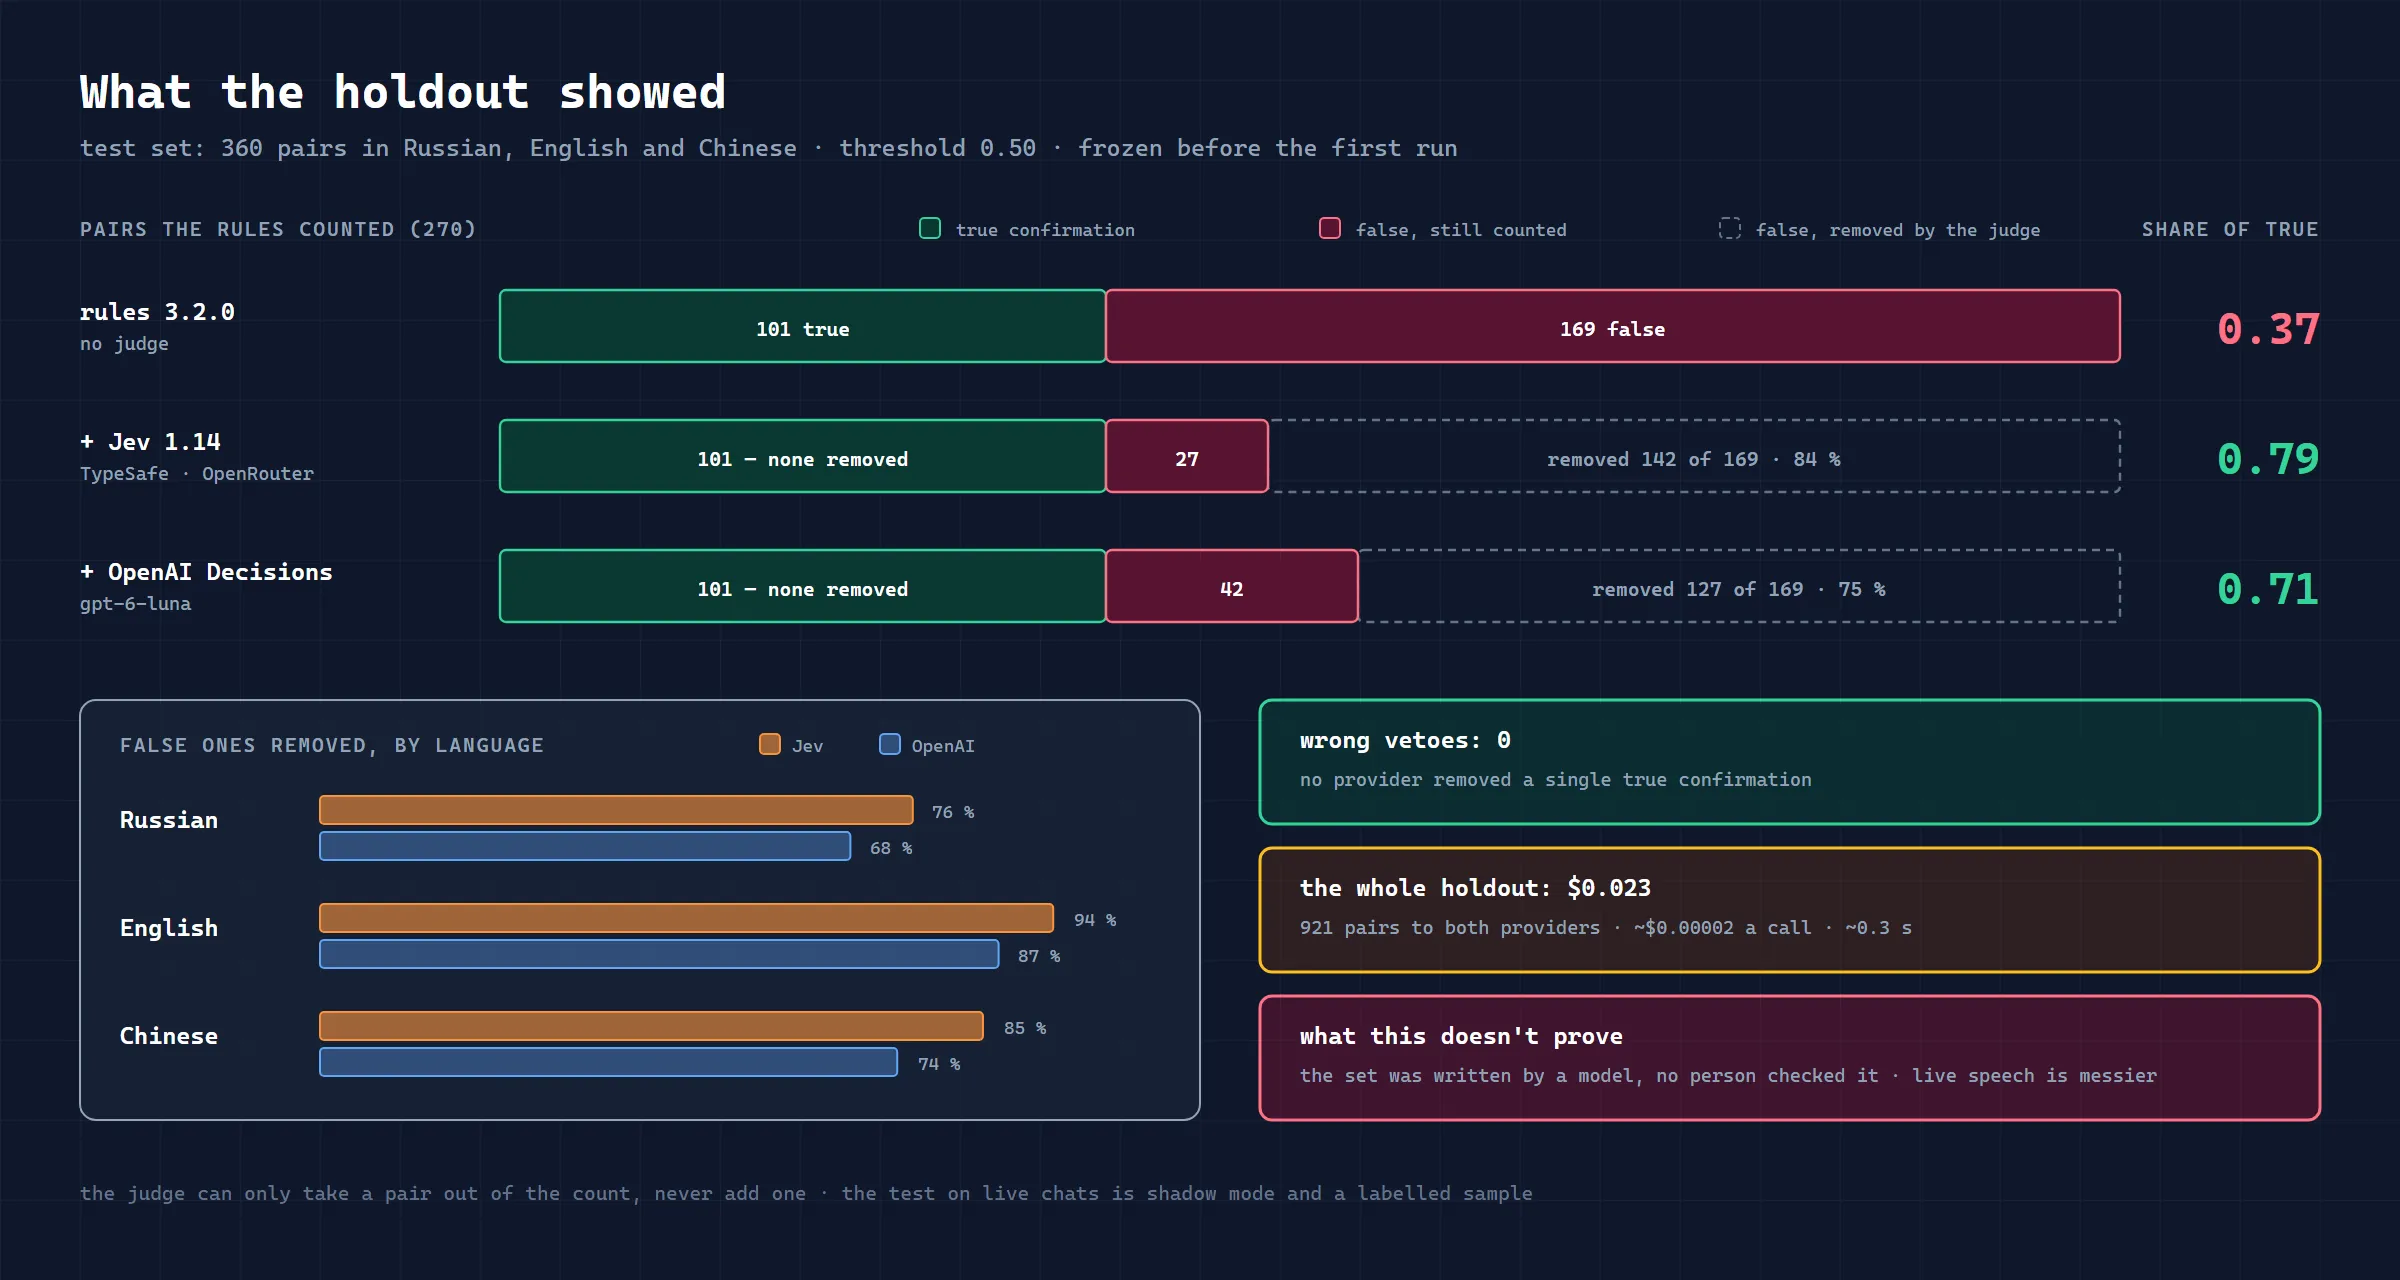
ทั้งเกณฑ์และความคุ้มของไอเดียนี้ถูกตรวจก่อนเขียนโค้ด สำหรับการตรวจ เราเตรียม 921 คู่แบบเดียวกับที่ปลั๊กอินเตรียมจริงทุกประการ และส่งให้ผู้ให้บริการเฉพาะคู่ที่กฎนับไว้ บน 561 คู่ เราเลือกเกณฑ์ตามกฎที่เขียนไว้ล่วงหน้า: ค่าต่ำสุดที่วีโต้ผิดไม่เกิน 5% และการยืนยันที่หายไปไม่เกิน 10% ผู้ให้บริการทั้งสองผ่านตั้งแต่ค่าต่ำสุดที่ทดสอบ คือ 0.50 อีก 360 คู่ที่เหลือคือชุดทดสอบภาษารัสเซีย อังกฤษ และจีน ซึ่งเขียนโดยโมเดลแยกต่างหาก และถูกล็อกไว้ก่อนรันครั้งแรก
บนชุดนี้ กฎนับไว้ 270 คู่: เป็นการยืนยันจริง 101 คู่ และปลอม 169 คู่ Jev ถอนคู่ปลอมได้ 142 จาก 169 หรือ 84% ส่วน OpenAI ถอนได้ 127 หรือ 75% ทั้งสองตัวไม่ถอนการยืนยันจริงเลยสักคู่ สัดส่วนของคู่จริงในคู่ที่นับไว้เพิ่มจาก 0.37 เป็น 0.79 สำหรับ Jev และ 0.71 สำหรับ OpenAI แยกตามภาษา ภาพเป็นไปตามคาด: ผู้ตัดสินทำได้ดีที่สุดกับภาษาอังกฤษ (Jev ถอนคู่ปลอมได้ 94%) แย่กว่ากับภาษารัสเซีย (76%) และภาษาจีนอยู่ตรงกลาง (85%) การวัดทั้งหมดใช้เงิน 2.3 เซนต์
ก่อนออกรีลีส ตัวปลั๊กอินเองรันคำตอบที่บันทึกไว้เหล่านี้ผ่านโค้ดของมัน และถอนคู่เดียวกันทุกคู่ไม่ผิดสักคู่ เทสต์ 71 ตัวบนผู้ให้บริการจำลองตรวจว่าคู่ไหนส่งได้ อะไรเข้าไปในคำขอ และผู้ตัดสินทำตัวอย่างไรเมื่อเกิดข้อผิดพลาด ใช้เงินเกิน หรือใช้เวลาเกิน
ทีนี้มาดูสิ่งที่การวัดนี้พิสูจน์ไม่ได้ ชุดทดสอบเขียนโดยโมเดล ไม่มีคนตรวจซ้ำ และภาษาพูดจริงก็เละกว่าตัวอย่างที่เขียนขึ้น วีโต้ผิดเป็นศูนย์ได้มาจากข้อความที่สะอาด ในแชทจริงผู้ตัดสินคงพลาดบ้างแน่ ๆ และหลังวีโต้ ในคู่ที่นับไว้ยังมีสัญญาณรบกวนเหลือราวหนึ่งในห้าถึงหนึ่งในสี่: ผู้ตัดสินดีกว่ากฎชัดเจน แต่ไม่ได้สมบูรณ์แบบ ผู้ตัดสินจึงปิดอยู่โดยค่าเริ่มต้น และควรเริ่มจากโหมด shadow: มันให้คะแนนคู่ แต่ไม่เปลี่ยนการตัดสินใจของคืนนั้น
ความเป็นส่วนตัว: ผู้ตัดสินส่งอะไรขึ้นคลาวด์
นี่คือคำถามหลักของทุกคนที่ใช้เอเจนต์ในแชทครอบครัวหรือแชทงาน กฎตรงนี้จึงเข้มงวด เรื่องการป้องกัน AI เอเจนต์ในแชทกลุ่มโดยรวม ผมเขียนไว้แยกต่างหาก สิ่งที่ถูกส่งมีแค่คู่จากแชทและแหล่งที่คุณระบุไว้เอง ค่าเริ่มต้นคือไม่ได้ระบุอะไรเลย ที่ส่งออกไปคือข้อความของข้อเท็จจริงและคำของคนเอง โดยไม่มีคำพูดอ้างอิงที่เขาตอบกลับ ไม่มีลิงก์ ไม่มีเครื่องหมายภายใน ไม่มี id ชื่อผู้ส่ง หรือเวลา แต่ชื่อที่อยู่ในตัวข้อความยังถูกส่งไป ข้อนี้ควรเข้าใจไว้
คู่ที่มีความลับหรือบรรทัดที่ดูเหมือนคำสั่งถึงเอเจนต์จะอยู่ในเครื่อง คู่ที่ยาวก็เช่นกัน: ข้อเท็จจริงที่ยาวกว่า 400 ตัวอักษร หรือข้อความที่ยาวกว่า 600 ตัวอักษร จะไม่ถูกส่งให้ผู้ตัดสิน และยังถูกนับไว้โดยไม่มีคำตัดสิน นี่เป็นสัดส่วนที่ไม่น้อย: บนระบบของครอบครัวผม การรันทดลองเจอคู่ที่นับไว้ 247 คู่ ในนั้นส่งได้ 63 คู่ อีก 113 คู่อยู่ในเครื่องเพราะความยาว และ 71 คู่เพราะไม่ได้มาจากแหล่งที่อนุญาต
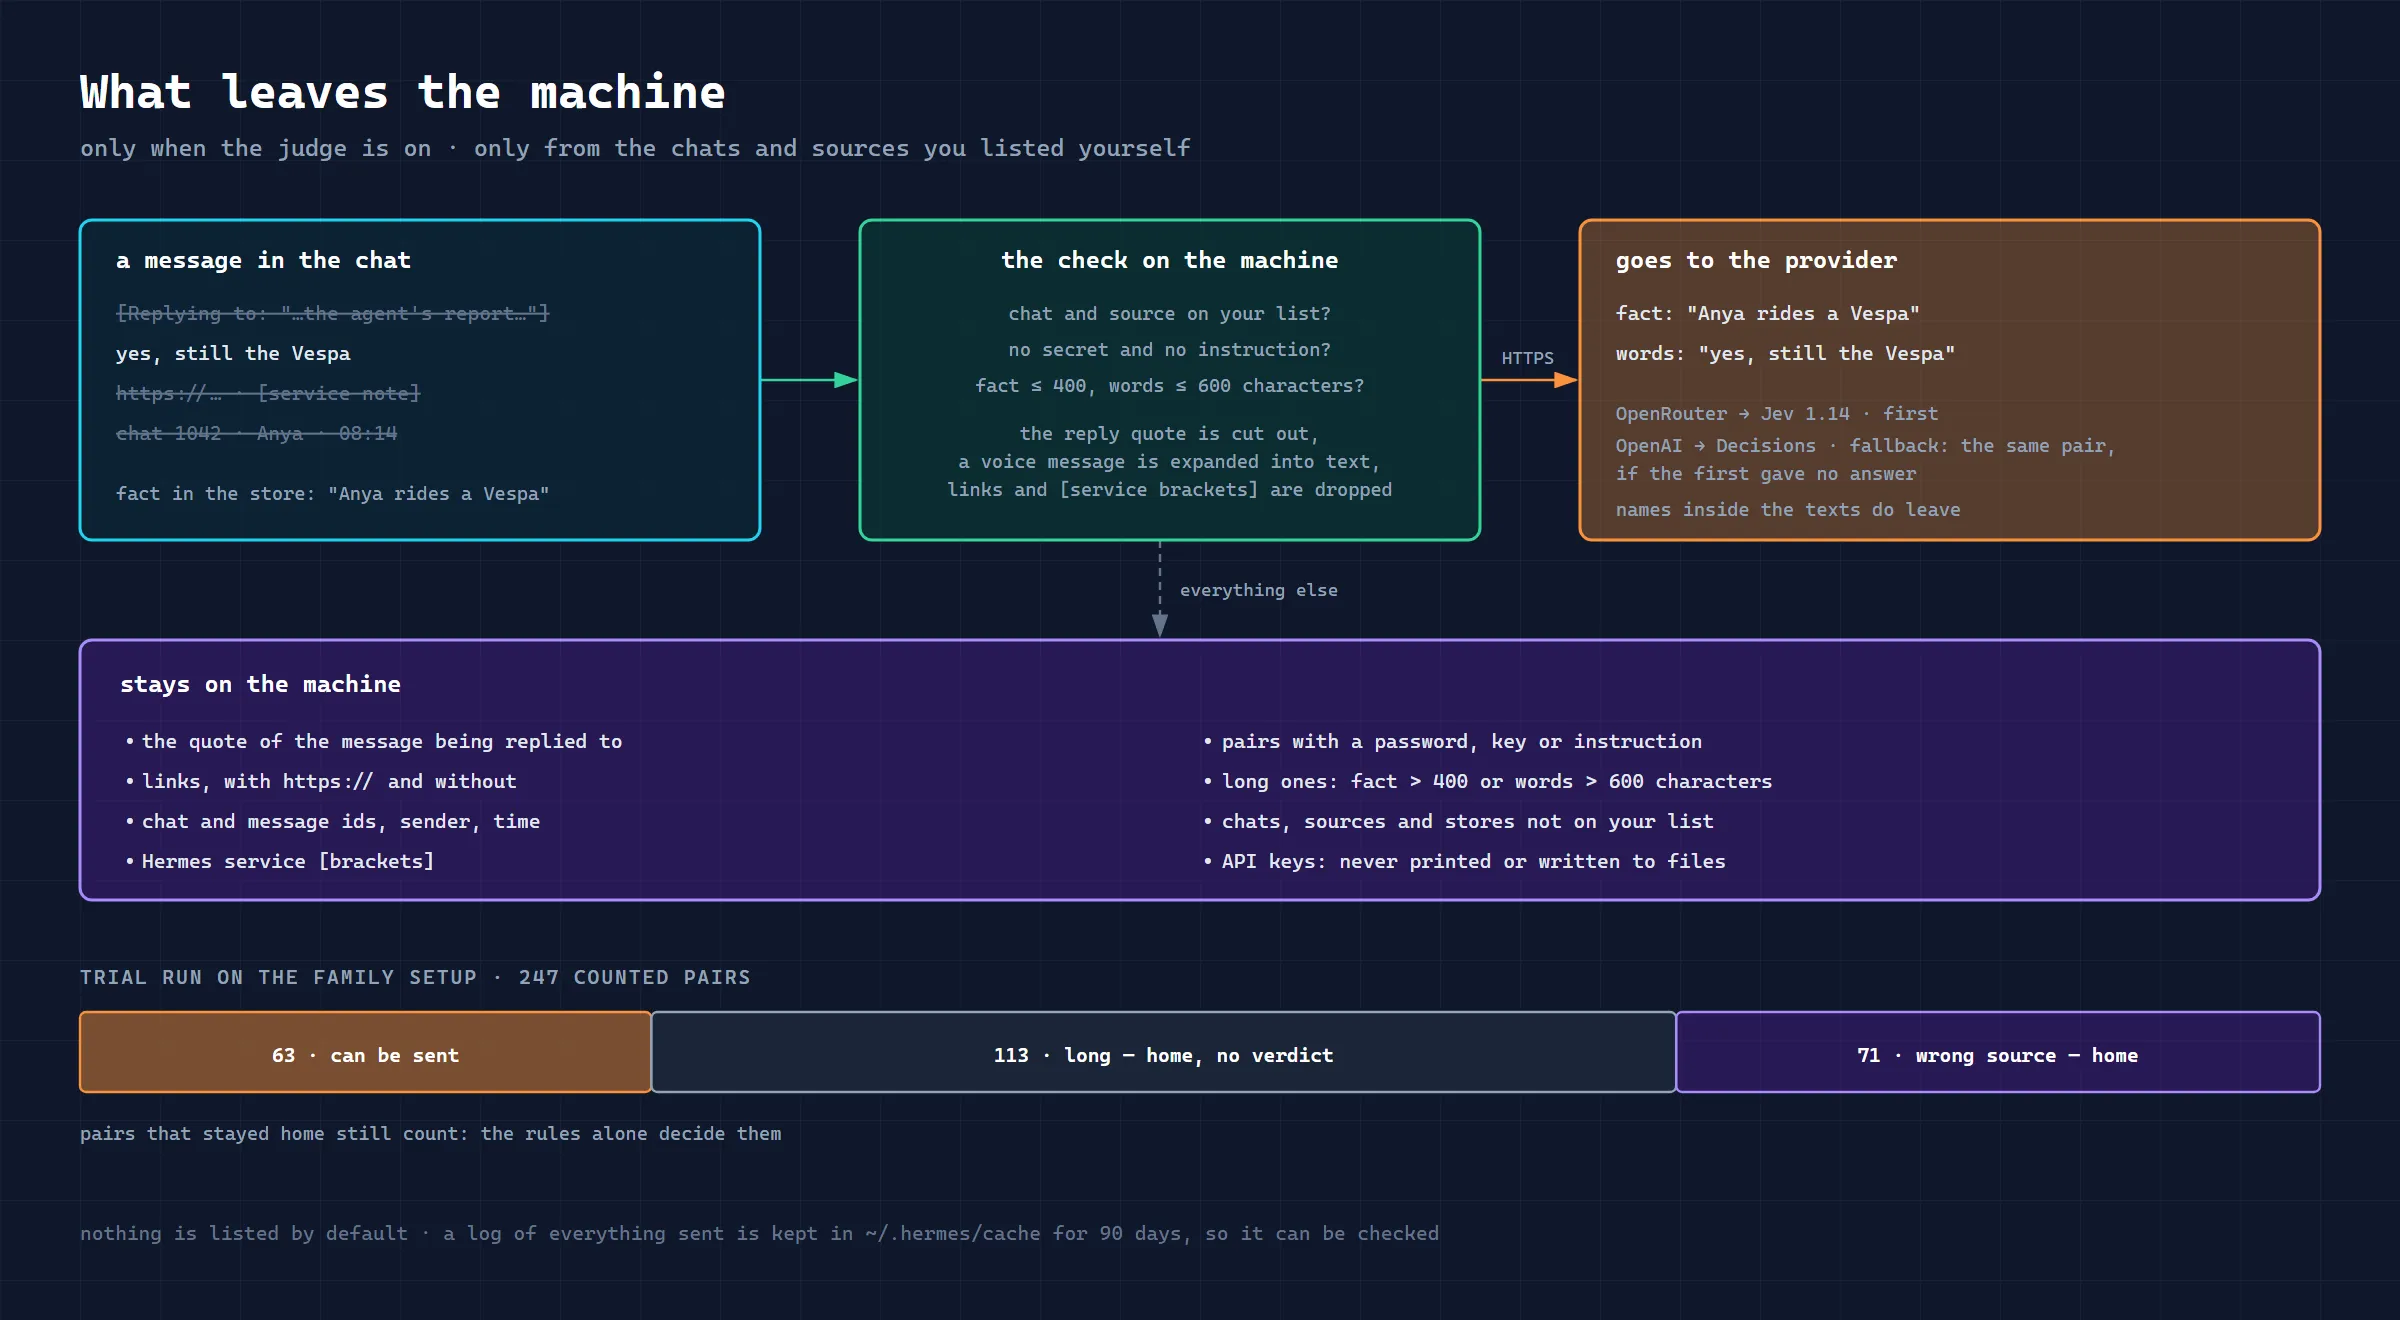
ผู้รับคือ OpenRouter สำหรับ Jev และ OpenAI สำหรับตัวสำรอง ถ้าเปิดทั้งสองตัว คู่เดียวกันอาจไปถึงทั้งสองเจ้า เงื่อนไขการเก็บข้อมูลของสองเจ้านี้ต่างกัน ตามเอกสาร ณ ตุลาคม 2569 ข้อมูลที่ส่งให้ Jev ไม่ถูกใช้เทรนโมเดล และการไม่เก็บข้อมูลเลย (zero retention) มีให้เฉพาะลูกค้า enterprise ส่วน OpenAI เก็บคำขอไว้ไม่เกิน 30 วันเพื่อตรวจการใช้งานในทางที่ผิด ให้ zero retention เมื่อได้รับอนุมัติ และโดยค่าเริ่มต้นก็ไม่ใช้ข้อมูลเทรนเช่นกัน ก่อนส่งแชทครอบครัว ให้ตรวจเงื่อนไขปัจจุบันด้วยตัวเอง: สิ่งที่ส่งไปแล้วเรียกคืนไม่ได้
เงินและเวลามีลิมิตต่อคืน: เรียกได้ไม่เกิน 250 ครั้งและไม่เกินสองนาที งบ $0.05 (การเรียกครั้งสุดท้ายอาจเกินไปนิดหน่อย) และไม่เลยกำหนดเวลาของการตรวจกลางคืนเด็ดขาด ด้วยราคาราว $0.00002 ต่อครั้ง คืนหนึ่งของระบบผมซึ่งมีราว 60 คู่ ใช้เงินประมาณหนึ่งในสิบของเซนต์ สกิลเชื่อมต่อแค่ HTTPS ไปยังที่อยู่ที่กำหนดตายตัว ไม่ผ่านพร็อกซีและไม่ตามการเปลี่ยนเส้นทาง ผู้ตัดสินเก็บไฟล์ของตัวเองไว้ใน ~/.hermes/cache/ โดยให้สิทธิ์เฉพาะเจ้าของ: แคชคำตัดสิน 90 วัน (แฮชและหมายเลขข้อเท็จจริง ไม่มีข้อความ) บันทึกทุกอย่างที่ส่งออกไปตามที่มันถูกส่งจริงเพื่อให้ตรวจสอบได้ และบรรทัดสถานะสุขภาพของแต่ละคืน ถ้าบอกเอเจนต์ให้ “ลืม” ข้อเท็จจริงไหน มันจะหายไปจากไฟล์เหล่านี้ด้วย
วิธีเปิดผู้ตัดสินบนคลาวด์ และเมื่อไหร่ควรเปลี่ยนไปใช้ veto
เปิดผู้ตัดสินได้ด้วยส่วนเดียวใน ~/.hermes/dreaming.json:
"judge": {
  "mode": "shadow",
  "providers": ["jev", "openai"],
  "send_from": "trusted",
  "send_sources": ["telegram"]
}
send_from: "trusted" อนุญาตแชทกลุ่มที่เชื่อถือได้จากการตั้งค่าของสกิล และถ้าเปิด trust_private_chats ไว้ ก็รวมแชทส่วนตัวด้วย ถ้าอยากรู้แน่ชัดว่าบทสนทนาของใครถูกส่งไป ให้ระบุ id ของแชทแทน "trusted" ได้ send_sources คือที่มาของเซสชัน เช่น Telegram คีย์ OPENROUTER_API_KEY และ OPENAI_API_KEY ใส่ไว้ใน environment หรือใน ~/.hermes/.env: Hermes ไม่ส่งคีย์ของผู้ให้บริการไปให้สคริปต์กลางคืน ผู้ตัดสินจึงอ่านบรรทัดของตัวเองจากไฟล์นี้เอง และไม่อ่านบรรทัดอื่นเลย คีย์ไม่ถูกพิมพ์ออกมาที่ไหน install.py --check จะแสดงโหมด ปลายทางที่คู่อาจถูกส่งไป และบอกว่าเจอคีย์แต่ละตัวหรือไม่ แต่ไม่แสดงค่าของมัน ดูคืนหนึ่งโดยไม่มีผลอะไรตามมาได้ด้วย dream.py --dry-run: มันอ่านแคชของผู้ตัดสินและไม่ส่งอะไรเลย แต่การรันเองโดยไม่มี --dry-run คือคืนจริงที่มีการส่งข้อมูล
การเปลี่ยนไปใช้ veto ไม่ต้องทำแบบหลับหูหลับตา เพราะมีขั้นตอนไว้ให้ ผู้ตัดสินทำงานใน shadow สักสองสัปดาห์ จากนั้น dream.py --judge-export sample.jsonl จะส่งออกชุดตัวอย่างแบบไม่เห็นคำตัดสิน คือข้อเท็จจริงละหนึ่งคู่ที่ถูกให้คะแนนแล้ว มีแค่ข้อความของข้อเท็จจริงและข้อความที่คนเขียน ไม่มีคำตอบของผู้ตัดสิน คุณติดป้ายทุกบรรทัด: ยืนยัน ขัดแย้ง ไม่ใช่ทั้งสองอย่าง หรือ “ไม่รู้” dream.py --judge-score เทียบป้ายกับคำตัดสินแล้วตอบเป็นคำเดียว ready คือเมื่อแม้แต่ค่าประมาณแบบมองโลกในแง่ร้าย วีโต้ผิดก็ไม่เกิน 10% การยืนยันที่หายไปไม่เกิน 20% ผู้ตัดสินตอบอย่างน้อย 90% ของคู่ และไม่มีวีโต้ผิดครั้งไหนเปลี่ยนการตัดสินใจเรื่องหน่วยความจำ ถ้าผู้ให้บริการสำรองให้คำตัดสินเกินหนึ่งในห้า ผู้ให้บริการแต่ละเจ้าต้องผ่านการตรวจแยกกัน not_ready คือเมื่อแม้แต่ค่าประมาณแบบมองโลกในแง่ดี วีโต้ผิดก็เกิน 10% นอกนั้นคือ continue: ให้ติดป้ายเพิ่ม
ผลการติดป้ายแบบนี้บนระบบที่ใช้งานจริงยังไม่มี การเปลี่ยนไปใช้ veto จึงยังเป็นเรื่องข้างหน้า เกณฑ์ยังเหมือนเดิม คือตรวจก่อนและได้ผล ready
วิธีอัปเดต hermes-dreaming
ณ 30 ตุลาคม แคตตาล็อกให้ 3.7.1 ติดตั้งทับเวอร์ชันเก่าได้ด้วยคำสั่ง hermes plugins install hermes-dreaming --force สำหรับ 3.8.0 ถ้าไม่อยากรอแคตตาล็อกอัปเดต ให้ใช้แคตตาล็อกเป็นแหล่งเหมือนเดิม แล้วระบุแฮชเต็มของรีลีส:
hermes plugins install hermes-dreaming --ref 4a367324db65f0b4fe3b43a18a83704609cecffe --forceholographic จากแคตตาล็อก (0.22.0) รวมข้อเท็จจริงได้แล้ว ถ้าอยากได้ 0.23.1 ล่าสุดด้วย ให้รัน hermes backup ก่อน แล้วตามด้วย:
hermes plugins install holographic --ref 93fd2b7334c36fd752c35360d7089573411597ef --forceวิธีนี้ปักคอมมิตของรีลีสที่ระบุไว้ ไม่ได้ติดตั้งสถานะอะไรก็ได้ของ main ตรวจเวอร์ชันได้ด้วย hermes plugins list ถ้าเคย merge ไปแล้ว อย่าย้อน holographic ด้วยแฮชไปต่ำกว่า 0.19.0: ข้อจำกัดของสคีมาอธิบายไว้ด้านบน อย่าติดตั้ง 3.7.2 เพราะตัวติดตั้งของ Hermes ปฏิเสธเวอร์ชันนี้
หลังอัปเดต dreaming ให้จัดสคริปต์ภายในและงาน cron ให้เรียบร้อย ตั้งแต่ 3.5.0 ทำได้ด้วยคำสั่งเดียว: ดูแผนก่อน แล้วรันซ้ำโดยไม่มี --dry-run และปิดท้ายด้วยการตรวจ ด้านล่างคือพาธของการติดตั้งปกติบน Linux/macOS ถ้าใช้ HERMES_HOME อื่นหรือ Windows ให้ใช้พาธของปลั๊กอินและอินเทอร์พรีเตอร์ของ Hermes ในเครื่องคุณ:
~/.hermes/hermes-agent/venv/bin/python \
    ~/.hermes/plugins/hermes-dreaming/skills/dreaming/scripts/install_cron.py --upgrade --dry-run
~/.hermes/hermes-agent/venv/bin/python \
    ~/.hermes/plugins/hermes-dreaming/skills/dreaming/scripts/install_cron.py --upgrade
~/.hermes/hermes-agent/venv/bin/python \
    ~/.hermes/plugins/hermes-dreaming/skills/dreaming/scripts/install.py --check
--upgrade แทนสำเนาสคริปต์ภายใน อัปเดตพรอมต์มาตรฐานของงานที่มีอยู่ และตรวจผลลัพธ์ ตารางเวลา การส่ง โมเดล และการพักยังอยู่ครบ ถ้าคุณแก้พรอมต์ด้วยมือ ตัวติดตั้งจะไม่แตะมันและจะเตือน: ให้เทียบกับ DREAM_PROMPT และ EXTRACT_PROMPT ใน install_cron.py ที่ติดตั้งไว้ แล้วย้ายการแก้ไขไปเอง อย่าเปลี่ยนการตั้งค่า cron ระหว่างที่ตัวติดตั้งทำงาน และอย่าแก้ cron/jobs.json ที่ใช้งานอยู่ด้วยมือ ตรงนี้ไม่ต้องใช้แฟล็ก --force: มันจะสร้างงานเพิ่มอีกงาน
ดูคืนนี้โดยไม่เขียนสถานะและไม่ส่งให้ผู้ตัดสินได้ด้วย dream.py --dry-run การรันเองโดยไม่มีแฟล็กนี้ รวมถึง hermes cron run คือรอบจริงพร้อมผลทุกอย่างที่ตามมา ไม่ใช่การดูตัวอย่างที่ปลอดภัย
ถ้ายังไม่มีสกิล ให้เริ่มจากบทความแรก ซึ่งมีขั้นตอนติดตั้งทีละขั้น และถ้ายังไม่มี Hermes เลย ให้เริ่มจากการติดตั้งและเชื่อมต่อกับ Telegram โค้ด คำอธิบายผู้ตัดสินแบบเต็ม และที่สำหรับถามคำถามอยู่ในรีโพบน GitHub
สกิลอื่นของผมในแคตตาล็อกเดียวกันคือ hermes-cron สำหรับงานตามกำหนดเวลา และ hermes-field-notes สำหรับบั๊กและแพตช์ที่เจอ ส่วนจะหาสกิลและปลั๊กอินอื่นของ Hermes ได้ที่ไหน และตรวจของคนอื่นก่อนติดตั้งอย่างไร รวมไว้ในบทความภาพรวม
คำถามที่พบบ่อย
ทุกคนต้องเปิดผู้ตัดสินไหม?
ไม่ต้อง ถ้าไม่มีผู้ตัดสิน สกิลก็ทำงานเหมือนเดิม และหลัง 3.2.0 ก็แม่นกว่าที่เคย ผู้ตัดสินเหมาะกับคนที่มีแชทคึกคัก มีข้อเท็จจริงเยอะ และให้ความสำคัญว่าหน่วยความจำต้องไม่รับของเกิน ถ้าการส่งข้อความจากแชทขึ้นคลาวด์เป็นเรื่องที่คุณรับไม่ได้ ก็แค่ไม่ต้องเปิด
ผู้ตัดสินราคาเท่าไหร่?
ตัวสกิลฟรี จากการวัด การเรียกโมเดลแต่ละครั้งราว $0.00002 งบต่อคืน $0.05 (การเรียกครั้งสุดท้ายอาจเกินไปนิดหน่อย) และในความเป็นจริง บนระบบของครอบครัวใช้แค่เศษเสี้ยวของเซนต์ ต้องมีคีย์ OpenRouter, OpenAI หรือทั้งสองอย่าง
ผู้ตัดสินทำให้หน่วยความจำเสียได้ไหม?
มันทำได้แค่ถอนการยืนยัน แต่เพิ่มไม่ได้ จึงบันทึกสิ่งที่กฎไม่เจอเข้าหน่วยความจำไม่ได้ ในโหมด shadow มันไม่เปลี่ยนการตัดสินใจของคืนนั้น แต่ส่งคู่ที่อนุญาตให้ผู้ให้บริการและเก็บบันทึกไว้ ใน veto วีโต้ที่ผิดอาจทำให้การบันทึกหรือการยืนยันข้อเท็จจริงจริงล่าช้า และคืนที่ผู้ตัดสินตอบไม่ถึงครึ่งของคู่จะถูกตัดสินโดยไม่มีมัน
ทำไมไม่ใช้โมเดลโลคัล?
ลองแล้ว: Laya อ่อนกว่าโมเดลอื่น ส่วน mDeBERTa ในฐานะความเห็นที่สองแทบไม่ได้เพิ่มอะไร และต้องใช้หน่วยความจำมากกว่าสองกิกะไบต์ โมเดลตัดสินใจบนคลาวด์ถอนการยืนยันปลอมได้มากกว่าหลายเท่า และไม่ต้องใช้อะไรจากเซิร์ฟเวอร์เลย
ทำไมไม่ส่งข้อความยาว?
ยิ่งข้อความยาว ยิ่งมีเนื้อหาที่ไม่เกี่ยวกับข้อเท็จจริงมาก และยิ่งมีโอกาสส่งของเกินออกไป เกณฑ์สำหรับข้อความยาวไม่ได้ถูกทดสอบในการวัด ต่อไปผู้ตัดสินอาจได้รับแค่ส่วนของข้อความรอบคำที่ตรงกัน แต่จะตัดสินใจเรื่องนี้หลังเฝ้าดูสักสองสัปดาห์
เวอร์ชันไหนมีในแคตตาล็อกแล้ว และเวอร์ชันไหนมีแค่ในรีโพ?
ณ 30 ตุลาคม แคตตาล็อกปักไว้ที่ 3.7.1 ส่วนในรีโพออกรีลีส 3.8.0 แล้ว ผู้ตัดสิน การรวมรายการซ้ำ และการอัปเดตงาน cron ด้วย --upgrade ใช้จากแคตตาล็อกได้แล้ว ข้อเสนอให้รวมรายการซ้ำต้องใช้ dreaming 3.4.0+ และ holographic 0.19.0+ อย่าสับสนระหว่างรีลีสของรีโพกับการอัปเดตคอมมิตที่ปักไว้ในแคตตาล็อก
การรวมรายการซ้ำจะลบประวัติเก่าไหม?
ไม่ลบ merge เก็บเวอร์ชัน แหล่งที่มา และการยืนยันของสำเนาไว้ ถ้าจะลบต้องใช้ forget แต่คำสั่งนี้ก็ไม่ได้ล้างคลังเก็บภายนอกและประวัติเซสชันของ Hermes การรวมไม่มีคำสั่งยกเลิกแยก และหลัง merge ครั้งแรก ฐานข้อมูลต้องใช้ holographic 0.19.0 ขึ้นไปจึงจะเขียนได้



