คนส่วนใหญ่สร้างภาพใน ChatGPT เพราะความเคยชิน: มันอยู่ใกล้มือ เข้าใจภาษารัสเซีย และจ่ายเงินไปแล้ว แต่ AI สร้างภาพมีมากกว่าหนึ่งตัวมานานแล้ว เลกเชอร์ของ Artyom Simonenko ใน AI Tuesday วันที่ 3 พฤศจิกายน (ภาษารัสเซีย) ตั้งชื่อไว้ตรงตัวว่า “ไม่ได้มีแค่ ChatGPT” เขาลองดูว่าคนที่ไม่เคยมองไกลกว่า ChatGPT พลาดอะไรไปบ้าง เขาเลือกโจทย์สี่แบบ ได้แก่ ภาพนิ่งแบบฉากภาพยนตร์ แบนเนอร์โฆษณาที่มีข้อความภาษารัสเซีย ภาพประกอบเชิงศิลปะ และภาพเหมือนจริง แล้วเขียน prompt ละเอียดยาวราว 5,000 ตัวอักษรสำหรับแต่ละโจทย์ ห้าโมเดลได้ prompt เดียวกันทุกตัว จากนั้นนำผลมาวางเทียบกัน
ด้านล่างคือสิ่งที่การทดสอบแสดงให้เห็น วิธีแยกภาพที่ใช้งานได้ออกจากภาพเสียด้วยตัวเอง ค่าใช้จ่ายของ aggregator และวิดีโอ และเทคนิคที่ Artyom ใช้ในงานจริง ตัวเลขที่พูดกันในห้อง เราตรวจกับแหล่งข้อมูลแล้ว และแก้ไขในจุดที่จำเป็น
มีข้อแม้หนึ่งข้อก่อนสรุปอะไรทั้งหมด แต่ละโมเดลในแต่ละโจทย์มีผลลัพธ์เพียงภาพเดียว ไม่ได้ปรับ prompt ให้เข้ากับโมเดล และไม่ได้ให้ภาพอ้างอิง นี่คือภาพรวมแบบ “แกะกล่อง” ไม่ใช่การจัดอันดับ ถ้าปรับ prompt และใส่ภาพอ้างอิง ทั้งห้าตัวจะทำได้ดีกว่านี้ แต่การใช้แบบ “แกะกล่อง” นี่แหละที่ทำให้เห็นจุดอ่อนของแต่ละโมเดลชัดที่สุด
เลือก AI สร้างภาพตัวไหนให้เหมาะกับงาน
| งาน | เริ่มจาก | เหตุผล |
|---|---|---|
| ภาพนิ่งแบบฉากภาพยนตร์ | Seedream 5, Nano Banana 2.1 | มีมิติ แสงไฟอุ่น ๆ ตัวละครดูตั้งใจกับสิ่งที่ทำ |
| แบนเนอร์โฆษณาที่มีข้อความ | GPT Image 2.5, Seedream 5, Nano Banana 2.1 | อ่านเส้นทาง ข้อเสนอ และปุ่มได้ชัด GPT ให้สีสดที่สุด |
| ภาพประกอบเชิงศิลปะ | Seedream 5, Nano Banana 2.1 | Seedream มีแสงเรือง ๆ และพื้นผิวแบบภาพวาด Nano Banana ให้สไตล์ที่คมชัด |
| ภาพไลฟ์สไตล์ | GPT Image 2.5, Seedream 5 | พื้นผิวเป็นธรรมชาติ GPT ให้เห็นสภาพแวดล้อมมากกว่า Seedream ให้ภาพที่ใกล้กว่า |
| คนที่ดูเหมือนจริง | Seedream 5 พร้อมภาพอ้างอิง | ถ้าไม่มีภาพอ้างอิง ผิวจะดู “เป็นพลาสติก” ถ้ามี จะเป็นโมเดลที่ควบคุมได้มากที่สุด |
| รูปทรงและพื้นที่ | GPT Image 2.5, Seedream 5 | รักษาสัดส่วนของวัตถุและโครงสร้างของฉากได้ดีกว่าตัวอื่น |
Ideogram 4.5 และ FLUX 3 ไม่ติดรายชื่อตัวเลือกแรกในโจทย์ไหนเลย จุดพลาดประจำของทั้งสองคือแสงและเงาที่ไม่เข้ากับฉาก รายละเอียดที่มากเกินไป และวัตถุแปลกปลอมที่โผล่มาในภาพ
โมเดลที่นำมาเปรียบเทียบ
ทั้งห้าโมเดลเป็นของใหม่ อายุตั้งแต่หนึ่งถึงเก้าเดือน GPT Image 2.5 เป็นโมเดลของ OpenAI ใน ChatGPT ใช้ชื่อ ChatGPT Images 2.5 และออกเมื่อ 8 กันยายน 2569 Seedream 5 เป็นโมเดลของ ByteDance บริษัทเดียวกับที่ทำ TikTok และ CapCut ไลน์นี้ออกในเดือนกุมภาพันธ์ และมีเวอร์ชัน Pro ตามมาก่อนกลางปี Nano Banana 2.1 จาก Google ออกเมื่อ 6 ตุลาคม Ideogram 4.5 ออกเมื่อ 30 กันยายน และ FLUX 3 Image จาก Black Forest Labs บริษัทสัญชาติเยอรมัน ออกเมื่อ 1 ตุลาคม
เกณฑ์เปรียบเทียบมีหกข้อ ซึ่งจะอธิบายละเอียดด้านล่าง ได้แก่ วัสดุ แสง กายวิภาค องค์ประกอบภาพ ข้อความ และความแม่นยำในการทำตามโจทย์ Qwen-Image-2.0 จาก Alibaba ไม่ได้อยู่ในการทดสอบนี้ เราเขียนถึงมันแยกไว้แล้ว (ภาษารัสเซีย)
ทดสอบที่ 1 พ่อครัวกับการทำฟลัมเบ
โจทย์คือภาพระยะกลางแบบภาพยนตร์ พ่อครัวกำลังโยนผักในจังหวะที่ไฟลุกจากการทำฟลัมเบ มือและกระทะอยู่ในโฟกัส ใบหน้าสงบ สายตามองอาหาร ไม่ได้มองไฟ แสงอุ่น ไอน้ำ เลนส์ 85 มม. สีแบบฟิล์ม Kodak Portra 400
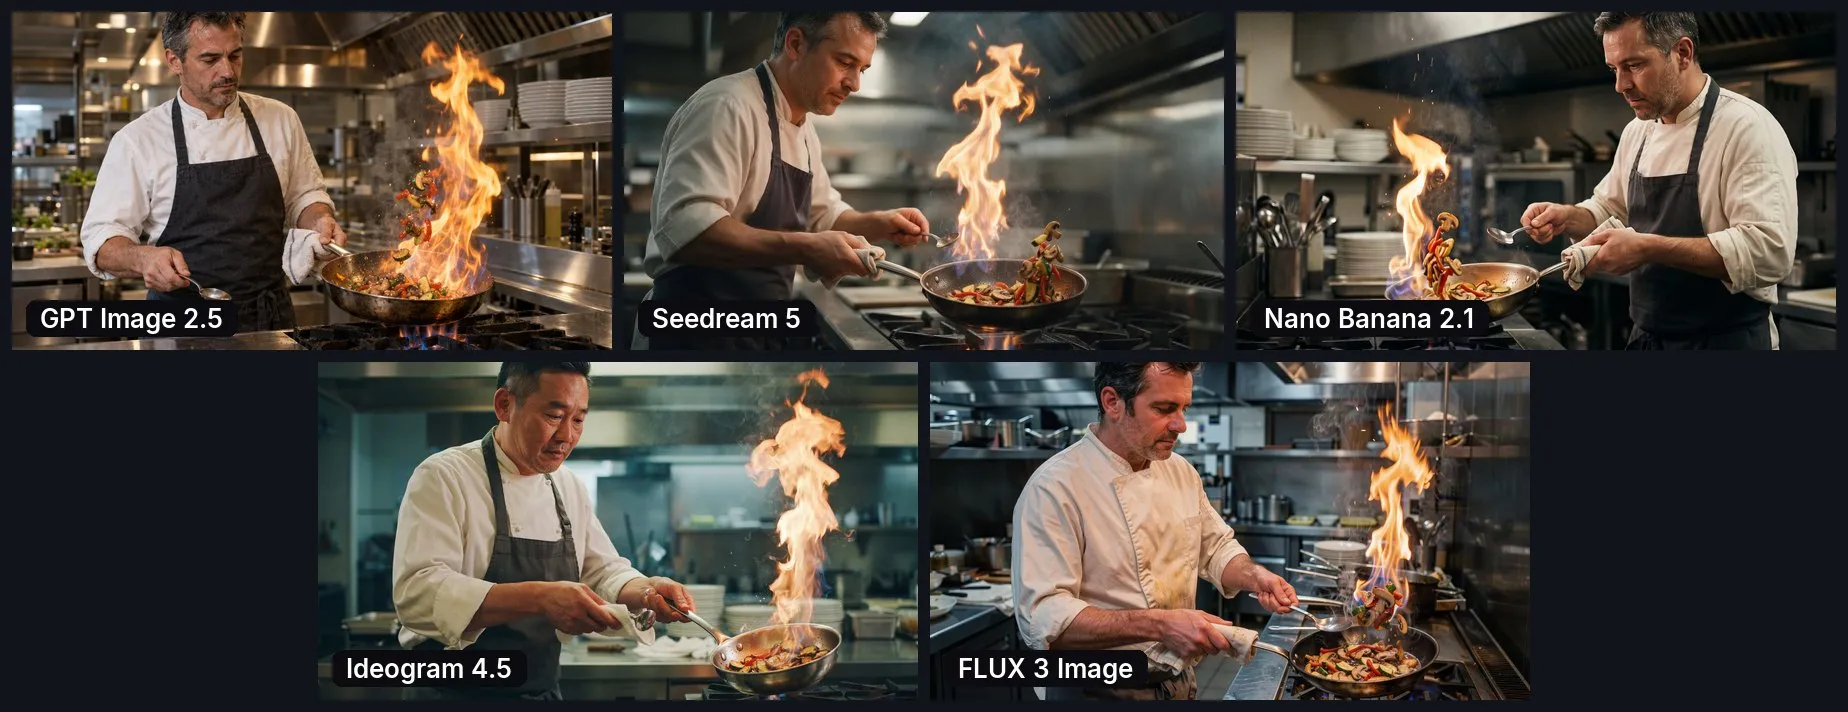
GPT Image จัดองค์ประกอบภาพได้ดี แต่มาพร้อมเกรนที่เป็นเอกลักษณ์ของมัน คือระลอกละเอียดทั่วทั้งภาพ เห็นชัดที่สุดบนผ้าและผิวหนัง พอดูใกล้ ๆ จะเหมือนภาพเลอะ และภาพแบบนี้บอกได้ทันทีว่าเป็นภาพที่ AI สร้าง ไม่ต้องเป็นผู้เชี่ยวชาญก็ดูออก นอกจากนั้นกระทะยังใหญ่ผิดปกติ และไฟเยอะจนเครื่องดูดควันน่าจะติดไฟไปแล้ว Seedream ให้แสงและองค์ประกอบที่ดี แต่ผิวและวัสดุดูเป็นพลาสติก Nano Banana ไม่มีนอยส์ แต่ครัวดูเหมือนของเล่น พ่อครัวถูกบีบอยู่ในพื้นที่สามเหลี่ยมแคบ ๆ และเครื่องดูดควันไม่ได้อยู่เหนือเตา โมเดลนี้พยายามใส่รายละเอียดให้มากที่สุด จนจมอยู่ในรายละเอียดเหล่านั้นเอง
Ideogram มีความเป็นพลาสติกน้อยกว่า ผ้ายับอย่างเป็นธรรมชาติ สายตามองตรงจุด แต่ทัพพีบิดเบี้ยว ส่วน FLUX ผักบางชิ้นกระเด็นออกจากกระทะ เห็ดกับช้อนใหญ่เกินสัดส่วน และแสงส่องออกมาจากข้างในเครื่องดูดควันเหมือนมีหลอดไฟซ่อนอยู่ สำหรับงานโฆษณา แบบนี้คือภาพเสีย
เกรนของ GPT มาจากไหน ในห้องเถียงกันอยู่พักหนึ่ง Artyom สันนิษฐานว่านี่คือวิธีที่ OpenAI ใช้ทำเครื่องหมายบนภาพของตัวเอง เครื่องหมายมีอยู่จริง ตั้งแต่พฤษภาคม 2569 OpenAI ฝังลายน้ำที่มองไม่เห็นชื่อ SynthID ของ Google และเมทาดาทา C2PA ลงในภาพ แต่ทั้งสองอย่างออกแบบมาให้ตามองไม่เห็น และยังไม่มีใครยืนยันว่ามันเกี่ยวกับเกรนที่มองเห็นได้ ข้อสรุปในทางปฏิบัติไม่เปลี่ยน: เกรนมีอยู่ และคุณต้องลบมันออก
ทดสอบที่ 2 แบนเนอร์โฆษณาที่มีข้อความภาษารัสเซีย
แบนเนอร์ 16:9 สำหรับโฆษณาแบบเจาะกลุ่มเป้าหมาย: บริการรับส่งจากสนามบินกรุงเทพฯ ไปพัทยา พื้นหลังสีเหลืองกับสีเทาเข้ม มาสคอตคือช้าง Kiki ใส่เสื้อคอเต่าสีส้มและแว่นสีเหลือง ถือแท็บเล็ตตารางเที่ยวบิน ข้อความกำหนดไว้แน่นอนเป็นภาษารัสเซีย ได้แก่ เส้นทาง “ไม่ต้องจ่ายล่วงหน้า รอรับที่ทางออก” “เริ่มต้น 1,200฿” และ “จองเลย”
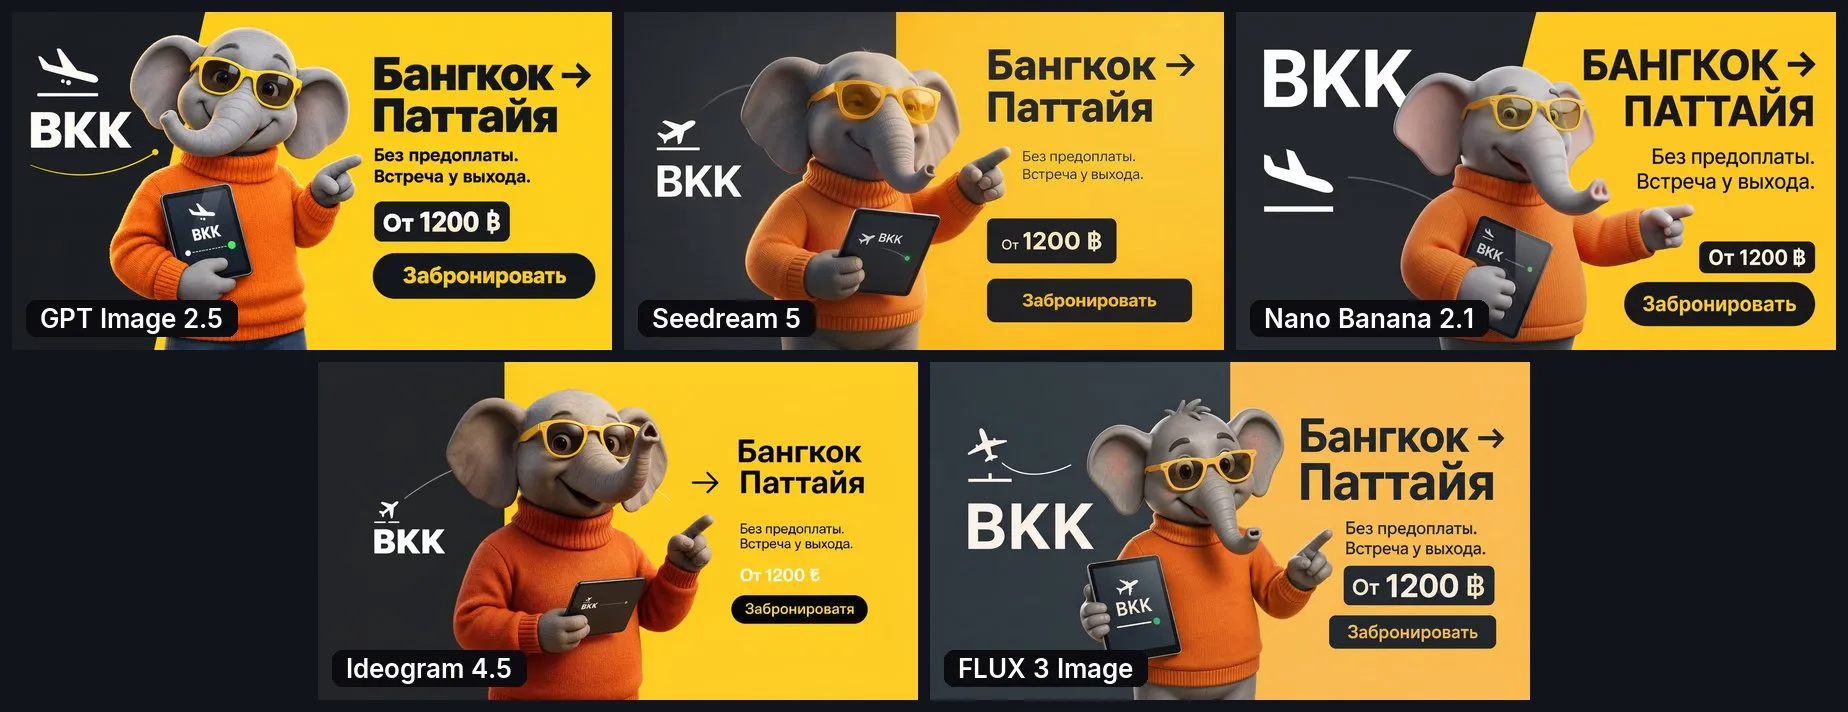
ข่าวใหญ่ของการทดสอบนี้คือ อักษรซีริลลิกไม่ใช่ปัญหาอีกต่อไป ทั้งห้าโมเดลเขียนข้อความภาษารัสเซียได้ ทั้งที่เมื่อก่อนเรื่องนี้คือจุดที่ปวดหัวที่สุดของการสร้างภาพ ผลที่ดีที่สุดเป็นของ GPT สีอิ่ม เกือบเป็นนีออน ซึ่งเป็นสิ่งที่แบนเนอร์ต้องการเพื่อหยุดนิ้วที่กำลังเลื่อนฟีด บนโปรเจกเตอร์จะมองไม่เห็นข้อนี้ แต่บนจอมอนิเตอร์เห็นชัดมาก ฟอนต์ออกมาเรียบ ๆ แต่จากประสบการณ์ของ Artyom ถ้าอธิบายฟอนต์ที่ต้องการไว้ใน prompt โมเดลจะนำไปใช้
ช้างของ Seedream ดูเป็นพลาสติก คนในห้องสังเกตว่าช้างทุกตัวมีนิ้วสี่นิ้ว และเสื้อผ้าก็ไม่ตรงกัน บางโมเดลให้ช้างใส่กางเกงยีนส์ บางโมเดลใส่รองเท้าแต่เหมือนไม่ได้ใส่กางเกง Nano Banana ใกล้เคียงกับสองตัวแรก ช้างของมันสะอาดตาและดู “แบบดิสนีย์” Ideogram ได้ช้างที่ “เหมือนคน” ที่สุดและเสื้อผ้าสมจริงที่สุด แต่ข้อความพลาด: บนปุ่มเขียนว่า “Zabronirovatya” ซึ่งเป็นคำว่า “จองเลย” ภาษารัสเซียที่สะกดเพี้ยน และแทนที่จะเป็นสัญลักษณ์เงินบาท กลับเป็นสัญลักษณ์ลีราตุรกี ส่วน FLUX หันเครื่องบินผิดทาง ทำตาม prompt ได้ราวเก้าสิบเปอร์เซ็นต์
นิสัยที่ควรติดตัวไปจากการทดสอบนี้คือ ตรวจข้อความ ตัวเลข และสัญลักษณ์สกุลเงินทีละตัวอักษร แม้แวบแรกจะอ่านได้ครบทุกอย่างก็ตาม ราคาผิดบนแบนเนอร์มีต้นทุนสูงกว่าความผิดพลาดในภาพแบบอื่น เพราะคุณจ่ายเงินให้ทุกการแสดงผลของครีเอทีฟนั้น ถ้าข้อเสนอต้องถูกต้องทุกตัวอักษร วิธีที่ปลอดภัยกว่าคือให้ AI สร้างฉาก แล้วค่อยใส่ราคาและปุ่มในโปรแกรมแต่งภาพ
ทดสอบที่ 3 ภาพประกอบเชิงศิลปะ
นักเต้นหญิงในสวนเขตร้อนช่วงบลูอาวร์ ปลายผ้าพันคอไหมของเธอกลายเป็นปลาห้าตัวที่ลอยอยู่กลางอากาศ พื้นผิวแบบภาพวาด สีทอง สีปะการัง สีเทอร์ควอยซ์ และสีคราม ไม่มีตัวอักษรใด ๆ
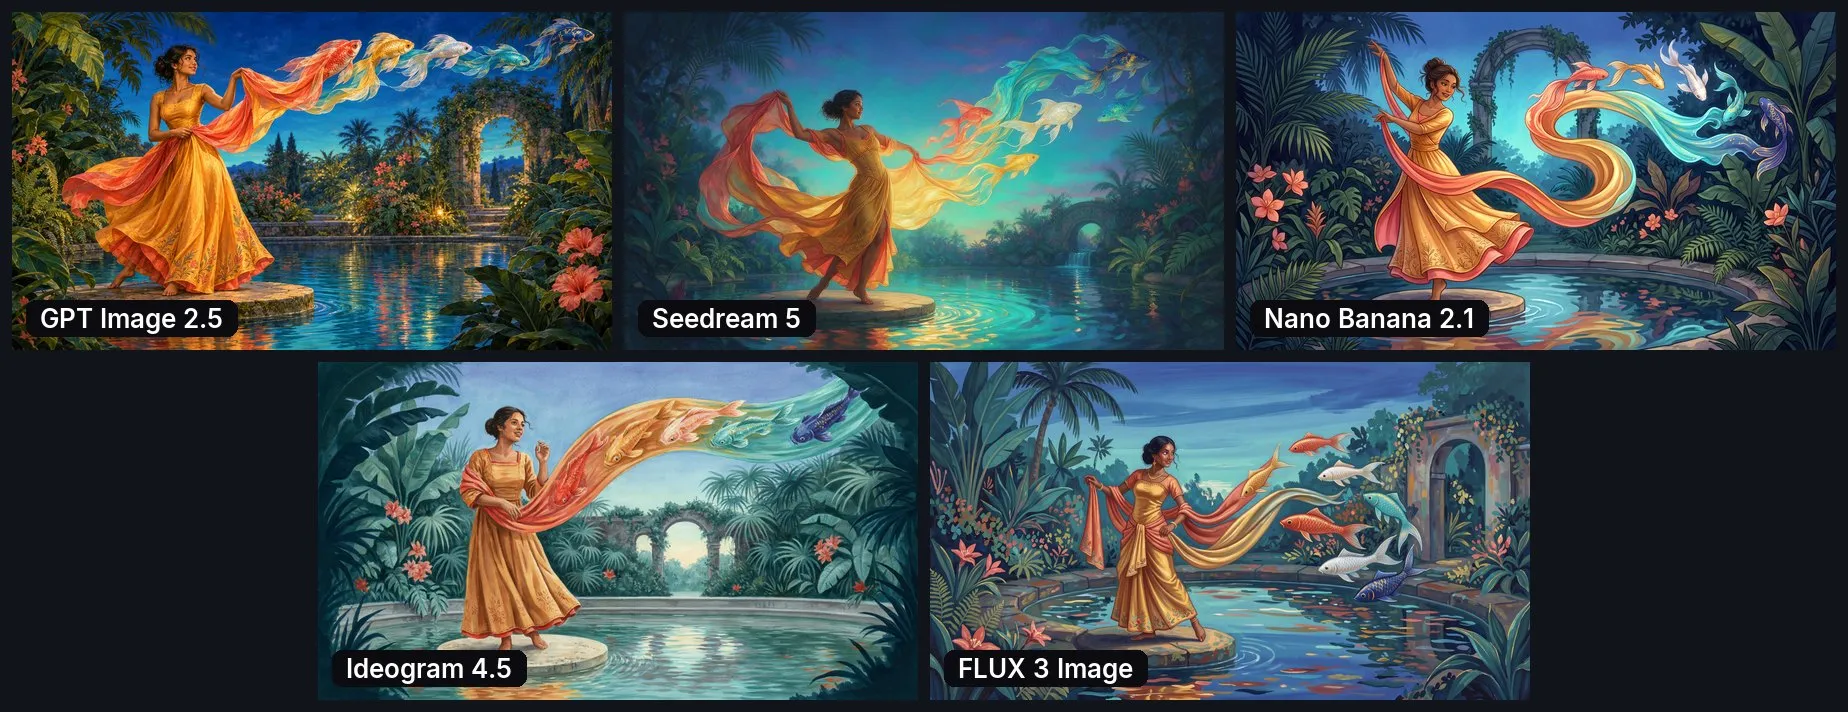
GPT ทำตามโจทย์ได้แม่นที่สุด ปลาครบห้าตัวและงอกออกมาจากผ้าพันคอ แต่เกรนในภาพนี้ชัดกว่าที่ไหน ๆ ใบไม้เล็ก ๆ ทำให้ทั้งภาพดูเป็นระลอก แถมยังมีปัญหาที่เท้าและนิ้ว Seedream สร้างฉากหน้าและฉากหลังได้ แต่ปลาหลุดออกจากผ้าไปว่ายเอง และแสงสะท้อนบนน้ำก็โผล่มาโดยไม่รู้ว่ามาจากไหน Nano Banana ไปทางสไตล์การ์ตูน ขาหายไปข้างหนึ่ง และทำปลาเป็นสีขาว Ideogram กับ FLUX ใส่สีและรายละเอียดมากเกินไปจนคนทั้งห้องเรียกผลงานนี้ตรงกันว่า “บอลลีวูด”
ทดสอบที่ 4 ภาพเหมือนจริง: เซิร์ฟกับ Volkswagen
ภาพสำหรับนิตยสารเซิร์ฟ: หญิงสาวในชุดว่ายน้ำวันพีซสีเทอร์ควอยซ์ถือกระดานยืนข้าง Volkswagen T2 วินเทจ มีมหาสมุทร แสงกลางวันอุ่น ๆ ผมเปียก ผิวดูมีชีวิต และกำหนดสัดส่วนกับรูปทรงของรถไว้แยกต่างหาก
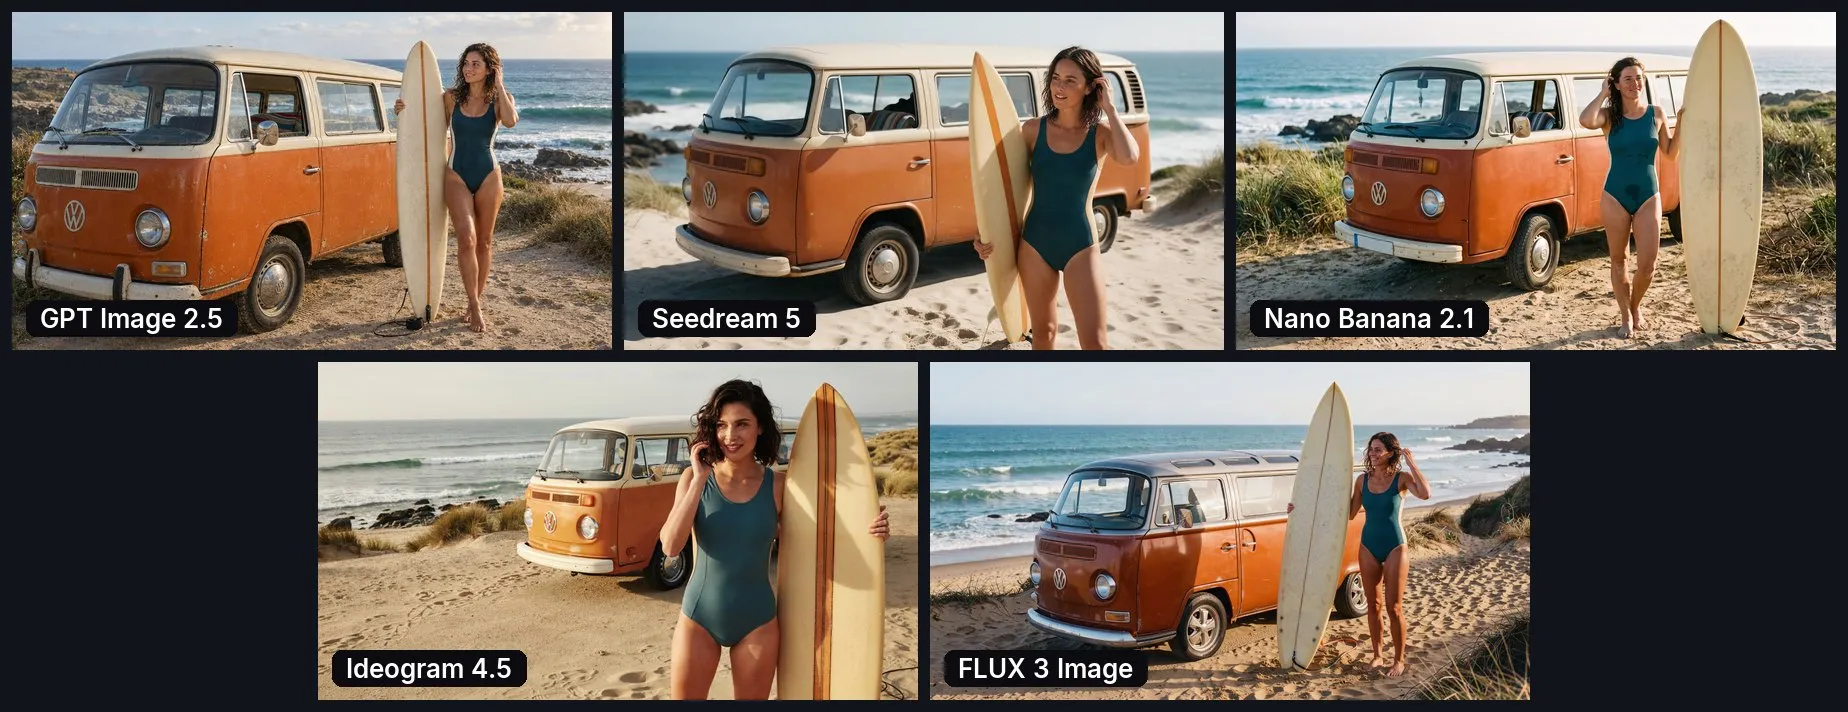
GPT จัดองค์ประกอบถูก แม้หญิงสาวจะสูงเกินไปเมื่อเทียบกับรถแบบนี้ แต่รายละเอียดของมันดีที่สุด ทั้งทราย คราบสกปรกบนตัวรถ โลหะเก่า ก้อนหิน และหญ้าที่ถูกแดดเผาจนซีด ภาพดูเหมือนฟิล์มยุคเก้าศูนย์ Seedream สะอาดตา แต่ผิวก็เป็นพลาสติกอีกแล้ว Nano Banana ทำให้ชุดว่ายน้ำดู “เปียก” แต่องค์ประกอบภาพไม่ลงตัว ส่วน Ideogram กับ FLUX แสงไม่สอดคล้องกัน เงาของกระดานตกลงบนรถ ทั้งที่ดวงอาทิตย์อยู่อีกด้าน แถมยังมีขวดพลาสติกและล้อแม็กสมัยใหม่บนรถตู้วินเทจหลุดเข้ามาในภาพ
ตรวจภาพที่ AI สร้างก่อนเผยแพร่ยังไง
กับดักหลักที่ Artyom พูดถึงตลอดทั้งงานคือ แวบแรกจะรู้สึกว่า “สวย” เสมอ สร้างภาพ ชอบ แล้วก็โพสต์ จากนั้นทุกคนที่เห็นโฆษณาก็สังเกตเห็นเครื่องดูดควันที่เรืองแสงจากข้างใน ช้างที่ไม่ได้ใส่กางเกง หรือเงาที่ตกผิดทาง เพราะฉะนั้นหลังจากความประทับใจแรก ต้องตามด้วยการตรวจหกข้อทุกครั้ง
- วัสดุ ผิว ผ้า โลหะ อาหาร มีความเป็นพลาสติก เกรน หรือ “จุดเม็ด ๆ” หรือเปล่า
- แสง มาจากไหน ในฉากมีแหล่งแสงแบบนั้นจริงไหม เงาและแสงสะท้อนสอดคล้องกันหรือเปล่า
- กายวิภาค มือ นิ้ว ท่าทาง และวิธีที่คนถือสิ่งของ เช่น กระทะ กระดาน แท็บเล็ต
- องค์ประกอบและสัดส่วน มีวัตถุหลักไหม ขนาดของสิ่งของสมเหตุสมผลหรือเปล่า เครื่องดูดควันอยู่เหนือเตาไหม
- ข้อความ อักษรซีริลลิก ตัวเลข สัญลักษณ์สกุลเงิน และอ่านข้อเสนอบนมือถือออกหรือเปล่า
- โจทย์ ทำการกระทำตามที่สั่งไหม จำนวนวัตถุตรงไหม รักษาสไตล์ไว้ได้หรือเปล่า
ดูบนจอใหญ่และซูมเข้าไปดู เกรนของ GPT และสีที่จัดจ้านเกินไปจะเห็นบนจอมอนิเตอร์ แต่จะหายไปในภาพตัวอย่างขนาดเล็กและบนโปรเจกเตอร์
ภาพอ้างอิงได้ผลกว่าการสั่งสร้างใหม่
มีคนในห้องถามว่า ถ้าเอาภาพจาก GPT ไปให้อีกโมเดลใช้เป็นต้นแบบล่ะ Artyom เตรียมการทดลองนี้ไว้ล่วงหน้าแล้ว Seedream ได้ภาพของ GPT เป็นภาพอ้างอิง และเกรนก็หายไป เวอร์ชันที่สองเขาทำจากภาพถ่ายวินเทจของนักเซิร์ฟหญิงที่หาเจอในการค้นหา Seedream รับบรรยากาศและสีแบบฟิล์มมาได้
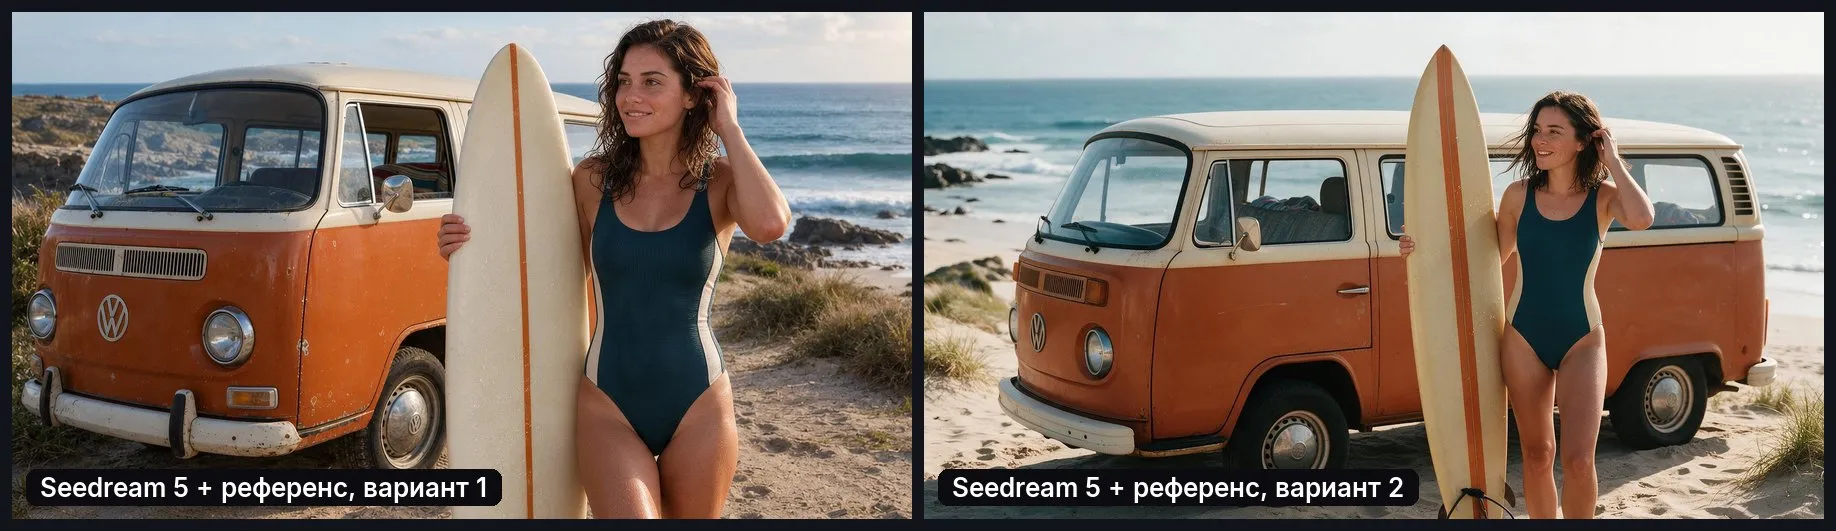
ถ้าใช้แค่ prompt ข้อความ Seedream จะให้ภาพที่ดูเป็นพลาสติก แต่ถ้ามีภาพอ้างอิงและคำแนะนำชัดเจนว่าจะทำอะไรกับภาพนั้น มันคือโมเดลที่ควบคุมได้มากที่สุดในห้าตัว และสำหรับภาพคนที่ดูเหมือนจริง Artyom ก็เริ่มจากตัวนี้ เขาเล่าสถานการณ์ใช้งานจริงของร้านเสื้อผ้า: ต้องการภาพนางแบบในชุดว่ายน้ำในท่าที่กำหนด คุณให้ Seedream ดูภาพถ่ายท่านั้น ภาพสเก็ตช์ของท่าเดียวกัน และภาพจากการถ่ายครั้งก่อน ๆ ของนางแบบตัวจริงของคุณ Artyom บอกว่ามันจะทำท่าได้ตรงถึงตำแหน่งนิ้วก้อย และผิวจะดูเหมือนในการถ่ายภาพจริง
เขียน prompt สร้างภาพยังไง
ถ้าสั่งว่า “วาดพ่อครัวถือกระทะ” โมเดลก็ทำให้ได้ แต่แทบแน่นอนว่าคุณจะไม่ชอบผลลัพธ์ เพราะทุกอย่างที่คุณไม่ได้บอก โมเดลจะคิดเติมเอง prompt ที่ Artyom ใช้งานจริงประกอบด้วยสิบส่วน ได้แก่ ประเภทช็อต ฉาก การกระทำ พฤติกรรมของตัวละคร แสง บรรยากาศ เลนส์ วัสดุ สี และข้อจำกัด ในการทดสอบพ่อครัว หน้าตาเป็นแบบนี้: ภาพระยะกลางแบบภาพยนตร์ ครัวมืออาชีพ การทำฟลัมเบ สายตาสงบมองอาหาร แสงจากไฟและโคมเพดาน ไอน้ำและหยดน้ำ เลนส์ 85 มม. ระยะชัดตื้น ผิวคนและเหล็กกล้าที่ดูเป็นธรรมชาติ ฟิล์ม Kodak Portra 400 พ่อครัวคนเดียว และไม่มีการรีทัช
ทุกวันนี้แทบไม่มีใครเขียน prompt แบบนี้ด้วยมือแล้ว คนส่วนใหญ่ขอให้ ChatGPT หรือ Claude เขียนให้ หรือใช้สกิลสำเร็จรูป และมีอีกเทคนิคที่ประหยัดเวลาได้มากที่สุด: เจอภาพในเน็ตที่ชอบ ดาวน์โหลดมา ส่งให้ ChatGPT แล้วขอให้อธิบายฉาก แสง กล้อง และเลนส์อย่างละเอียด นี่คือฐานของ prompt ที่พร้อมใช้ เหลือแค่ใส่โจทย์ของคุณเข้าไป
ยาวกว่าไม่ได้แปลว่าดีกว่า Artyom เคยลอง prompt ยาวถึง 15,000 ตัวอักษร ถ้าในนั้นมีข้อขัดแย้งหรือน้ำเยอะ โมเดลจะไม่ข้ามบางส่วนไป แต่จะผสมทุกอย่างจนเละ สิ่งที่ต้องการคือรายละเอียดที่ชัดเจน ไม่ใช่ความยาวแบบเรียงความสมัยเรียน
AI สำหรับทำการ์ดสินค้าบนมาร์เก็ตเพลส
เคสที่ติดดินที่สุดของคืนนั้น เพื่อนของ Artyom ขายกระเป๋าใส่อุปกรณ์ฮอกกี้บน Wildberries (มาร์เก็ตเพลสรายใหญ่ของรัสเซีย) และที่มีอยู่ก็มีแค่ภาพสินค้าบนพื้นขาวจากหลายมุม ขั้นตอนเป็นแบบนี้: ส่งภาพให้โมเดลภาษา (ของ Artyom คือ Claude) โมเดลวิเคราะห์สินค้าและกลุ่มลูกค้าแล้วเขียน prompt ละเอียด จากนั้นให้ GPT Image เป็นคนวาด รถของเล่นก็ผ่านขั้นตอนเดียวกัน ทั้งที่ตอนเริ่มมีแค่ภาพบรรจุภัณฑ์จากโรงงานในจีน
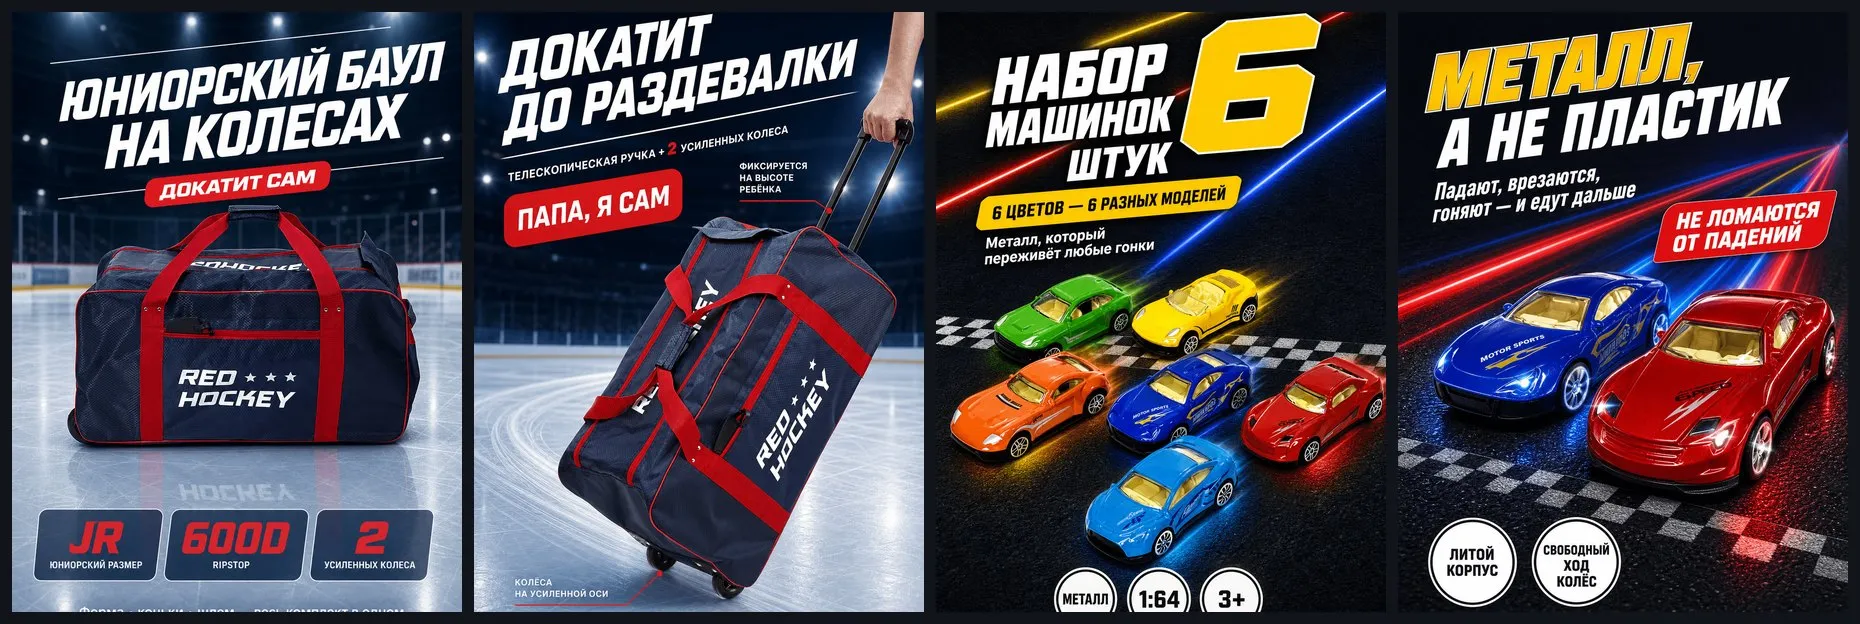
สดใส ตัวใหญ่ มีจุดเด่นของสินค้าอยู่บนการ์ดเลย ซึ่งเป็นสิ่งที่ต้องมีเพื่อให้โดดเด่นในผลค้นหาของ Wildberries หรือ Ozon ตรงนี้สีจัดจ้านของ GPT กลายเป็นข้อดี
Aggregator ของ AI: Higgsfield, Magnific, Artlist, Weavy
ถ้าคุณต้องการแค่ GPT ก็ใช้ ChatGPT ไป แต่ถ้าต้องเปรียบเทียบ aggregator จะสะดวกกว่า เพราะรวมโมเดลสร้างภาพ วิดีโอ และเสียงหลายสิบตัวไว้ในอินเทอร์เฟซเดียว Artyom แนะนำสี่ตัว Higgsfield เน้นงานภาพยนตร์และคลิปโฆษณา Magnific คือ Freepik เดิม ในเดือนเมษายน 2569 บริษัทเปลี่ยนชื่อตามเครื่องมืออัปสเกลของตัวเอง Artlist เป็นที่รู้จักจากเพลงสต็อก และตอนนี้ขายบริการสร้างภาพและวิดีโอด้วย Weavy ถูก Figma ซื้อไปเมื่อตุลาคม 2568 ตอนนี้ผลิตภัณฑ์ใช้ชื่อ Figma Weave
Artyom ชอบ Weavy เพราะแผนผังแบบโหนด เขียน prompt ในหน้าต่างเดียว ลาก “โหนด” จาก prompt ไปยังห้าโมเดล กดปุ่มเดียว ทุกตัวก็สร้างภาพพร้อมกัน ในโหนดถัดไปส่งภาพที่ดีที่สุดเข้าโมเดลวิดีโออย่าง Seedance หรือ Kling ได้ และเชื่อมภาพอ้างอิงเข้ากับฉากได้ เช่น เสื้อแจ็กเก็ตและกางเกงที่นางแบบต้องใส่ ภาพหน้าจอด้านล่างคือการเปรียบเทียบห้าโมเดลเดิม
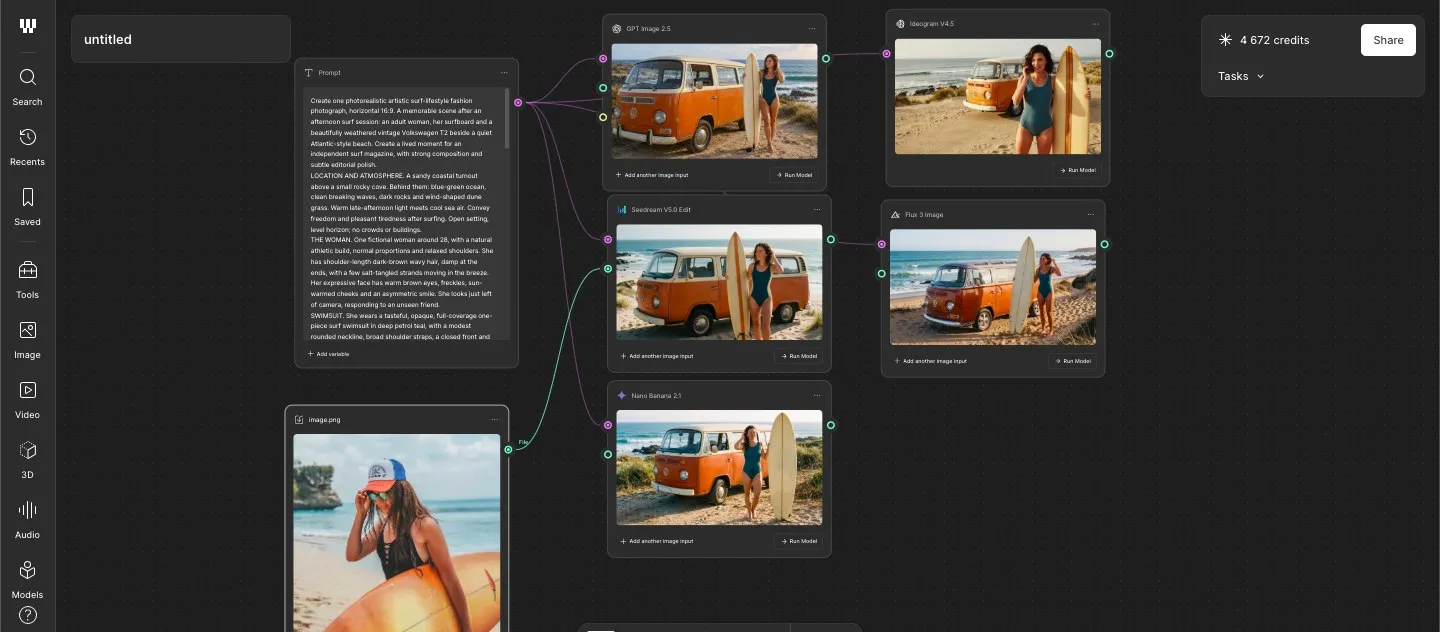
รายละเอียดสำคัญที่ทำให้หลายคนแปลกใจ: โมเดลเดียวกันกับ prompt เดียวกันให้ผลต่างกันใน aggregator แต่ละเจ้าและในแชทของผู้พัฒนาเอง บริการเหล่านี้แข่งกัน และผสม “ตัวปรับ prompt” กับพรีเซ็ตของตัวเองเข้าไป ดังนั้น “GPT ใน Higgsfield” กับ “GPT ใน ChatGPT” จึงไม่ใช่ของเดียวกัน และต้องเลือกบริการที่ดีที่สุดตามงาน
บริการต่าง ๆ กำลังไปทางอัตโนมัติมากขึ้น ตัวอย่างเช่น Krea เปิดตัว Ad Studio: เอเจนต์ศึกษาร้านค้าออนไลน์เอง ทั้งสินค้า สี และฟอนต์ แล้วทำโฆษณากับโพสต์โซเชียลให้ เดิมพันนั้นชัดเจน คนส่วนใหญ่จะไม่มานั่งศึกษาโมเดล พวกเขาต้องการแค่ปุ่มเดียว Higgsfield ก็โตมาจากความขี้เกียจแบบเดียวกันนี้ ในเดือนกันยายน 2569 บริษัทประกาศว่ามีอัตรารายได้ต่อปีแตะ 1 พันล้านดอลลาร์ นี่ไม่ใช่เงินพันล้านที่หาได้จริงในหนึ่งปี แต่เป็นรายได้ช่วงหลายเดือนล่าสุดที่คูณขึ้นเป็นทั้งปี ถึงอย่างนั้นการเติบโตในรอบปีก็ราวยี่สิบเท่า
แพ็กเกจที่ Artyom เปรียบเทียบเมื่อ 2 พฤศจิกายน 2569 แบบจ่ายรายเดือน ไม่รวมภาษี:
| บริการ | แพ็กเกจ | ราคา | ได้อะไร |
|---|---|---|---|
| Higgsfield | Plus | $59/เดือน | 1,200 เครดิต ภาพ วิดีโอ และเอฟเฟกต์ มี “ช่วงไม่จำกัด” เป็นครั้งคราว |
| Magnific | Premium+ | $45/เดือน | 45,000 เครดิต สร้างภาพและอัปสเกล ไม่จำกัดในบางโมเดล |
| Artlist | AI Core | $39.99/เดือน | 40,000 เครดิต ภาพ วิดีโอ เสียงพูด และเพลง พร้อมสิทธิ์ใช้งานเชิงพาณิชย์ |
| Weavy (Figma Weave) | Professional | $45/เดือน | 4,000 เครดิต workflow และโมเดลภาษา ยกเครดิตไปใช้ต่อได้นานสุด 3 เดือน |
ถ้าจ่ายรายปีจะถูกกว่า เช่น Artlist AI Core ราคา $23.99 ต่อเดือน เครดิตของแต่ละบริการไม่เหมือนกัน จึงเอามาเทียบกันตรง ๆ ไม่ได้
คำว่า “ไม่จำกัด” ต้องระวัง ช่วงกลางปี Artlist ขายแพ็กเกจรายปีราว $500 พร้อม Seedance 2.5 แบบไม่จำกัด ซึ่งเป็นโมเดลวิดีโอที่แพงที่สุด Artyom ซื้อไว้ และสร้างคลิปได้หลายร้อยคลิปในไม่กี่วัน ราวหนึ่งสัปดาห์ต่อมา สิทธิ์ไม่จำกัดก็ถูกยกเลิกในทุกแพ็กเกจ และให้เครดิตมาแทน ใน ChatGPT ก็ไม่มีการสร้างภาพแบบไม่จำกัดอย่างเป็นทางการเช่นกัน แพ็กเกจ Plus ราคา $20 จากรีวิวของผู้ใช้ได้ราว 40–50 ภาพต่อสามชั่วโมง ส่วน OpenAI ไม่ได้เปิดเผยตัวเลขของตัวเอง ในทางปฏิบัติชนเพดานนี้ได้ยาก โดยเฉพาะถ้าขอหลายแบบในครั้งเดียว
ค่าสร้างงานเท่าไร: ภาพถูก วิดีโอแพง
ใน Weavy การรัน prompt เดียวผ่านห้าโมเดลใช้เครดิตของ Artyom ราว 50 เครดิต ส่วนคลิป Seedance 2.5 หนึ่งคลิปในที่เดียวกันใช้ราว 1,350 เครดิต แปลว่าแพ็กเกจ 4,000 เครดิตพอสำหรับวิดีโอประมาณสามคลิป วิดีโอ 30 วินาทีที่ 720p พร้อมเสียง ในแต่ละบริการราคาราว $4 ถึง $9 ส่วน Kling 4.0 ที่ขึ้นชื่อว่าถูกมาตลอด ผ่านตัวแทนขายต่อราว $3.4 ต่อ 30 วินาทีที่ 720p และ $5–7 ที่ 1080p ตอนนี้ Kling ยังไม่มีราคาอย่างเป็นทางการ
Artyom มั่นใจว่าต่อไปจะแพงขึ้น และโดยรวมก็ดูเป็นไปได้ โปรโมชันช่วงเปิดตัวและแพ็กเกจไม่จำกัดทยอยหมดไปทีละอย่าง แต่ตัวเลขของเขาที่ว่า “Seedance 2.5 แพงขึ้น 10 เท่า” เรายืนยันไม่ได้ ตามราคาของบริการต่าง ๆ ในเดือนพฤศจิกายน วิดีโอหนึ่งวินาทีของเวอร์ชัน 2.5 แพงกว่าเวอร์ชัน 2.0 ราว 1.1–2 เท่า
คลิปดี ๆ ไม่ค่อยได้ตั้งแต่ครั้งแรก ปกติต้องสร้างสองถึงห้าครั้ง จึงมีกฎสองข้อ ข้อแรก ดูฉบับร่างก่อน Seedance 2.5 มีโหมด Draft ภาพตัวอย่าง 480p ถูกกว่าฉบับจริงราวสี่ถึงห้าเท่า แล้วค่อยเรนเดอร์เทคที่ชอบเป็นความละเอียดสูง ข้อสอง ตั้งงบไว้ล่วงหน้า การสร้างงานด้วย AI ทำงานเหมือนตู้สล็อต กด รอ ได้ภาพสวย แล้วถ้าครั้งต่อไปสวยกว่านี้ล่ะ Artyom เรียกอาการนี้ว่าติดการพนัน และแนะนำให้หยุดเมื่อผลลัพธ์ตอบโจทย์แล้ว
สองเคสวิดีโอ
โฆษณาของบริษัทอสังหาฯ บน Seedance 2.5 ผู้พัฒนาโครงการจากดูไบ ตัวโครงการยังเป็นแค่หลุมก่อสร้าง ที่มีอยู่มีแค่ภาพเรนเดอร์ 3D แบบวาด ทีมแปลงภาพเหล่านั้นให้ดูสมจริง และใส่ตัวละครลงในสถานที่ ผลลัพธ์คือคลิป 30 วินาที คนในห้องเห็นตรงกันว่าเป็นคลิปแบบที่คนดูจนจบ
ช่อง AI กับพ่อครัวชาวเกาหลี Artyom กับภรรยาสร้างชายชาวเกาหลีที่ไม่มีตัวตนจริง ซึ่งทำอาหารในครัวที่บ้าน คลิปทำด้วย Seedance Artyom เล่าว่าในสามเดือนช่องมีผู้ติดตาม 82,000 คน และยอดวิวต่อคลิปอยู่ที่ 150,000 ถึง 5 ล้าน ส่วนที่น่าสนใจที่สุดคือกลุ่มผู้ชม คนดูส่วนใหญ่เป็นผู้หญิง และสิ่งที่ดึงดูดพวกเธอไม่ใช่การทำอาหาร แต่เป็นภาพลักษณ์แบบพระเอกซีรีส์เกาหลี ยอดวิวหลักมาจากสหรัฐฯ อิตาลี ฝรั่งเศส และสเปน Artyom เล่าว่าใต้โพสต์ที่มีหนึ่งพันคอมเมนต์ มีแค่สองสามคนที่สังเกตว่าเป็น AI ส่วนจุดพลาดเล็ก ๆ อย่างปลาที่วางผิดชั้นแทบไม่มีใครเห็น ตัวเลขเหล่านี้เราตรวจสอบเองไม่ได้ ตอนนี้กำลังหาทางสร้างรายได้ผ่านโฆษณาแบบเนทีฟ และแพลตฟอร์มที่จับคู่บล็อกเกอร์กับผู้ลงโฆษณาต่างประเทศ
ช่องแบบนี้มีความเสี่ยงจริง ตั้งแต่ 31 สิงหาคม 2569 Instagram ขอให้โปรไฟล์ที่ใช้ตัวละคร AI ติดป้าย “AI-generated profile” ใครไม่ติด จะเสียการแนะนำใน Reels และแท็บ Explore สำหรับคนที่ยังไม่ได้ติดตาม ซึ่งก็คือเกือบทั้งหมดของยอดการเข้าถึง ส่วนที่เหลือเป็นประสบการณ์ของคนในห้อง ไม่ใช่กฎของแพลตฟอร์ม Artyom บอกว่าเขาโพสต์จากโทรศัพท์ของตัวเองโดยไม่ได้วอร์มบัญชีเลย และยังไม่เคยโดนลงโทษ คนอื่นเล่าถึงช่องที่ถูกระงับและต้องสู้กับฝ่ายซัพพอร์ตนานถึงหนึ่งปี และแนะนำให้วอร์มบัญชีใหม่ และมีช่องสำรองไว้ตั้งแต่แรก
เคล็ดลับที่ใช้ได้ตั้งแต่วันนี้
- รัน prompt เดียวผ่านสองสามโมเดลพร้อมกัน แทนที่จะวนสั่งโมเดลเดียวไม่จบ Weavy หรือ aggregator ตัวไหนก็ทำได้ในคลิกเดียว
- เขียนว่า “ทำ 10 แบบ แยกกันทีละภาพ” ChatGPT จะส่งแกลเลอรีกลับมาในคำขอเดียว
- ให้ AI บรรยายภาพของคนอื่น ส่งภาพที่ชอบให้ ChatGPT แล้วขอให้แยกฉาก แสง และเลนส์ คุณจะได้ฐานของ prompt
- prompt สำเร็จรูปของคนอื่นก็เป็นฐานได้ ส่ง prompt จากพรีเซนเทชันหรือโพสต์ให้ ChatGPT แล้วขอให้ปรับให้เข้ากับงานของคุณ
- อธิบายฟอนต์ไว้ใน prompt ไม่อย่างนั้นแบนเนอร์จะออกมาด้วยฟอนต์มาตรฐาน ราคาที่ต้องแม่นยำและปุ่ม ใส่ในโปรแกรมแต่งภาพจะปลอดภัยกว่า
- ล้างนอยส์ด้วยภาพอ้างอิง ภาพจาก GPT ที่ส่งให้ Seedream เป็นต้นแบบจะไม่มีเกรน
- สำหรับคนและเสื้อผ้า ใช้ Seedream กับภาพอ้างอิงสามภาพ ได้แก่ ภาพถ่ายท่า ภาพสเก็ตช์ท่า และภาพจากการถ่ายครั้งก่อน ๆ ของนางแบบคุณ
- สำหรับวิดีโอ ทำร่างความละเอียดต่ำก่อน แล้วค่อยทำฉบับจริง
- เทียบโมเดลเดียวกันในหลายบริการ แต่ละ aggregator วาดออกมาไม่เหมือนกัน
คำถามที่พบบ่อย
AI ตัวไหนเขียนข้อความภาษารัสเซียบนภาพได้ดีที่สุด ในการทดสอบ ทั้งห้าตัวเขียนอักษรซีริลลิกได้ แบนเนอร์โฆษณาที่ดีที่สุดมาจาก GPT Image 2.5 ข้อความอ่านง่าย สีสดที่สุด Ideogram 4.5 สะกดคำผิดและใส่สัญลักษณ์สกุลเงินผิด ยังไงก็ควรตรวจข้อความทีละตัวอักษร
AI ตัวไหนให้ภาพคนที่สมจริงที่สุด Seedream 5 แต่ต้องมีภาพอ้างอิง ถ้าใช้แค่ข้อความ ผิวจะดู “เป็นพลาสติก” แต่ถ้ามีภาพถ่ายท่าและภาพจากการถ่ายครั้งก่อน ๆ ของนางแบบจริง จะดูเหมือนการถ่ายภาพจริง
สร้างภาพใน ChatGPT ได้ไม่จำกัดไหม ไม่มีแบบไม่จำกัดอย่างเป็นทางการ แพ็กเกจ Plus ราคา $20 จากรีวิวของผู้ใช้ได้ราว 40–50 ภาพต่อสามชั่วโมง OpenAI ไม่ได้เปิดเผยตัวเลขที่แน่นอน
ทำไมโมเดลเดียวกันในแต่ละบริการวาดออกมาไม่เหมือนกัน aggregator เติม “ตัวปรับ prompt” และพรีเซ็ตของตัวเองเข้าไป ดังนั้น GPT Image ใน Higgsfield กับใน ChatGPT จะให้ภาพต่างกันจาก prompt เดียวกัน
สร้างวิดีโอราคาเท่าไร วิดีโอ 30 วินาทีใน Seedance 2.5 ที่ 720p พร้อมเสียง ราคาราว $4–9 แล้วแต่บริการ คลิปดี ๆ มักต้องลองสองถึงห้าครั้ง จึงต้องคูณตามนั้น
สรุปแล้วได้อะไร
ไม่มีโมเดลที่ดีที่สุดสำหรับทุกงาน และนี่คือข้อสรุปหลักของคืนนั้น GPT Image ทำตาม prompt ได้ดีที่สุด และให้สีที่ดึงสายตาในฟีดที่สุด แต่มีเกรนที่ต้องล้างออก Seedream แบบแกะกล่องดูเป็นพลาสติก แต่พอมีภาพอ้างอิงก็กลายเป็นเครื่องมือที่แม่นที่สุดสำหรับภาพเหมือนจริง Nano Banana สะอาดตา แต่ชอบใส่ของในฉากจนแน่น Ideogram กับ FLUX แพ้ในการทดสอบนี้ แม้ในรายละเอียดบางจุด อย่างผ้าที่ดูมีชีวิตของ Ideogram จะทำได้ดีกว่าตัวท็อป
ขั้นตอนทำงานที่ Artyom ใช้ปิดเลกเชอร์เป็นแบบนี้ ขั้นแรก ทำความเข้าใจว่าภาพจะถูกแสดงให้ใครดูและที่ไหน จากนั้นอธิบายฉากให้เป็นรูปธรรมตามสิบข้อ แล้วรัน prompt ผ่านหลายโมเดลและเลือกตัวที่ดีที่สุดสำหรับงาน หลังจากนั้นค่อยเก็บงาน ด้วยภาพอ้างอิง การปรับ prompt ให้ชัดขึ้น หรือการแก้เฉพาะจุด ไม่ใช่การสั่งสร้างใหม่ไม่รู้จบ ทุกภาพต้องผ่านการตรวจหกข้อก่อนเผยแพร่ โดยตรวจข้อความและราคาแยกอีกรอบ
วิดีโอเลกเชอร์ฉบับเต็มพร้อมคำแก้ไขบนจออยู่ในประกาศงานพบปะ (ภาษารัสเซีย) Artyom มีช่อง Telegram (ภาษารัสเซีย) และ Instagram ส่วนคำถามเรื่องภาพที่คุณสร้างเอง ส่งมาได้ที่แชทของไอที ปาร์ตี้ (ภาษารัสเซีย) เราจะช่วยดูจากตัวอย่างจริง