
หลายคนเจอ AI เอเจนต์ครั้งแรกด้วยสถานการณ์แบบเดียวกัน
ตอนแรกคือตื่นเต้น: เอเจนต์อ่านไฟล์เอง เปิดเบราว์เซอร์ เรียกเครื่องมือ เขียนโค้ด จำ context ได้ ตอบใน Telegram หรือ Discord และเริ่มดูเหมือน Jarvis ตัวเล็ก ๆ
จากนั้นความจริงก็มาถึง: ลิมิตหมดในครึ่งวัน บิล API ขึ้นจนไม่สบายใจ Claude Code กลายเป็น “พนักงานค่าตัวแพง” ขึ้นมาดื้อ ๆ ส่วน OpenClaw หรือ Hermes ก็ดูเหมือนตอบมาแค่สองสามบรรทัด แต่ข้างในเผา token ไปเป็นภูเขา
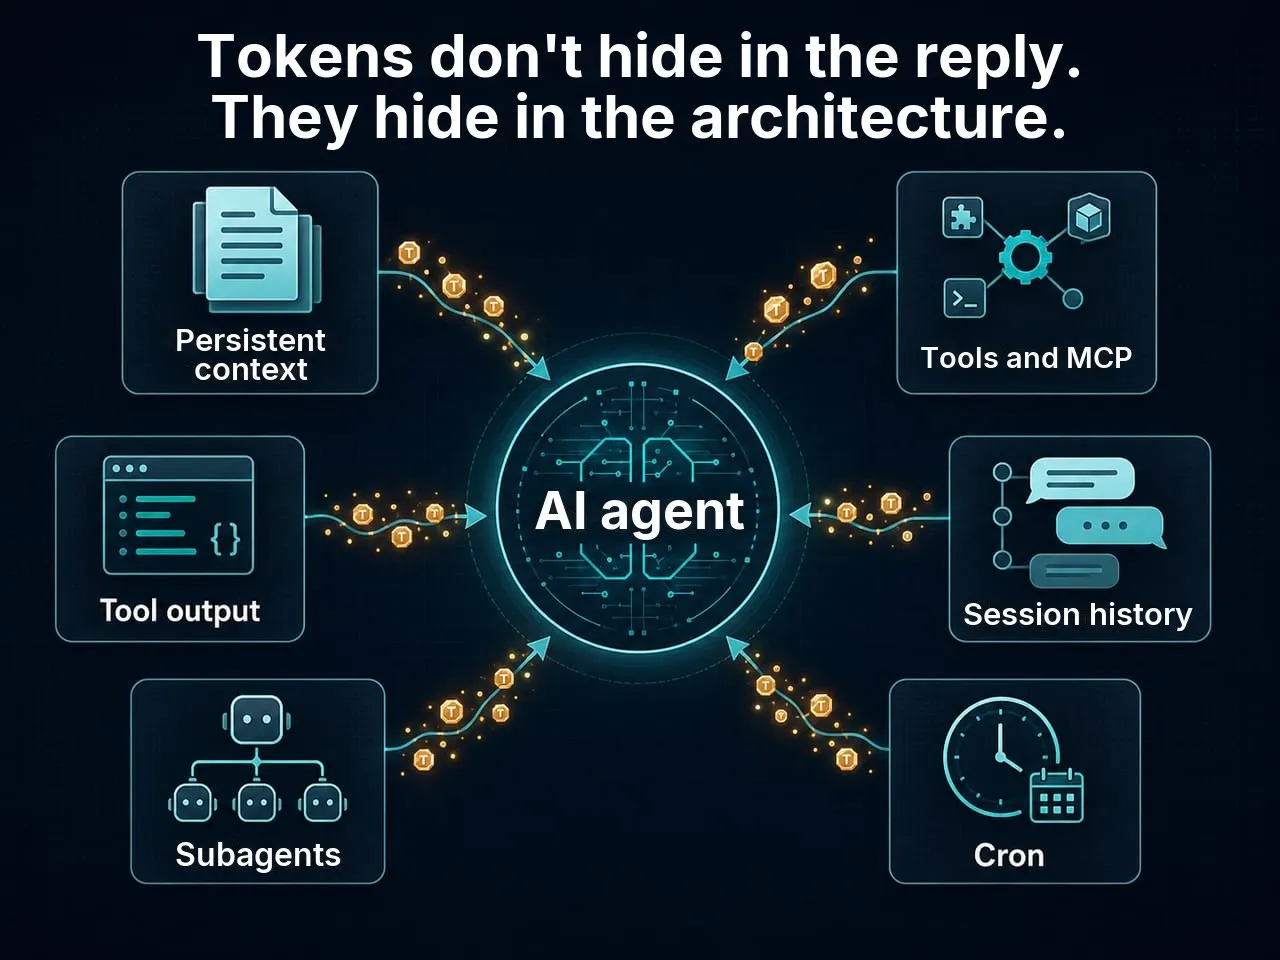
ปกติค่าใช้จ่ายจะสะสมแบบไม่ทันสังเกต:
AGENTS.md,CLAUDE.mdหรือSOUL.mdยาว ๆ ถูกโหลดทุกครั้งที่รัน- ประวัติเซสชันยาวขึ้นเรื่อย ๆ และถูกส่งให้โมเดลซ้ำ
- tools และ MCP server หลายสิบตัวพาคำอธิบายและ JSON schema ของตัวเองมาด้วย
- ผลลัพธ์ของเครื่องมือกลับเข้า context มาทั้งก้อน
- cron ปลุกโมเดลแพง ๆ ขึ้นมาเพื่อบรรทัดเดียว
- reasoning ที่เปิดไว้สร้าง token ที่มองไม่เห็นเป็นพัน ๆ
- ซับเอเจนต์ได้ context window ของตัวเองแยกกัน
- เบราว์เซอร์ shell และการค้นหาถูกเปิด “เผื่อไว้ก่อน”
จากข้างนอกมันดูเหมือนคำตอบสั้น ๆ ธรรมดา แต่ข้างในคือโรงงานเล็ก ๆ ที่โมเดลคิดหลายรอบ เรียกเครื่องมือ อ่านผลลัพธ์ คิดอีก และลาก context ตามมาด้วยมากขึ้นเรื่อย ๆ
บทความนี้ไม่ได้พูดเรื่อง “ขอให้มันตอบสั้นลง” นั่นเป็นการประหยัดที่อ่อนมาก
บทความนี้พูดเรื่องอื่น: จะออกแบบเอเจนต์ยังไงให้ทำงานเดิมได้เหมือนเดิม แต่ไม่ลากชีวิตดิจิทัลครึ่งหนึ่งของคุณไปด้วยทุกขั้นตอน
TL;DR
สรุปสั้น ๆ:
- คุณไม่ได้จ่ายต่อข้อความ แต่จ่ายทั้งลูปของเอเจนต์
- token ที่แพงที่สุดคือ token ที่ซ้ำทุกขั้นตอน
- reasoning อาจมองไม่เห็น แต่ก็ยังกินที่ และปกติคิดเงินแบบ output
- tools ไม่ได้มีราคาแค่ตอนเรียกใช้: คำอธิบาย schema และผลลัพธ์ของมันก็เข้าไปอยู่ใน context ด้วย
SOUL.mdหรือCLAUDE.mdไฟล์ใหญ่ คือภาษีที่ต้องจ่ายตลอด- งาน cron ไม่ควรปลุกโมเดลเรือธง ถ้าผลลัพธ์ตายตัวอยู่แล้ว
- การประหยัดที่ได้ผลที่สุดไม่ได้เริ่มจากการเลือกโมเดลราคาถูก แต่เริ่มจากคำถามว่า “อะไรบ้างที่โมเดลไม่จำเป็นต้องเห็นเลย?”
เรื่องสำคัญก่อน: คุณไม่ได้จ่ายต่อข้อความ
แชทธรรมดาทำงานประมาณนี้:
ผู้ใช้ -> โมเดล -> คำตอบเอเจนต์ทำงานต่างออกไป:
ผู้ใช้
  -> โมเดลคิด
  -> เรียกเครื่องมือ
  -> ได้ผลลัพธ์
  -> คิดอีกรอบ
  -> เรียกเครื่องมือตัวถัดไป
  -> ได้ผลลัพธ์อีก
  -> เขียนคำตอบ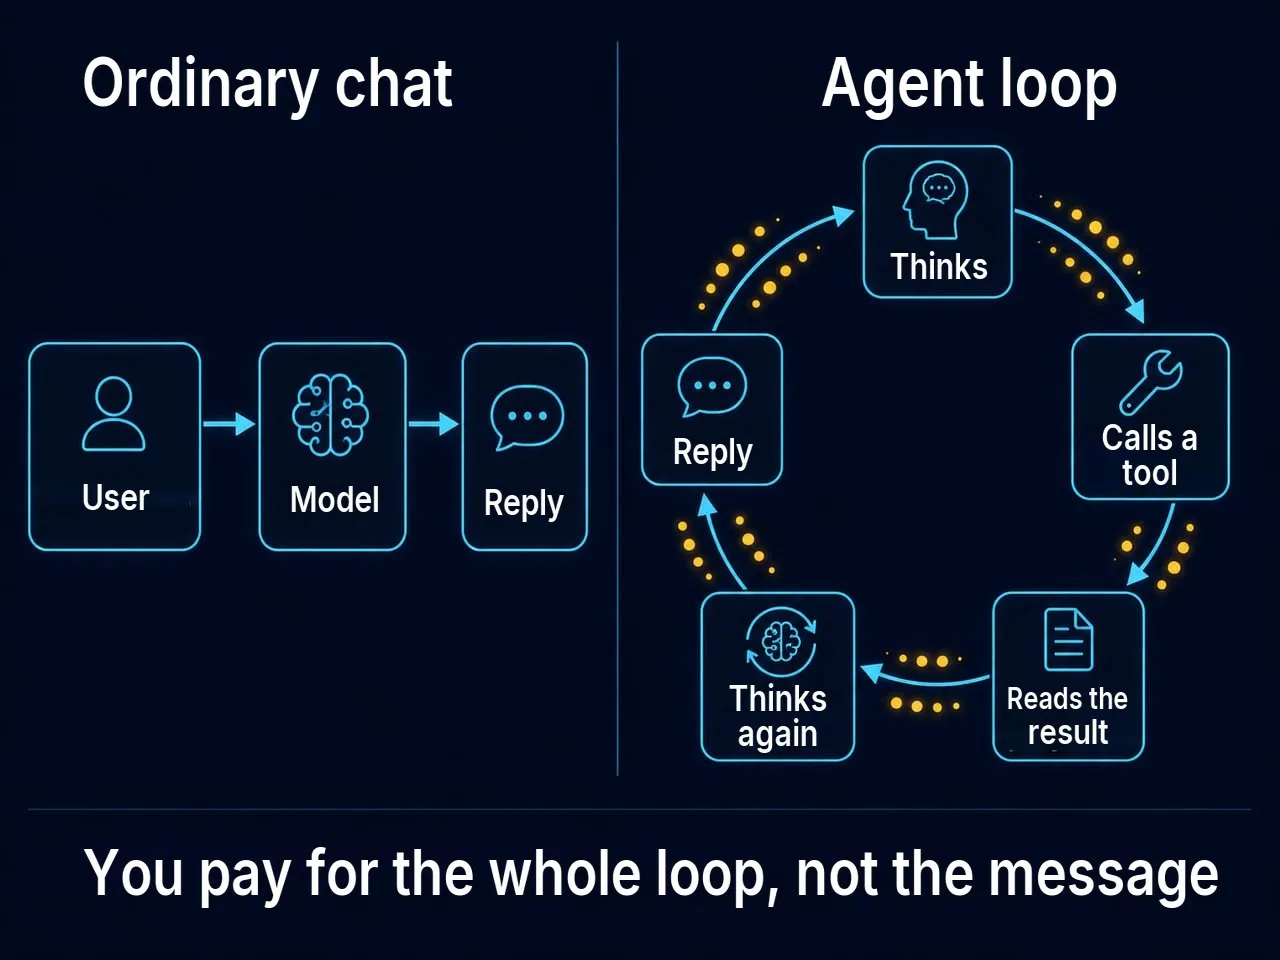
และนี่เป็นแค่กรณีง่าย ๆ
ในระบบเอเจนต์จริงจะมีของเพิ่มขึ้นมาอีก: หน่วยความจำ คำแนะนำของระบบ ไฟล์ bootstrap รายการเครื่องมือ schema ของ tool แต่ละตัว ประวัติบทสนทนา ผลลัพธ์ของการเรียกครั้งก่อน ไฟล์แนบ log และบางครั้งก็ซับเอเจนต์
ค่าใช้จ่ายคร่าว ๆ ของการรันเอเจนต์หนึ่งครั้ง นึกภาพได้แบบนี้:
ค่าใช้จ่าย ~ context ถาวร
           + ประวัติเซสชัน
           + ข้อมูลขาเข้า
           + คำอธิบายและ schema ของเครื่องมือ
           + ผลลัพธ์ของเครื่องมือ
           + คำตอบที่มองเห็น
           + reasoning ที่ซ่อนอยู่
           × จำนวนขั้นตอนของเอเจนต์
ตัวคูณสุดท้ายนี่แหละที่แสบที่สุด
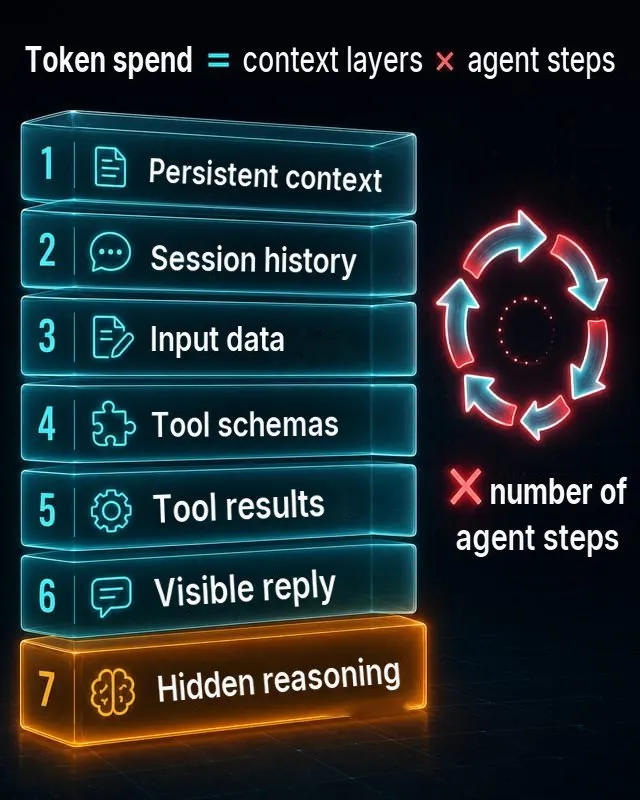
ถ้าคุณเพิ่ม 10,000 token เข้าไปในคำแนะนำถาวร ไม่ได้แปลว่าจะเสีย 10,000 token ต่องานเสมอไป ถ้าเอเจนต์ทำ 8–10 ขั้นตอน 10,000 token นี้อาจถูกประมวลผลซ้ำแล้วซ้ำอีก ในทางปฏิบัติ ไฟล์ใหญ่ “ที่ดูไม่มีพิษภัย” แค่ไฟล์เดียวใน context พื้นฐาน จะกลายเป็นค่าบริการประจำที่ต้องจ่ายทุกครั้งที่เอเจนต์ทำอะไรสักอย่าง
เอกสารทางการของ OpenAI แยก input, output, cached input และค่าใช้จ่ายของ tools ออกจากกันชัดเจน ส่วน tools ที่ติดมากับระบบก็อาจมีค่าใช้จ่ายเพิ่มสำหรับการเรียกใช้และเนื้อหาที่ป้อนให้โมเดลไปพร้อมกับคำขอ
token ที่มองไม่เห็น: ทำไมคำตอบสั้น ๆ ถึงแพงได้
ส่วนที่หลอกตาที่สุดของเศรษฐศาสตร์เอเจนต์คือ reasoning
ผู้ใช้เห็นแค่:
เรียบร้อย อัปเดต config ให้แล้วแต่ข้างใน โมเดลอาจใช้ token ไปเป็นพัน ๆ กับการวางแผน ตรวจทางเลือก วิเคราะห์ข้อผิดพลาด และเลือกขั้นต่อไป
ในเอกสารของ OpenAI อธิบายว่า reasoning tokens เป็น token แยกที่โมเดลใช้ “คิด” มองไม่เห็นผ่าน API แต่กินที่ใน context window และคิดเงินแบบ output tokens OpenAI ยังยกตัวอย่างว่าจาก output 1186 token มี 1024 token เป็น reasoning tokens
ฝั่ง Anthropic ก็ใช้ตรรกะคล้ายกันกับ extended thinking: thinking tokens คิดเงินแบบ output และจำนวน token ที่เห็นในคำตอบอาจไม่ตรงกับ billed output เอกสารเขียนไว้ตรง ๆ ว่าผู้ใช้จ่ายเงินสำหรับกระบวนการ thinking ทั้งหมด ไม่ใช่แค่บทสรุปที่มองเห็น
ข้อสรุปในทางปฏิบัติคือ:
“คำตอบสั้น” ไม่ได้แปลว่า “รันแล้วราคาถูก”
งานง่าย ๆ ควรตั้ง reasoning ต่ำหรือปิดไปเลย ถ้าแพลตฟอร์มให้ทำได้ ส่วนงานสถาปัตยกรรมซับซ้อน โค้ด การวางแผนย้ายระบบ หรือการกระทำที่อันตราย กลับกัน reasoning อาจคุ้มค่า แต่การเปิด thinking สูงสุดไว้สำหรับคำทักทาย การเตือนความจำ และการส่งต่อการแจ้งเตือน ก็เหมือนเรียก senior architect มาเซ็นการ์ดอวยพร
จริง ๆ แล้ว token ซ่อนอยู่ตรงไหน
1. context ถาวร
ก็คือ AGENTS.md, CLAUDE.md, SOUL.md, USER.md, TOOLS.md ไฟล์ memory คำแนะนำของโปรเจกต์ นโยบาย กฎการสื่อสาร และทุกอย่างที่เอเจนต์อ่านตอนเริ่ม
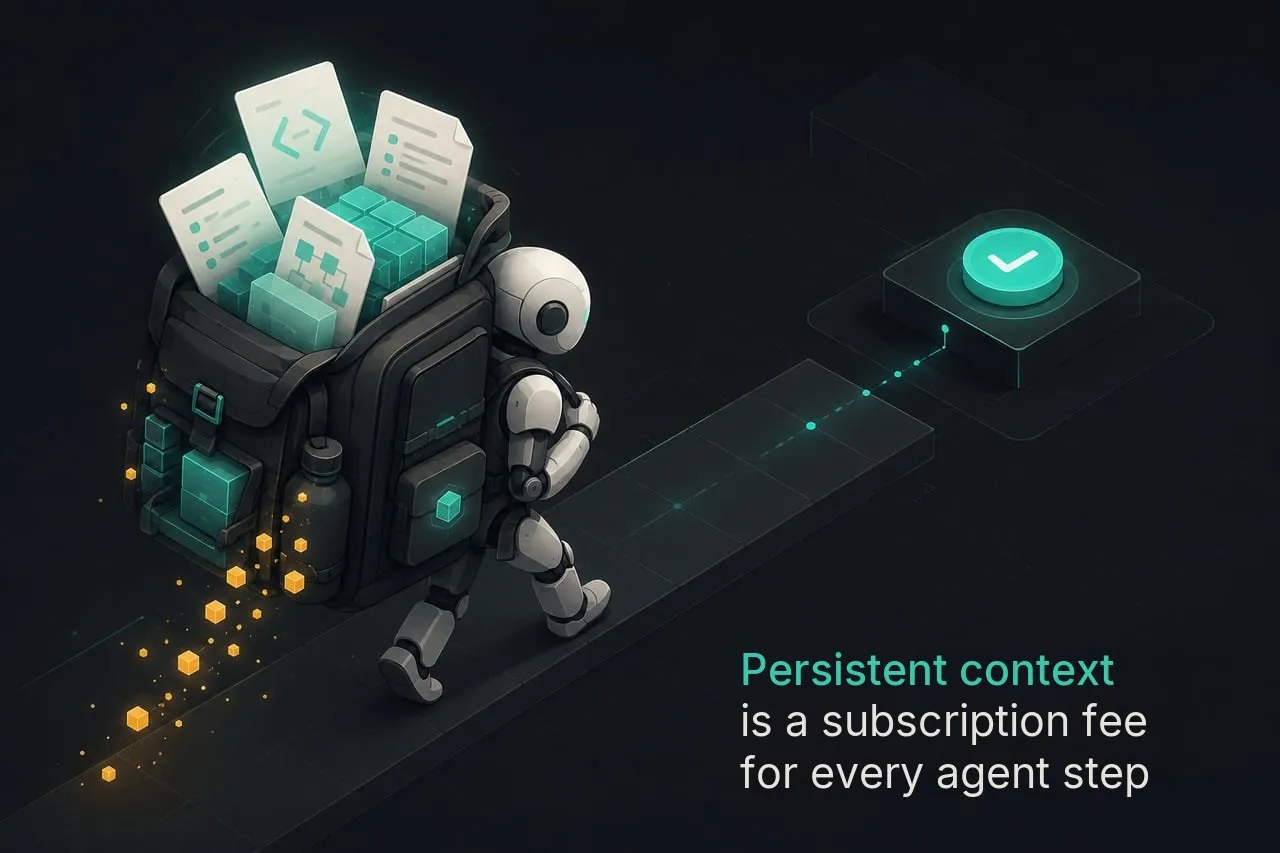
ปัญหาไม่ได้อยู่ที่ไฟล์พวกนี้มีอยู่ ปัญหาคือนานไปคนเริ่มยัดทุกอย่างลงไป:
- ประวัติส่วนตัวของผู้ใช้
- ประวัติของโปรเจกต์
- การตัดสินใจเก่า ๆ
- สไตล์การคุย
- edge case ทุกแบบ
- คำแนะนำสำหรับสถานการณ์ที่นาน ๆ เกิดที
- ตัวอย่าง
- โน้ต
- ข้อห้าม
- ข้อยกเว้นของข้อห้าม
- ข้อยกเว้นของข้อยกเว้น
ผ่านไปเดือนเดียว เอเจนต์ได้สารานุกรมทุกครั้งแทนคำแนะนำสั้น ๆ
กฎที่ดีคือ:
ใน context ถาวรควรมีแค่สิ่ง
ที่ต้องใช้เกือบทุกครั้งที่รัน
ที่เหลือทั้งหมดควรโหลดเมื่อต้องใช้
2. Tools และ MCP server
MCP คือมาตรฐานสำหรับเชื่อมแอป AI เข้ากับระบบภายนอก: ไฟล์ ฐานข้อมูล ปฏิทิน การค้นหา prompts และ workflows เฉพาะทาง ในคำอธิบายทางการ MCP ถูกเรียกว่า “พอร์ต USB-C สำหรับแอป AI”
ฟังดูดีมาก แต่เครื่องมือทุกตัวมีราคา
โมเดลจะใช้ tool ได้ ต้องรู้ว่า:
- เครื่องมือนี้คืออะไร
- ควรเรียกเมื่อไร
- รับพารามิเตอร์อะไรบ้าง
- จะคืนผลลัพธ์ในรูปแบบไหน
- การเรียกมีข้อจำกัดอะไร
ใน function calling ข้อมูลพวกนี้มักเขียนเป็น JSON schema OpenAI เขียนไว้ตรง ๆ ว่า function tools กำหนดด้วย schema และถ้ามีฟังก์ชันเยอะหรือ schema ใหญ่ ก็ควรใช้ tool search เพื่อให้ tools ที่ไม่ค่อยได้ใช้ถูกโหลดเฉพาะตอนที่จำเป็น
แปลว่าปัญหาไม่ได้อยู่แค่ตอนเรียกเครื่องมือ ปัญหาคือคุณยื่นเมนูเล่มใหญ่เกินไปให้โมเดลดูตั้งแต่แรก
ถ้างานนี้ต้องการแค่อ่านหน่วยความจำ ก็ไม่ต้องให้ Gmail, Calendar, browser, shell, Notion, GitHub, Jira, Linear, Figma และเครื่องมือค้นหาอีกสามตัวไปพร้อมกัน
3. ผลลัพธ์ของเครื่องมือ
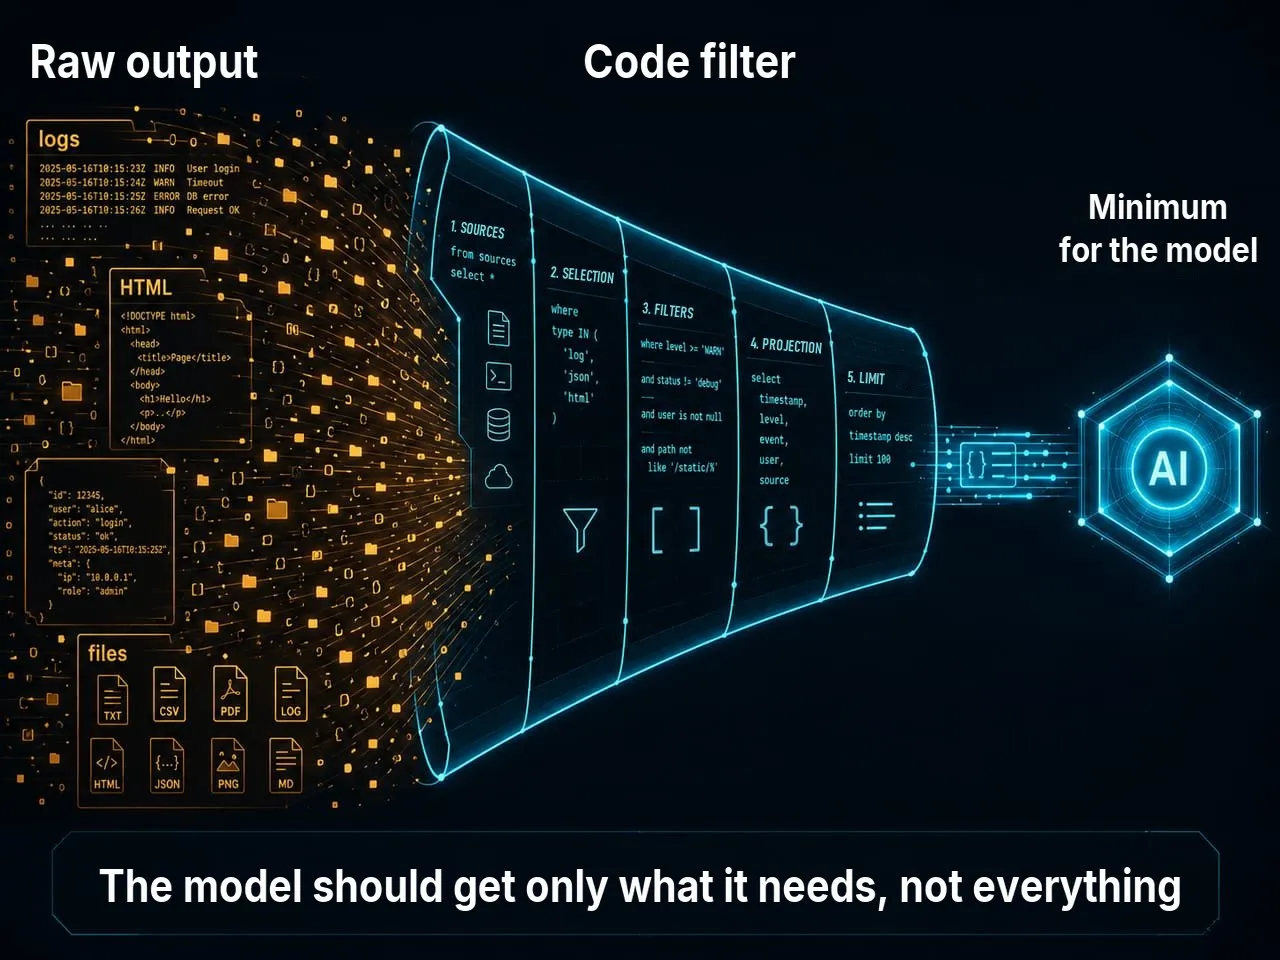
ที่แย่กว่านั้นคือตอนที่ tool คืนข้อมูลมาเยอะเกินไป
แบบที่ไม่ดี:
อ่าน log ทั้งหมด 80,000 บรรทัดแล้วหาข้อผิดพลาดแบบที่ดี:
สคริปต์กรอง ERROR/WARN ไว้ก่อน
เหลือ 100 บรรทัดรอบข้อผิดพลาดแรก
แล้วส่งแค่ส่วนนั้นให้โมเดล
Claude Code ในคำแนะนำเรื่องลดค่าใช้จ่ายเสนอตรง ๆ ให้ย้ายการเตรียมข้อมูลไปไว้ใน hooks และ skills: เช่น แทนที่จะให้ Claude อ่าน log 10,000 บรรทัด ให้รัน grep หาข้อผิดพลาดก่อน แล้วคืนมาแค่หลักร้อย token แทนหลักหมื่น
นี่คือหนึ่งในหลักที่ใช้ได้จริงที่สุด:
โมเดลไม่ควรได้ข้อมูลดิบ แต่ควรได้ข้อมูลขั้นต่ำที่เตรียมไว้แล้ว และพอสำหรับการแก้ปัญหา
4. ประวัติเซสชัน
เซสชันยาว ๆ สบายใจดี: “เอเจนต์จำได้หมด”
แต่ในทางเทคนิค เซสชันยาวคือหางที่ยาวขึ้นเรื่อย ๆ และเริ่มกินเงินทุกขั้นตอนใหม่ ถึงจุดหนึ่งคุณไม่ได้จ่ายเพื่องานตรงหน้า แต่จ่ายเพื่อประวัติการคุยทั้งเดือนที่ไม่ได้ใช้มานานแล้ว
Claude Code แนะนำตรง ๆ ให้ล้าง context เมื่อเปลี่ยนงาน: stale context เปลือง token ในทุกข้อความถัดไป
ความรู้ควรอยู่ในฐานความรู้ เอกสาร memory และ retrieval ส่วนเซสชันควรอยู่แค่เท่าที่งานปัจจุบันต้องการ
5. ซับเอเจนต์และระบบหลายเอเจนต์
ระบบหลายเอเจนต์ฟังดูเท่: ตัวหนึ่งเขียนโค้ด อีกตัวรีวิว ตัวที่สามหาข้อมูล ตัวที่สี่ทำโพสต์
แต่เอเจนต์แต่ละตัวคือ context แยกกัน
Anthropic เตือนไว้ตรง ๆ ในเอกสาร Claude Code ว่า agent teams รัน Claude Code หลายอินสแตนซ์ แต่ละตัวมี context window ของตัวเอง และ token usage จะเพิ่มตามจำนวน “เพื่อนร่วมทีม” ที่ทำงานอยู่
พูดอีกแบบคือ:
3 เอเจนต์ ≠ เอเจนต์ตัวเดียวที่ฉลาดขึ้น
3 เอเจนต์ = 3 context window + การประสานงาน + การส่งต่อผลลัพธ์
ระบบหลายเอเจนต์คุ้มเมื่องานแยกขาดจากกันจริง ๆ หรือต้องใช้ความเชี่ยวชาญต่างกัน ถ้าคุณแบ่งสามข้อในลิสต์เดียวกันให้เอเจนต์สามตัวแค่เพราะทำได้ ส่วนใหญ่คุณกำลังเอา token ไปซื้อความวุ่นวาย
6. Cron และงานเบื้องหลัง
Cron คือนักฆ่างบประมาณแบบเงียบ ๆ
ผู้ใช้หลับอยู่ แต่เอเจนต์ตื่นทุก 15 นาที โหลดหน่วยความจำ อ่าน tools เรียกโมเดลเรือธง ตรวจอะไรบางอย่าง เห็นว่าไม่มีอะไรเปลี่ยน แล้วก็หลับต่อ
ผ่านไปสัปดาห์เดียวถึงได้รู้ว่า ผู้ใช้ที่แพงที่สุดของเอเจนต์ไม่ใช่คุณ แต่เป็นตารางเวลา
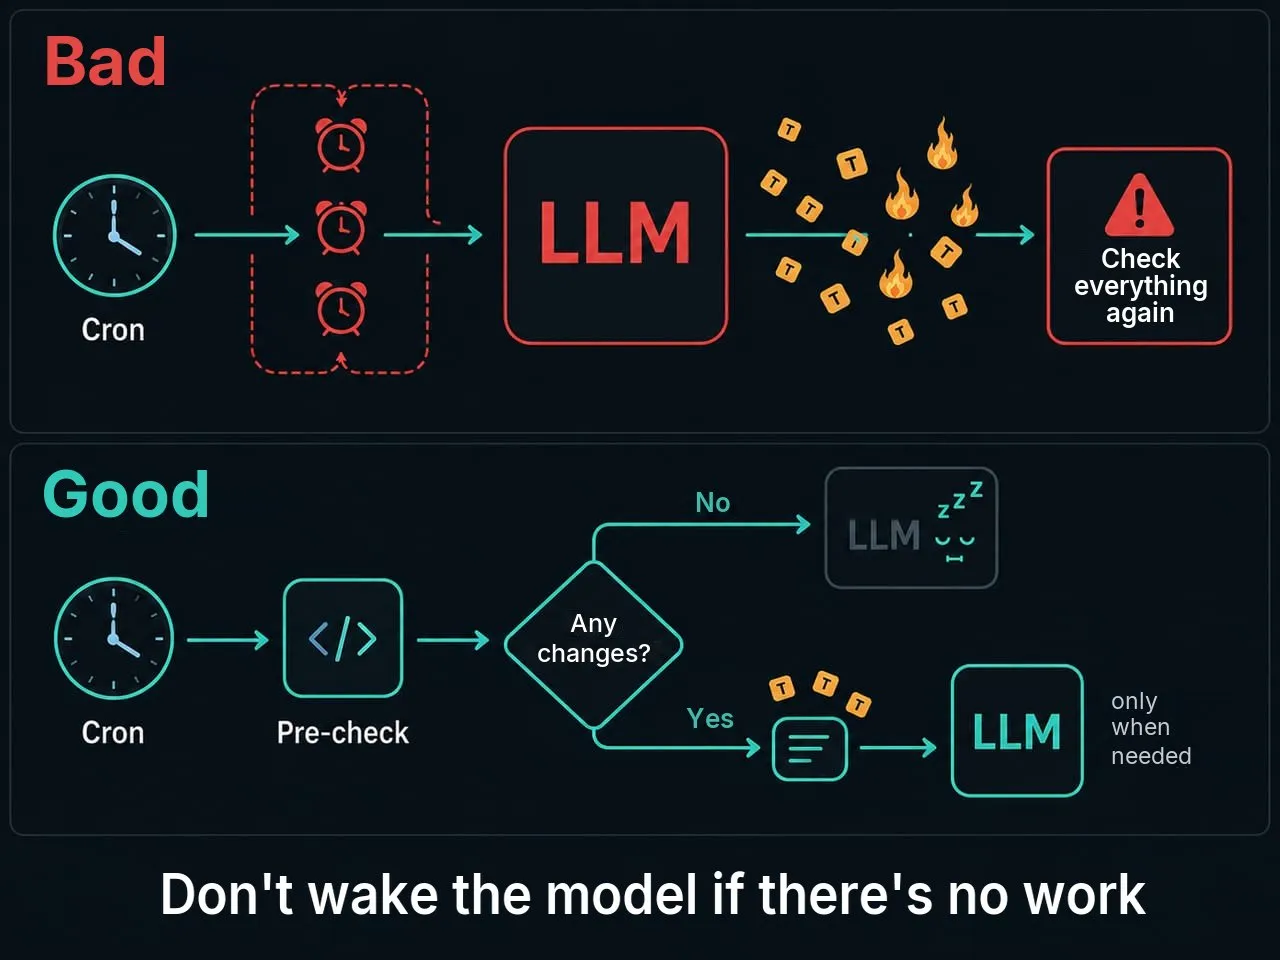
สถาปัตยกรรมที่ถูกต้องของงานเบื้องหลังหน้าตาแบบนี้:
cron -> pre-check ราคาถูก -> มีอะไรเปลี่ยนไหม? -> ใช่/ไม่ใช่ถ้าไม่มีอะไรเปลี่ยน ก็ไม่ต้องใช้ LLM เลย
บรรทัดที่คุ้มที่สุดในระบบอัตโนมัติ:
{ "wakeAgent": false }หลักสำคัญที่สุด: token ที่ราคาถูกที่สุดคือ token ที่ไม่ได้ส่ง
เปลี่ยนไปใช้โมเดลที่ราคาถูกกว่าได้
ลด reasoning ได้
เปิด caching ได้
ตัดคำตอบให้สั้นลงได้
แต่การประหยัดที่ได้ผลที่สุดเกือบทุกครั้งฟังดูง่ายกว่านั้น:
อย่าส่งสิ่งที่โมเดลไม่ต้องใช้ในขั้นตอนนี้ให้มัน
ใช้ได้กับทุกอย่าง:
- คำแนะนำ
- หน่วยความจำ
- tools
- schema
- log
- HTML
- ประวัติบทสนทนา
- ไฟล์แนบ
- ผลการค้นหา
- artifact ระหว่างทาง
ถ้ากรองข้อมูลด้วยโค้ดได้ ก็กรองด้วยโค้ด
ถ้าแก้งานด้วยเทมเพลตได้ ก็ใช้เทมเพลต
ถ้าเอกสารใหญ่ไม่ค่อยได้ใช้ ก็อย่าเก็บไว้ใน context พื้นฐาน
ถ้า skill ใช้แค่เดือนละครั้ง ก็ให้มันอยู่ใน references ไม่ใช่ใน AGENTS.md
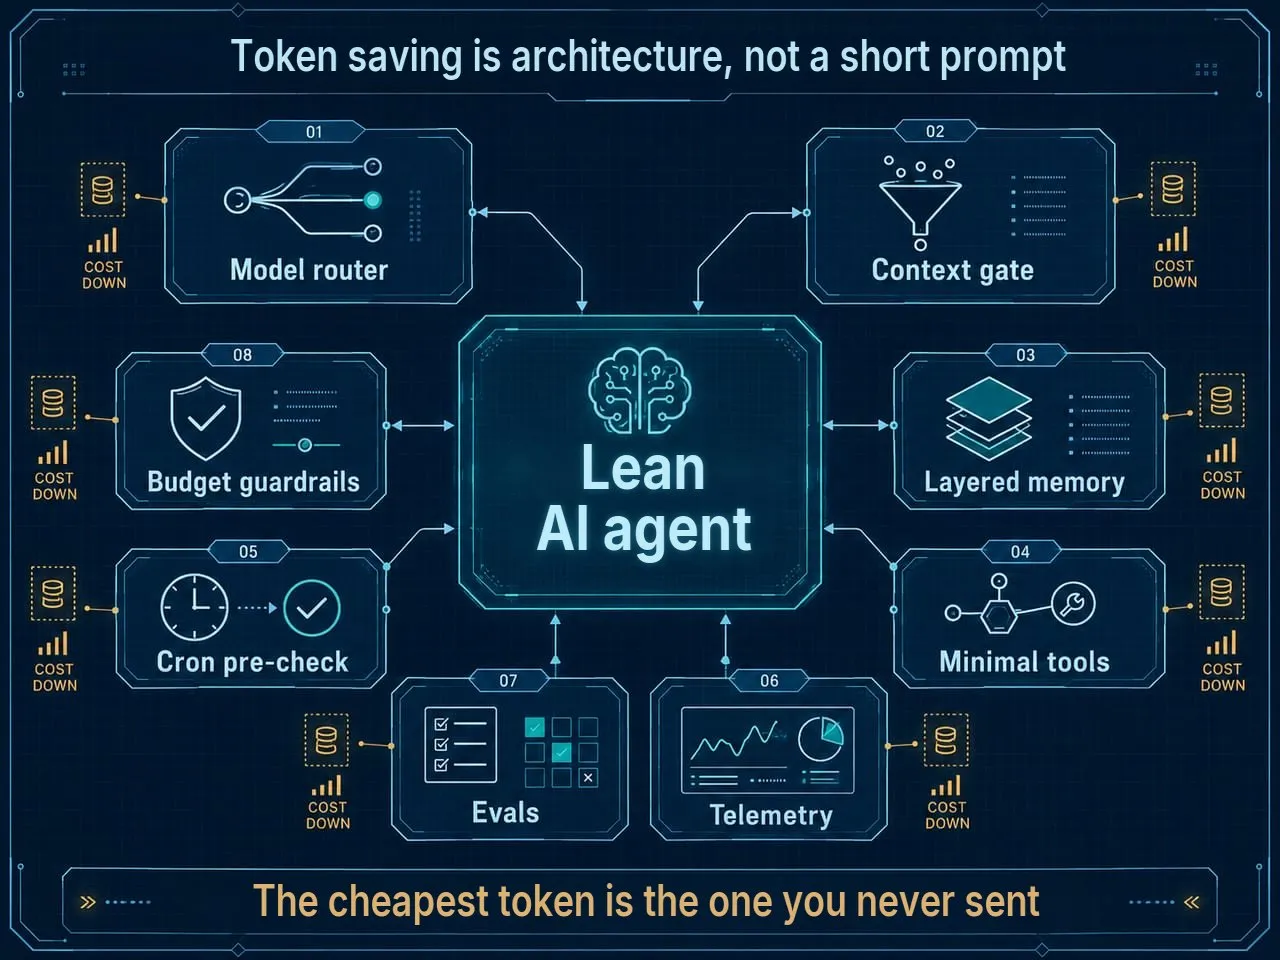
เช็กลิสต์ประหยัด token: 14 จุดที่ควรแก้ เรียงตามความคุ้ม
1. วัดก่อน แล้วค่อยตัด
อย่าเริ่มจาก “ตัด prompt ให้สั้นลง” ให้หาก่อนว่าอะไรแพงจริง
baseline ขั้นต่ำคือ 7 วัน
ดูแยกกันเป็นเรื่อง ๆ:
- เซสชันแบบโต้ตอบ
- cron และงานเบื้องหลัง
- tool calls
- input tokens
- output tokens
- reasoning/thinking tokens
- cache hit rate
- จำนวนขั้นตอนต่องาน
- ค่าใช้จ่ายของงานที่เสร็จแล้ว ไม่ใช่ของคำขอเดียว
ตารางที่มีประโยชน์:
| เมตริก | บอกอะไร |
|---|---|
| Input tokens / การรัน | context บวม ประวัติ tool output |
| Output + reasoning / การรัน | thinking มากเกินไปหรือคำตอบเยิ่นเย้อ |
| Tool calls / งาน | ค้นหาเกินจำเป็น routing ไม่ดี tools ที่ออกแบบมาไม่ดี |
| จำนวนคำขอ / งาน | วนลูป แผนไม่ดี ลองซ้ำ |
| Tokens / cron job | งานอัตโนมัติที่ถึงเวลาเปลี่ยนเป็นสคริปต์ |
| Cache hit rate | prefix ที่ซ้ำ ๆ นิ่งแค่ไหน |
ถ้าไม่มี baseline ก็ง่ายมากที่จะทุ่มเทตัด SOUL.md อย่างกล้าหาญทั้งสัปดาห์ แล้วมารู้ทีหลังว่า 70% ของค่าใช้จ่ายมาจากการมอนิเตอร์ตอนกลางคืน
2. อย่าใช้โมเดลเรือธงเป็นเครื่องประมวลผลครอบจักรวาล
โมเดลเรือธงจำเป็นสำหรับ:
- สถาปัตยกรรมซับซ้อน
- การตัดสินใจที่กำกวม
- โค้ดหนัก ๆ
- การสังเคราะห์จากหลายแหล่ง
- การกระทำที่มีความเสี่ยง
- งานที่ผิดแล้วเสียหายแพง
แต่ไม่จำเป็นต้องให้มัน:
- แยกอีเมลเป็นสามหมวด
- ดึงวันที่ออกจากข้อความ
- จัดรูปแบบ JSON
- เขียนข้อความเตือนแบบเดิม ๆ
- ตรวจว่ามีไฟล์ใหม่เข้ามาหรือยัง
- ส่งต่อการแจ้งเตือน
โมเดลราคาถูกก็ไม่ได้ดีกว่าเสมอไป ถ้ามันพลาดแล้วต้องเรียก tool เพิ่มอีกห้าครั้ง คำตอบดี ๆ ครั้งเดียวจากโมเดลเรือธงอาจราคาถูกกว่า
ให้มุ่งลดค่าใช้จ่ายของงานที่ทำเสร็จ ไม่ใช่ราคาต่อ token
3. ลด reasoning ที่ตั้งเป็นค่าเริ่มต้น
กฎพื้นฐาน:
low/medium — ค่าเริ่มต้น
high — เฉพาะเมื่อมีเหตุผลชัดเจน
งานทั่วไปในชีวิตประจำวัน การแจ้งเตือนสั้น ๆ การจัดหมวดหมู่ summaries ง่าย ๆ และคำตอบตามแบบฟอร์ม มักไม่ต้องใช้ thinking สูง
สำหรับงานซับซ้อน ให้ทำ eval:
- ชุดงานเดียวกัน
- reasoning หลายระดับ
- เทียบคุณภาพ
- เทียบข้อผิดพลาด
- เทียบ token
- เทียบเวลา
ถ้า high ให้คุณภาพเพิ่ม +2% แต่ค่าใช้จ่ายเพิ่ม +300% นั่นคือดีลที่แย่
4. เอา LLM ออกจากงานที่ผลลัพธ์ตายตัว
ถ้ารู้ผลลัพธ์ล่วงหน้าอยู่แล้ว ก็ไม่ต้องใช้โมเดล
แบบที่ไม่ดี:
cron -> โหลดเอเจนต์ -> โหลดหน่วยความจำ -> โหลด tools
     -> ขอให้เขียน "ได้เวลาดื่มน้ำแล้ว"
แบบที่ดี:
cron -> script-only -> ส่งข้อความสำเร็จรูปLLM จำเป็นในที่ที่มีความไม่แน่นอน:
- เข้าใจความหมาย
- เลือกว่าจะทำอะไร
- สังเคราะห์ข้อมูล
- อธิบาย
- ตัดสินใจ
- ปรับตัวตาม context
ถ้างานเป็นแค่วันที่ ตัวจับเวลา การจัดรูปแบบ health check หรือข้อความตายตัว นั่นคืองานของโค้ดธรรมดา
5. ลด context ถาวร
ตรวจไฟล์ทั้งหมดที่ถูกโหลดทุกครั้งที่รัน:
AGENTS.mdCLAUDE.mdSOUL.mdUSER.mdTOOLS.mdMEMORY.md- คำแนะนำ bootstrap
- กฎระดับโปรเจกต์ทั้งหมด
ถามคำถามเดียวกับทุกบล็อก:
อันนี้ต้องใช้เกือบทุกครั้งที่รันไหม?ถ้าไม่ ให้ย้ายไปเป็น reference แยก
โครงสร้างที่ดี:
AGENTS.md
  กฎภาพรวมสั้น ๆ
  แผนที่เอกสาร
  อ่านอะไรเมื่อไร

references/
  security.md
  sales-process.md
  content-style.md
  deployment-guide.md
  rare-edge-cases.md
AGENTS.md ไม่ควรเป็นสารานุกรม แต่ควรเป็นตัวนำทาง
6. เปลี่ยน skills ให้ใช้ progressive disclosure
Progressive disclosure คือการที่เอเจนต์เห็นคำอธิบายสั้น ๆ ของ skill ก่อน แล้วค่อยอ่านรายละเอียดเมื่อจำเป็น
skill ที่ไม่ดี:
SKILL.md ยาว 30 หน้า
ที่ใส่ทุกสถานการณ์ ตัวอย่าง ข้อยกเว้น และเทมเพลตไว้ในทีเดียว
skill ที่ดี:
skill/
├── SKILL.md              # ตัวแยกเส้นทางสั้น ๆ
├── references/
│   ├── interview.md      # เฉพาะงานสัมภาษณ์
│   ├── landing.md        # เฉพาะแลนดิ้งเพจ
│   ├── bugfix.md         # เฉพาะงานแก้บั๊ก
│   └── full-protocol.md  # โหมดเต็มที่นาน ๆ ใช้ที
└── scripts/
    └── preprocess.py
เอกสารทางการของ Claude Code แนะนำตรง ๆ ให้ย้ายคำแนะนำเฉพาะทางจาก CLAUDE.md ไปไว้ใน skills: CLAUDE.md ถูกโหลดตอนเริ่ม ส่วน skills ถูกโหลดเมื่อต้องใช้
7. เชื่อมเฉพาะเครื่องมือที่ต้องใช้
ไม่ต้องยื่น toolbox ทั้งกล่องให้เอเจนต์ทุกงาน
สำหรับงาน “หาในหน่วยความจำว่าเราตัดสินใจเรื่อง pricing ไว้ว่ายังไง” ไม่ต้องใช้:
- Gmail
- browser
- shell
- Calendar
- GitHub
- Notion
- Figma
- Sentry
- Stripe
ต้องใช้แค่ memory/retrieval และอาจมีเครื่องมือจัดการไฟล์อีกหนึ่งตัว
ตั้งชุดเครื่องมือขั้นต่ำไว้สำหรับงานแต่ละประเภท:
memory-only
research
coding
calendar
email-draft
browser-heavy
admin
ยิ่ง runtime มี tools น้อย schema ที่เป็นสัญญาณรบกวนก็ยิ่งน้อย และโอกาสที่เอเจนต์จะหยิบค้อนผิดอันก็ยิ่งน้อยลง
8. จำกัดผลลัพธ์ของเครื่องมือก่อนเข้าโมเดล
อย่าให้โมเดลทุกอย่าง
ให้แค่สิ่งที่กรองแล้ว
ตัวอย่าง:
แทนที่จะให้: HTML ทั้งหน้า
ให้แบบนี้ดีกว่า: title, h1, main text, links, meta, relevant snippets

แทนที่จะให้: log ทั้งไฟล์
ให้แบบนี้ดีกว่า: ข้อผิดพลาดแรก ๆ + 50 บรรทัดรอบ ๆ + 100 บรรทัดสุดท้าย

แทนที่จะให้: ทั้งรีโพ
ให้แบบนี้ดีกว่า: tree + 3 ไฟล์ที่เกี่ยวข้อง

แทนที่จะให้: อีเมลทั้งหมด
ให้แบบนี้ดีกว่า: อีเมลใหม่ 20 ฉบับ พร้อม sender, subject, date, snippet

แทนที่จะให้: JSON API ทั้งก้อน
ให้แบบนี้ดีกว่า: เฉพาะฟิลด์ที่เลือก
แบบนี้ประหยัดได้สองต่อ:
- input ในขั้นตอนนี้น้อยลง
- ขยะในประวัติเซสชันต่อจากนี้น้อยลง
9. จำกัดความยาวของลูปเอเจนต์
ตั้งลิมิตไว้:
max_turnsmax_tool_calls- ลิมิตการลองซ้ำ
- หยุดเมื่อเจอข้อผิดพลาดเดิม
- หยุดเมื่อเรียก tool แบบเดิมซ้ำ
- บังคับวางแผนใหม่หลังพลาด 2–3 ครั้ง
เอเจนต์ที่ไม่มีลิมิตก็เหมือนเด็กฝึกงานที่ได้บัตรเครดิตบริษัทไปพร้อมคำสั่งว่า “ไปจัดการมา”
เขาจัดการได้แน่ แต่บิลอาจทำให้คุณตกใจ
10. จัดการวงจรชีวิตของเซสชัน
เปิดเซสชันใหม่เมื่อเปลี่ยน:
- โปรเจกต์
- รีโพ
- หัวข้อ
- ลูกค้า
- ประเภทงาน
ใช้ compaction ได้ แต่อย่าใช้แบบเครื่องอัดขยะที่บดทุกอย่างจนเละ
เอกสารเรื่อง compaction ของ OpenAI อธิบายแนวทางที่แทนหน้าต่างยาว ๆ ด้วยสถานะแบบกะทัดรัด ซึ่งเก็บ prior state and reasoning ที่สำคัญไว้ด้วย token ที่น้อยกว่า
แต่ compaction ต้องคุมคุณภาพ หลังบีบอัดแล้ว ให้ตรวจว่ายังเหลือ:
- ข้อห้าม
- การตัดสินใจ
- งานที่ยังทำไม่เสร็จ
- constraints สำคัญ
- แผนปัจจุบัน
- แหล่งความจริง (source of truth)
compaction ที่แย่ช่วยประหยัด token แต่สร้างความผิดพลาดราคาแพง
11. แบ่งหน่วยความจำตามหน้าที่
หน่วยความจำไม่ได้เหมือนกันหมด
มีอยู่สี่ชั้น:
- Core memory สิ่งที่เอเจนต์ต้องรู้ตลอด
- Retrieval memory สิ่งที่ต้องค้นหาตามหัวข้อปัจจุบัน
- Session memory สิ่งที่สำคัญเฉพาะในงานปัจจุบัน
- Log memory บันทึกเหตุการณ์ที่นาน ๆ ใช้ที
สถาปัตยกรรมหน่วยความจำที่ไม่ดี:
ทุกอย่างอยู่ใน MEMORY.md ไฟล์เดียว
ที่ถูกโหลดทุกครั้ง
สถาปัตยกรรมที่ดี:
core.md          # สั้น ๆ เฉพาะเรื่องถาวร
projects/*.md    # แยกตามโปรเจกต์
people/*.md      # แยกตามคน
logs/YYYY-MM.md  # บันทึก
vectors/         # retrieval
คู่มืออ้างอิงเล่มใหญ่ไม่ควรถูกโหลดทุกครั้งที่รัน ควรถูกค้นหาเมื่อต้องใช้
12. ทำให้ cron ทำงานตามเหตุการณ์
Cron ควรตอบคำถามว่า:
มีงานใหม่ไหม?แล้วค่อยปลุกเอเจนต์
แบบที่ไม่ดี:
ทุก 15 นาที -> LLM -> ตรวจทุกอย่างใหม่หมดแบบที่ดี:
ทุก 15 นาที -> script pre-check
ถ้าไม่มีอะไรเปลี่ยน -> หลับต่อ
ถ้ามีอะไรเปลี่ยน -> ชุดข้อมูลสั้น ๆ -> LLM
สำหรับการมอนิเตอร์ ข่าว อีเมล งาน log และราคา เรื่องนี้สำคัญมาก
13. ขอ output ที่สั้นและตรวจสอบได้
ระบบอัตโนมัติไม่ต้องการนิยายสวย ๆ
ต้องการผลลัพธ์กะทัดรัด:
{
  "status": "needs_attention",
  "reason": "3 new invoices over budget",
  "next_action": "ask_user"
}
กำหนดรูปแบบคำตอบ:
- ความยาวสูงสุด
- JSON สำหรับระบบอัตโนมัติ
- bullet summary สำหรับคน
- artifact แยกเฉพาะเมื่อขอ
- ไม่มีบทนำ
- ไม่เล่าซ้ำสิ่งที่ป้อนเข้าไป
- ไม่มี “นี่คือสิ่งที่ผมทำ” ถ้าไม่จำเป็น
Output มักแพงกว่า input ความกระชับจึงไม่ใช่เรื่องสไตล์ แต่เป็นนโยบายงบประมาณ
14. ล็อกการประหยัดไว้ด้วย evals และงบประมาณ
การปรับแต่งโดยไม่มี evals กลายเป็นการหลอกตัวเองได้ง่ายมาก
หลังแก้แล้ว ให้ตรวจว่า:
- token ลดลงไหม
- ข้อผิดพลาดเพิ่มขึ้นไหม
- ต้องรันซ้ำบ่อยขึ้นไหม
- ผู้ใช้ต้องแก้งานของเอเจนต์บ่อยขึ้นไหม
- คุณภาพผลลัพธ์แย่ลงไหม
เมตริกหลัก:
ค่าใช้จ่ายของงานที่ทำเสร็จได้อย่างน่าเชื่อถือไม่ใช่ค่าใช้จ่ายของคำขอเดียว
บนแพลตฟอร์มต่าง ๆ หน้าตาเป็นยังไง
OpenClaw
OpenClaw อ่อนไหวกับสถาปัตยกรรม context เป็นพิเศษ เพราะมันอยู่ในฐานะเอเจนต์ถาวร: channels, skills, memory, hooks, cron, browser, workspace
ตรวจเรื่องเหล่านี้ก่อน:
- ไฟล์ bootstrap ไหนถูกโหลดตลอด
AGENTS.md,SOUL.md,USER.md,TOOLS.mdบวมแค่ไหน- เอเจนต์มองเห็น skills กี่ตัว
- MCP/tools ไหนเชื่อมไว้เป็นค่าเริ่มต้น
- tools คืนอะไรกลับมา
- ตั้งค่า cron jobs ไว้ยังไง
- มี sandbox และ allowlist/denylist สำหรับเครื่องมืออันตรายไหม
บทความเกี่ยวกับ OpenClaw เน้นบทบาทของ memory, compaction, hooks และ sandbox แยกไว้ต่างหาก: เมื่อบทสนทนายาว เอเจนต์จะบีบอัด context และเขียนเรื่องสำคัญลง memory ส่วน sandbox มีไว้เพื่อไม่ให้เซสชันกลุ่มเข้าถึงระบบในแบบที่อันตราย
กลยุทธ์ที่ดีสำหรับ OpenClaw คือ:
1 เอเจนต์ ≠ ทั้งโลก
1 เอเจนต์ = บทบาทชัดเจน + tools ขั้นต่ำ + หน่วยความจำสั้น ๆ + workflows ที่เข้าใจได้
Claude Code
Claude Code มีกลไกประหยัดในตัวอยู่แล้ว: prompt caching, auto-compaction, /usage, /clear, การตั้งค่าโมเดล และการจัดการ MCP
Anthropic เขียนไว้ตรง ๆ ว่า token costs scale with context size คือยิ่ง context ใหญ่ token ก็ยิ่งเยอะ Claude Code ลดค่าใช้จ่ายด้วย prompt caching และ auto-compaction แต่นักพัฒนาก็ยังต้องรักษา context ให้เล็กอยู่ดี
ชุดคำสั่งที่ใช้จริง:
/usage        # ดูการใช้ token
/clear        # ล้าง context เมื่อเปลี่ยนงาน
/compact      # บีบอัด พร้อมบอกว่าต้องเก็บอะไรไว้
/model        # เปลี่ยนโมเดลตามความยากของงาน
/mcp          # ปิด server ที่ไม่จำเป็น
และที่สำคัญที่สุด: อย่าทำให้ CLAUDE.md กลายเป็นคัมภีร์ระเบียบบริษัท
Codex
สำหรับ Codex ตรรกะก็คล้ายกัน:
AGENTS.mdระดับราก มีแค่กฎภาพรวม- คำแนะนำเฉพาะจุด วางไว้ข้างโมดูล
- กระบวนการที่ทำซ้ำ อยู่ใน skills
- ระเบียบยาว ๆ อยู่ใน references
- งานใหม่ = เซสชันใหม่ที่โฟกัสเรื่องเดียว
- tools และ connector ใส่เฉพาะเมื่อต้องใช้
Codex ได้ประโยชน์มากเป็นพิเศษจาก context สั้นและโครงสร้างรีโพที่เข้าใจง่าย เช่นเดียวกับ Claude Code ยิ่งเอเจนต์ต้อง “สำรวจโลก” น้อยเท่าไร ก็ยิ่งเผา token ไปกับการลาดตระเวนหาข้อมูลน้อยเท่านั้น
Hermes
ใน Hermes ผู้ช่วยประจำครอบครัว และเอเจนต์บน Telegram/Discord แหล่งค่าใช้จ่ายหลักมักไม่ใช่การเขียนโค้ด แต่เป็นระบบอัตโนมัติในชีวิตประจำวัน
ชุดการปรับแต่งที่เจอบ่อย:
- ลด reasoning ที่เป็นค่าเริ่มต้นลงเหลือ medium/low
- เปลี่ยนการเตือนง่าย ๆ ไปเป็น script-only
- ใส่ pre-check ให้ cron
- แยก context ของบทสนทนาออกจากระบบอัตโนมัติเบื้องหลัง
- จำกัด tool output
- ทำ
SOUL.mdให้สั้น - ย้ายคำแนะนำที่นาน ๆ ใช้ทีไปไว้ใน references
- ตั้งลิมิต turns/tool calls
- เพิ่มงบประมาณและ telemetry
ผู้ช่วยประจำครอบครัวคุยได้ “อบอุ่น” ก็จริง แต่ไม่ได้แปลว่าการเตือนเรื่องโรงเรียนทุกครั้งต้องโหลดประวัติครอบครัวทั้งหมดและโมเดลเรือธงขึ้นมาด้วย
ตรวจด่วนใน 30 นาที
ถ้าคุณมีเอเจนต์อยู่แล้วและอยากรู้เร็ว ๆ ว่ามันกิน token ตรงไหน ให้ไล่ตามลำดับนี้
ขั้นที่ 1. หาสองสถานการณ์ที่แพงที่สุด
ปกติจะเป็น:
- สถานการณ์แบบโต้ตอบหนึ่งอย่าง
- สถานการณ์ cron/automation หนึ่งอย่าง
อย่ากระจายไปทำทุกอย่างพร้อมกัน
ขั้นที่ 2. ตรวจ reasoning
ถามว่า:
งานนี้ต้องใช้ reasoning ลึก ๆ จริงไหม?ถ้าไม่ ก็ลดลง
ขั้นที่ 3. ตรวจ context ถาวร
เปิดดู:
AGENTS.mdCLAUDE.mdSOUL.md- memory
- skills
ลบส่วนที่ซ้ำ ย้ายเรื่องที่นาน ๆ ใช้ทีไปไว้ใน references ตัดตัวอย่างให้สั้นลง
ขั้นที่ 4. ตรวจ tools
สำหรับสถานการณ์ที่เลือก ให้เขียนออกมาว่า:
tools ไหนต้องใช้จริง?
ตัวไหนแค่เชื่อมค้างไว้ตั้งแต่สมัยก่อน?
ปิดทุกอย่างที่เกิน
ขั้นที่ 5. ตรวจ tool output
ถ้า tool คืนข้อมูลมาเป็นพรืด ให้ตั้งลิมิต:
- จำนวนบรรทัด
- จำนวนตัวอักษร
- ฟิลด์
- จำนวนผลลัพธ์
- เวลา
- ขนาดไฟล์
- ความลึกของการค้นหา
ขั้นที่ 6. ตรวจ cron
cron ทุกตัวต้องมี pre-check:
มีอะไรเปลี่ยนไปตั้งแต่รันครั้งก่อนไหม?ถ้าไม่มี ก็ไม่ต้องปลุกโมเดล
ขั้นที่ 7. ตรวจคุณภาพหลังประหยัด
ผ่านไปหนึ่งสัปดาห์ ให้เทียบ:
- token
- ข้อผิดพลาด
- การรันซ้ำ
- การแก้ด้วยมือ
- เวลาที่ใช้
- ค่าใช้จ่ายของงานที่เสร็จแล้ว
สูตรสุดท้ายของเอเจนต์ที่ประหยัด
เอเจนต์ที่ประหยัดไม่จำเป็นต้องตัวเล็กและไม่จำเป็นต้องโง่
มันคือเอเจนต์ที่:
- เรียกโมเดลเก่ง ๆ เฉพาะตอนที่คุ้ม
- reasoning เหมาะกับความยากของงาน
- context ถาวรสั้น
- skills โหลดเมื่อต้องใช้
- เชื่อม tools ให้น้อยที่สุด
- กรองผลลัพธ์ของเครื่องมือก่อนถึงโมเดล
- งานที่ผลลัพธ์ตายตัวให้โค้ดทำ
- cron ปลุก LLM เฉพาะเมื่อมีอะไรเปลี่ยน
- ลูปมีลิมิต
- หน่วยความจำแบ่งเป็นชั้น
- compaction ถูกตรวจสอบ
- วัดคุณภาพและค่าใช้จ่ายไปพร้อมกัน
ในระบบเอเจนต์ token ไม่ได้ถูกใช้ไปแค่กับตัวข้อความ
สถาปัตยกรรมต่างหากที่ใช้มัน
ดังนั้นคำถามหลักไม่ใช่:
จะขอให้เอเจนต์ตอบสั้นลงยังไง?แต่คือ:
ในสิ่งที่ส่งให้โมเดล อะไรจำเป็นจริง ๆ สำหรับขั้นตอนนี้?ถ้าถามคำถามนี้กับทุกไฟล์ ทุก tool, skill, cron, MCP server และทุกลูปของเอเจนต์ ค่าใช้จ่ายจะเริ่มลดลง โดยไม่ต้องเปลี่ยนผู้ช่วยที่มีประโยชน์ให้กลายเป็นแชตบอตราคาถูกที่ช่วยอะไรไม่ได้
token ที่ราคาถูกที่สุดไม่ใช่ token ที่โมเดลตัวเล็กประมวลผล
token ที่ราคาถูกที่สุดคือ token ที่คุณไม่ได้ส่งไปเลย
ค่าใช้จ่ายเกินจำเป็นมักโผล่ตรงไหน
ปกติ token ไม่ได้หายไปกับคำขอยาว ๆ ครั้งเดียว แต่หายไปกับการส่งประวัติซ้ำ log ที่ละเอียดเกินไป และผลลัพธ์ของเครื่องมือที่ไม่ได้ผ่านการกรอง ให้ลด context และตัดส่วนที่ซ้ำก่อน จากนั้นค่อยเลือกโมเดล และหลังจากนั้นถึงค่อยเทียบราคาแพ็กเกจ



